


Pandas中transform函数的核心用法与实战解析

本文深入解析Pandas库中transform函数的核心机制,阐述其如何在保持数据形状不变的前提下进行统计变换。通过Series、DataFrame及GroupBy分组场景下的具体代码示例,对比transform与agg的差异,演示对数化、标准化及多列配置等实战技巧,帮助开发者高效处理明细数据。
Pandas中transform函数的核心价值在于,它既能执行统计计算,又能保留原始数据的明细结构。为了更清晰地理解transform与agg的区别,下文将结合具体应用场景进行对比分析。
aggregation操作会返回缩减后的数据结果,而transformation则返回经过变换的完整数据,便于后续重组。这种变换的一个典型例子是减去分组平均值以实现数据居中,其输出数据的形状与输入完全一致。
#数据构造
data = pd.DataFrame(
{"company":['百度', '阿里', '百度', '阿里', '百度', '腾讯', '腾讯', '阿里', '腾讯', '阿里'],
"salary":[43000, 24000, 40000, 39000, 8000, 47000, 25000, 16000, 21000, 38000],
"age":[25, 34, 49, 42, 28, 23, 45, 21, 34, 29]})
data
  company  salary  age
0      百度   43000   25
1      阿里   24000   34
2      百度   40000   49
3      阿里   39000   42
4      百度    8000   28
5      腾讯   47000   23
6      腾讯   25000   45
7      阿里   16000   21
8      腾讯   21000   34
9      阿里   38000   29
1、transform作用于Series
1)单个变换函数
当transform作用于单列Series时,操作相对简单。以salary列为例,我们可以传入任意非聚合类函数进行变换,例如对工资列进行对数化处理。
import pandas as pd
import numpy  as np
# 对工资对数化
data['salary'].transform(np.log)
0    10.668955
1    10.085809
2    10.596635
3    10.571317
4     8.987197
5    10.757903
6    10.126631
7     9.680344
8     9.952278
9    10.545341
Name: salary, dtype: float64
除了使用内置函数,还可以传入lambda函数进行自定义计算。
# lambda函数
data['salary'].transform(lambda s: s+1)
0    43001
1    24001
2    40001
3    39001
4     8001
5    47001
6    25001
7    16001
8    21001
9    38001
Name: salary, dtype: int64
2)多个变换函数
通过传入包含多个变换函数的列表,可以一次性计算出多列结果:
data['salary'].transform([np.log, lambda s: s+1, np.sqrt])
   log  <lambda>        sqrt
0  10.668955     43001  207.364414
1  10.085809     24001  154.919334
2  10.596635     40001  200.000000
3  10.571317     39001  197.484177
4   8.987197      8001   89.442719
5  10.757903     47001  216.794834
6  10.126631     25001  158.113883
7   9.680344     16001  126.491106
8   9.952278     21001  144.913767
9  10.545341     38001  194.935887
由于transform传入的函数在执行运算时接收的是对应的整列数据,我们可以利用这一特性实现依赖样本整体统计特征的变换过程,例如数据标准化或归一化:
# 利用transform进行数据标准化
data['salary'].transform(lambda s: (s - s.mean()) / s.std())
0    0.991038
1   -0.468630
2    0.760564
3    0.683739
4   -1.697825
5    1.298337
6   -0.391806
7   -1.083228
8   -0.699104
9    0.606915
Name: salary, dtype: float64
2、 transform作用于DataFrame
当transform作用于整个DataFrame时,实际上是将传入的所有变换函数分别应用到每一列中:
data.loc[:,'salary':'age'].transform(lambda s:(s-s.mean()) /s.std())
     salary       age
0  0.991038 -0.832050
1 -0.468630  0.104006
2  0.760564  1.664101
3  0.683739  0.936057
4 -1.697825 -0.520031
5  1.298337 -1.040063
6 -0.391806  1.248075
7 -1.083228 -1.248075
8 -0.699104  0.104006
9  0.606915 -0.416025
当传入多个变换函数时,返回结果的格式类似于agg中的机制,会生成带有MultiIndex格式的字段名。
data.loc[:, 'salary': 'age'].transform([np.log, lambda s: s+1])
  salary                age
         log <lambda>       log <lambda>
0  10.668955    43001  3.218876       26
1  10.085809    24001  3.526361       35
2  10.596635    40001  3.891820       50
3  10.571317    39001  3.737670       43
4   8.987197     8001  3.332205       29
5  10.757903    47001  3.135494       24
6  10.126631    25001  3.806662       46
7   9.680344    16001  3.044522       22
8   9.952278    21001  3.526361       35
9  10.545341    38001  3.367296       30
此外,由于作用对象是DataFrame,还可以利用字典以键值对的形式,为每一列配置单个或多个变换函数:
(data.loc[:, 'salary': 'age']
.transform({'age': lambda s: (s - s.mean()) / s.std(),
                'salary': [np.log, np.sqrt]}))
   age     salary
   <lambda>        log        sqrt
0 -0.832050  10.668955  207.364414
1  0.104006  10.085809  154.919334
2  1.664101  10.596635  200.000000
3  0.936057  10.571317  197.484177
4 -0.520031   8.987197   89.442719
5 -1.040063  10.757903  216.794834
6  1.248075  10.126631  158.113883
7 -1.248075   9.680344  126.491106
8  0.104006   9.952278  144.913767
9 -0.416025  10.545341  194.935887
3、transform作用于groupby分组后
在之前的数据中,我们已经了解了如何计算不同公司的平均薪水。如果需要在原数据集中新增一列salary_mean,代表该公司所有员工的平均薪水,该如何实现呢?
data['salary_mean'] = data.groupby('company')[['salary']].transform('mean')
data
  company  salary  age   salary_mean
0      百度   43000   25  30333.333333
1      阿里   24000   34  29250.000000
2      百度   40000   49  30333.333333
3      阿里   39000   42  29250.000000
4      百度    8000   28  30333.333333
5      腾讯   47000   23  31000.000000
6      腾讯   25000   45  31000.000000
7      阿里   16000   21  29250.000000
8      腾讯   21000   34  31000.000000
9      阿里   38000   29  29250.000000
从上述数据可以看出,利用transform输出既得到了统计数据,又保持了原始数据的形状不变。
当然,也可以对多个数据列同时进行计算。
data.groupby('company')[['salary', 'age']].transform('mean')
         salary   age
0  30333.333333  34.0
1  29250.000000  31.5
2  30333.333333  34.0
3  29250.000000  31.5
4  30333.333333  34.0
5  31000.000000  34.0
6  31000.000000  34.0
7  29250.000000  31.5
8  31000.000000  34.0
9  29250.000000  31.5
我们也可以用map函数实现类似的功能,虽然步骤稍显复杂,但这有助于深入理解transform的含义。
avg_dict = data.groupby('company')['salary'].mean().to_dict()
avg_dict#得到了一个平均工资的字典
{'百度': 30333.333333333332, '腾讯': 31000.0, '阿里': 29250.0}
#利用map函数,将得到的字典映射到对应的列
data['salary_mean'] = data['company'].map(avg_dict)
data
company  salary  age   salary_mean
0      百度   43000   25  30333.333333
1      阿里   24000   34  29250.000000
2      百度   40000   49  30333.333333
3      阿里   39000   42  29250.000000
4      百度    8000   28  30333.333333
5      腾讯   47000   23  31000.000000
6      腾讯   25000   45  31000.000000
7      阿里   16000   21  29250.000000
8      腾讯   21000   34  31000.000000
9      阿里   38000   29  29250.000000
以图解方式来看看进行groupby后transform的实现过程(公司列包含ABC,salary列为每个员工的工资明细):
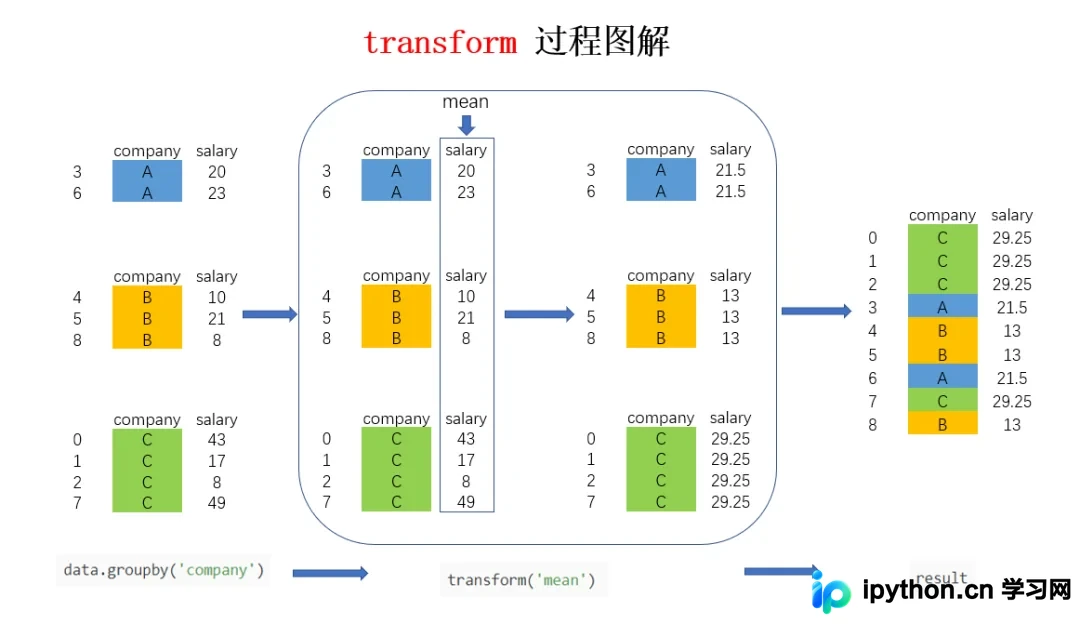
上图中大方框展示了transform和agg的关键区别。对于agg而言,会计算并聚合得到A、B、C公司对应的均值并直接返回,每个公司仅一条数据;而对transform而言,则会对每一条数据求得相应结果,同一组内的样本会有相同的值,组内求完均值后会按照原索引的顺序返回结果。
以上就是分享Pandas中的一些宝藏函数transform()的详细内容,更多关于Pandas函数transform()的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















