


Python爬虫实战与未来技术趋势解析

本文介绍基于Python3和Windows环境的爬虫开发基础,涵盖Anaconda与Jupyter工具使用。详细解析Robots协议规范、动态页面处理及反爬策略。同时展望Python在数据分析、人工智能、运维自动化及Web开发领域的核心应用与实战价值。
- 运行环境配置为Python3版本,操作系统平台为Windows。
- 推荐使用的开发工具组合为Anaconda集成环境,配合Jupyter Notebook或VS Code进行代码编写与调试。
- 预期学习成果包括掌握以下核心技能:
1. 理解爬虫基本原理及Robots协议规范。
2. 熟练使用浏览器开发者工具进行网络请求分析。
3. 掌握动态加载页面的数据抓取方法。
4. 了解手机客户端页面的数据采集技术。
Robots.txt 协议
Robots协议,通常被称为爬虫协议。
网站通过该协议向搜索引擎告知哪些页面允许抓取,哪些页面禁止抓取。Robots是一个协议标准,而非具体命令。Robots.txt文件是一个纯文本文件,需放置在网站根目录下,可使用任意常见文本编辑器创建和编辑。它是搜索引擎蜘蛛程序访问网站时首先检查的文件,主要作用是指示服务器上哪些文件可被查看。Robots协议是国际互联网界通行的道德规范,属于约定俗成的行为准则。
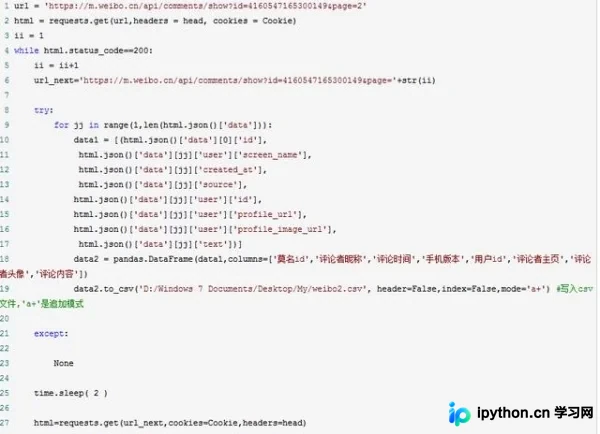
Python代码示例
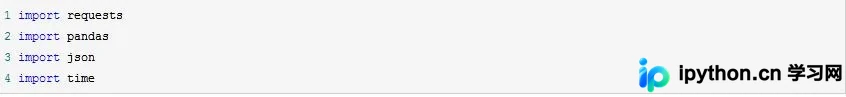
- 导入所需模块
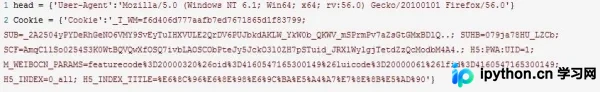
- 反爬机制应对
Python技术发展方向
数据分析与数据挖掘领域
主要技术包括关联分析(如经典的啤酒与尿布案例)、聚类分析、判别分析以及随机森林算法。
人工智能领域
指能够以类似人类智能方式做出反应的智能机器。该领域研究涵盖机器人技术、语音识别、图像识别及自然语言处理等方向。典型代表案例包括AlphaGo及其进阶版本AlphaGo Zero。
Python在运维领域的应用
不具备自动化开发能力的运维人员未来可能面临被淘汰的风险。
Web开发领域
用于开发网站应用,例如豆瓣网。该方向侧重于实际项目操作与实战经验积累。
Python爬虫技术
用于采集网络数据,为数据分析或大数据处理提供支持。大型互联网公司如Google、百度等均广泛应用此技术。该方向同样侧重于实战操作。
以上即为实现Python爬取门户论坛评论过程的详细内容,更多关于Python爬取门户论坛评论的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















