


基于pandas的会员数据清洗实战:从缺失值到重复记录处理

本文详细讲解利用pandas进行会员数据清洗的完整流程。内容涵盖完整性检查(缺失值均值/众数填充、空行删除)、全面性处理(单位统一换算)、合法性校验(非ASCII字符过滤)及唯一性保障(字段拆分与重复记录移除)。通过具体代码示例,展示如何高效清理服装店会员数据,确保数据质量。
我们拥有以下数据,并计划利用其进行基础的数据分析工作。
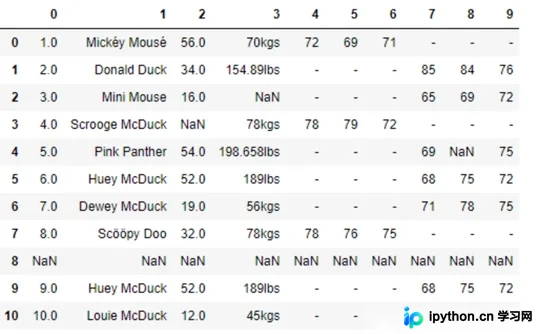
这份数据来自一家服装店的会员统计记录。表格顶部为列标题,左侧第一列为行索引。具体列定义如下:第0列为序号,第1列为会员姓名,第2列为年龄,第3列为体重;第4至6列记录男性会员的三围尺寸,而第7至9列则对应女性会员的三围尺寸。
我们将数据清洗的核心规则归纳为“完全合一”原则,主要包含以下四个关键维度:
- 完整性:检查单条数据是否存在空值,以及统计所需的字段是否完整无缺。
- 全面性:审视整列数值分布。例如在Excel中选中一列可查看其平均值、最大值和最小值。结合常识判断该列是否存在异常,包括数据定义错误、单位标识混乱或数值本身不合理等情况。
- 合法性:验证数据的类型、内容及取值范围是否符合规范。例如,数据中若包含非ASCII字符,性别字段出现“未知”状态,或年龄数值超过150岁等,均属于不合法数据。
- 唯一性:排查数据中是否存在重复记录。由于数据往往汇总自不同渠道,重复现象十分常见。因此,行数据与列数据均需保持唯一性,即同一人不能有多条重复记录,且个人的体重等指标也不应在列指标中重复出现。
1、完整性
1.1 缺失值
通常情况下,由于数据体量庞大,在采集过程中难免出现部分数据单元未被捕获的情况,导致数据缺失。面对此类问题,通常可采用以下三种处理策略:
- 删除:直接移除包含缺失值的记录。
- 均值填充:使用该列数据的平均值进行填补。
- 高频值填充:使用该列中出现频率最高的数据进行填补。
例如,若希望使用平均年龄来填充data[‘Age']中的缺失值,可编写如下代码:
df['Age'].fillna(df['Age'].mean(), inplace=True)
若选择使用最高频数据进行填充,可先通过value_counts获取Age字段中出现次数最多的值age_maxf,随后利用该值对Age字段中的缺失数据进行填充:
age_maxf = train_features['Age'].value_counts().index[0]
train_features['Age'].fillna(age_maxf, inplace=True)
1.2 空行
我们发现数据中存在一个空行,除index外,其余所有值均为NaN。由于Pandas的read_csv()函数没有直接忽略空行的可选参数,因此需要在数据读取后使用dropna()方法进行处理,以删除这些空行。
# 删除全空的行
df.dropna(how='all',inplace=True)
2、全面性
列数据单位不统一
若某一列数据的单位不统一,例如weight列中,部分数据单位为千克(Kgs),另一部分为磅(Lbs)。此处我们统一采用千克作为度量单位,并将磅转换为千克:
# 获取 weight 数据列中单位为 lbs 的数据
rows_with_lbs = df['weight'].str.contains('lbs').fillna(False)
print df[rows_with_lbs]
# 将 lbs转换为 kgs, 2.2lbs=1kgs
for i,lbs_row in df[rows_with_lbs].iterrows():
  # 截取从头开始到倒数第三个字符之前,即去掉lbs。
  weight = int(float(lbs_row['weight'][:-3])/2.2)
  df.at[i,'weight'] = '{}kgs'.format(weight)
3、合理性
非ASCII字符
假设数据集中Firstname和Lastname字段包含一些非ASCII字符。我们可以通过删除或替换的方式解决此问题,此处采用删除方法,即利用replace函数实现:
# 删除非 ASCII 字符
df['first_name'].replace({r'[^\x00-\x7F]+':''}, regex=True, inplace=True)
df['last_name'].replace({r'[^\x00-\x7F]+':''}, regex=True, inplace=True)
4、唯一性
4.1 一列包含多个参数
假设Name字段同时包含了Firstname和Lastname两个参数。为了达到数据整洁的目的,我们将Name列拆分为Firstname和Lastname两个独立字段。利用Python的split方法,配合str.split(expand=True)将列表拆分为新列,随后删除原有的Name列。
# 切分名字,删除源数据列
df[['first_name','last_name']] = df['name'].str.split(expand=True)
df.drop('name', axis=1, inplace=True)
4.2 重复数据
我们需要校验数据中是否存在重复记录。若发现重复项,可使用Pandas提供的drop_duplicates()函数来删除这些重复数据。
# 删除重复数据行
df.drop_duplicates(['first_name','last_name'],inplace=True)
至此,我们完成了上述案例中会员数据的清理工作,以下是清理后的数据结果展示。
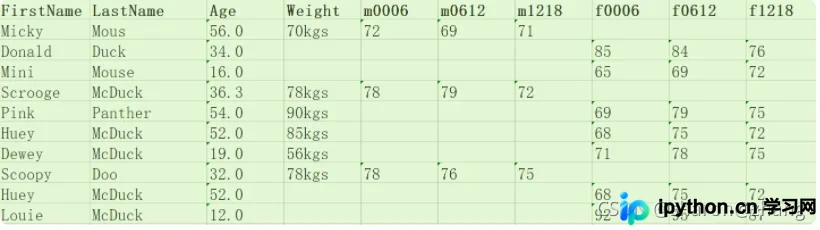
到此为止,关于利用pandas进行数据清洗的方法介绍完毕。如需了解更多pandas数据清洗相关内容,欢迎搜索本站历史文章或继续浏览后续相关文章,希望大家今后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















