


Python数据解析之XPath详解:从原理到实战

本文详细介绍Python中XPath数据解析的原理与应用。涵盖lxml库的安装、etree对象的实例化方法,以及通过XPath表达式定位标签和提取文本或属性值的技巧。结合58同城二手房案例,演示如何处理浏览器显示与源码结构的差异,提供完整的代码示例与注意事项。
XPath
XPath全称为XML Path Language(XML路径语言),是一种专门用于在XML文档中定位特定节点位置的语言。
在众多数据解析方式中,XPath因其通用性强、效率高效且使用便捷而成为首选。它不仅适用于Python,还支持其他多种编程语言,建议在进行数据解析时优先采用XPath方案。
XPath使用方法
XPath解析的基本原理包含两个核心步骤:
首先,需要实例化一个etree对象,并将待解析的页面源代码数据加载到该对象中。
其次,调用etree对象提供的xpath方法,结合具体的XPath表达式来实现对目标标签的定位及内容的捕获。
安装lxml
pip install -i https://mirrors.aliyun.com/pypi/simple/ lxml
from lxml import etree
tree = etree.parse('./tree.html')  #从本地加载源码,实例化一个etree对象。必须是本地的文件,不能是字符串
tree = etree.HTML(源码)           #从互联网加载源码,实例化etree对象
#  / 表示从从根节点开始,一个 / 表示一个层级,//表示多个层级
r = tree.xpath('//div//a')       #以列表的形式返回div下的所有的a标签对象的地址
r = tree.xpath('//div//a')[1]    #返回div下的第二个a标签对象地址
r = tree.xpath('//div[@class="tang"]')   #以列表的形式返回tang标签地址
r = tree.xpath('//div[@class="tang"]//a') #以列表的形式返回tang标签下所有的a标签地址
#获取标签中的文本内容
r = tree.xpath('//div[@class="tang"]//a/text()') #以列表的形式返回所有a标签中的文本
#获取标签中属性值
r = tree.xpath('//div//a/@href')   ##以列表的形式返回所有a标签中href属性值
tree.html
<html lang="en">
    <head>
      <meta charset="utf-8" />
      <meta name="theme-color" content="#ffffff"></meta>
      <title>xpaht测试</title>
    </head>
    <body>
        <div>
            <p>百里守约</p>
        </div>
        <div class="song">
            <p>前程似锦</p>
        </div>
        <div class="song">
            <p>前程似锦2</p>
        </div>
        <div class="ming">  #后面改了名字
            <p>以梦为马</p>
        </div>
        <div class="tang">
            <ul>
                <li><a href='http://123.com' title='qing'>清明时节</a></li>
                <li><a href='http://ws.com' title='qing'>秦时明月</a></li>
                <li><a href='http://xzc.com' title='qing'>汉时关</a></li>
            </ul>
        </div>
      <flink-root></flink-root>
        <script type="text/javascript" src="runtime.0dcf16aad31edd73d8e8.js"></script>
        <script type="text/javascript" src="es2015-polyfills.923637a8e6d276e6f6df.js"></script>
        <script type="text/javascript" src="polyfills.bb2456cce5322b484b77.js"></script>
        <script type="text/javascript" src="main.8128365baee3dc30e607.js"></script>
    </body>
</html>
案例—58二手房
本案例的目标是解析出页面中的房源名称,即提取title属性对应的文本值。
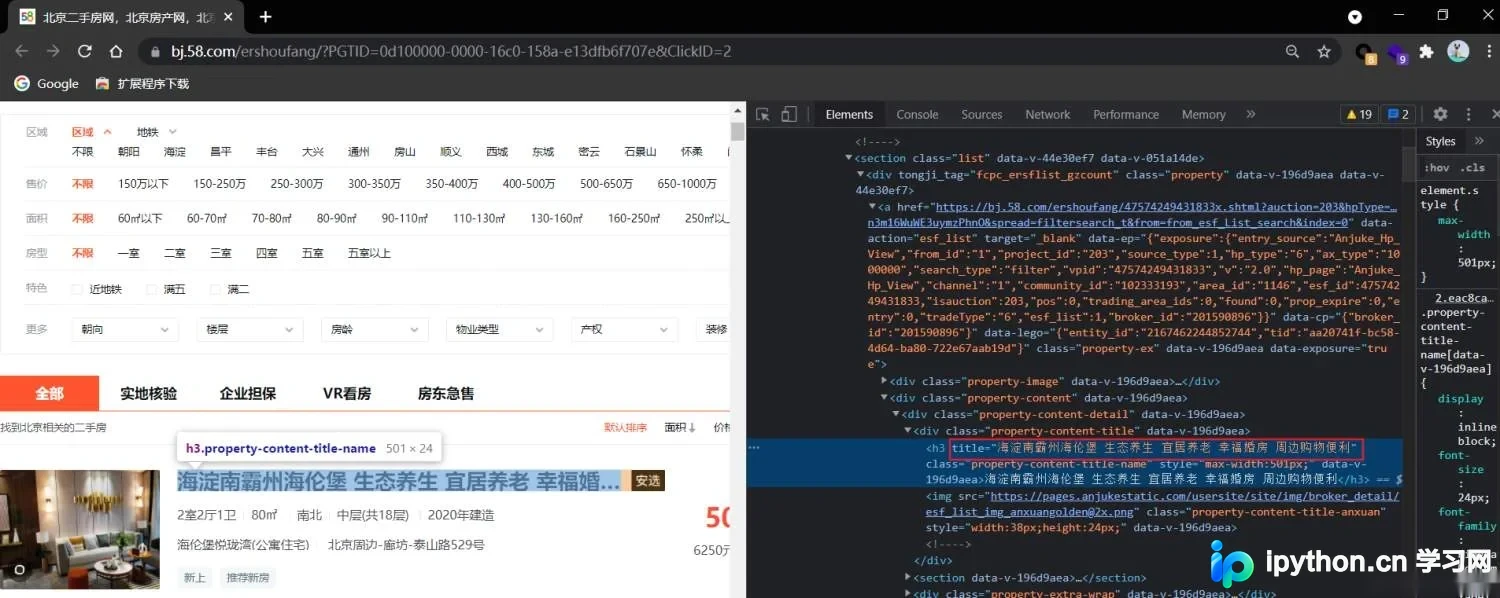
思路
- 第一步,获取包含房源名称的URL,并请求获取相应的响应数据。
- 第二步,进行数据解析,构造合适的XPath表达式以提取目标数据。
import requests
from lxml import etree
url = "https://bj.58.com/ershoufang/p1/"
headers={
    'User-Agent':'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.75 Mobile Safari/537.36'
}
pag_response = requests.get(url,headers=headers,timeout=3).text
#实例化一个etree对象
tree = etree.HTML(pag_response)
r = tree.xpath('//span[@class="content-title"]/text()') #获取所有//span标签为"content-title"的文本内容
print(r)
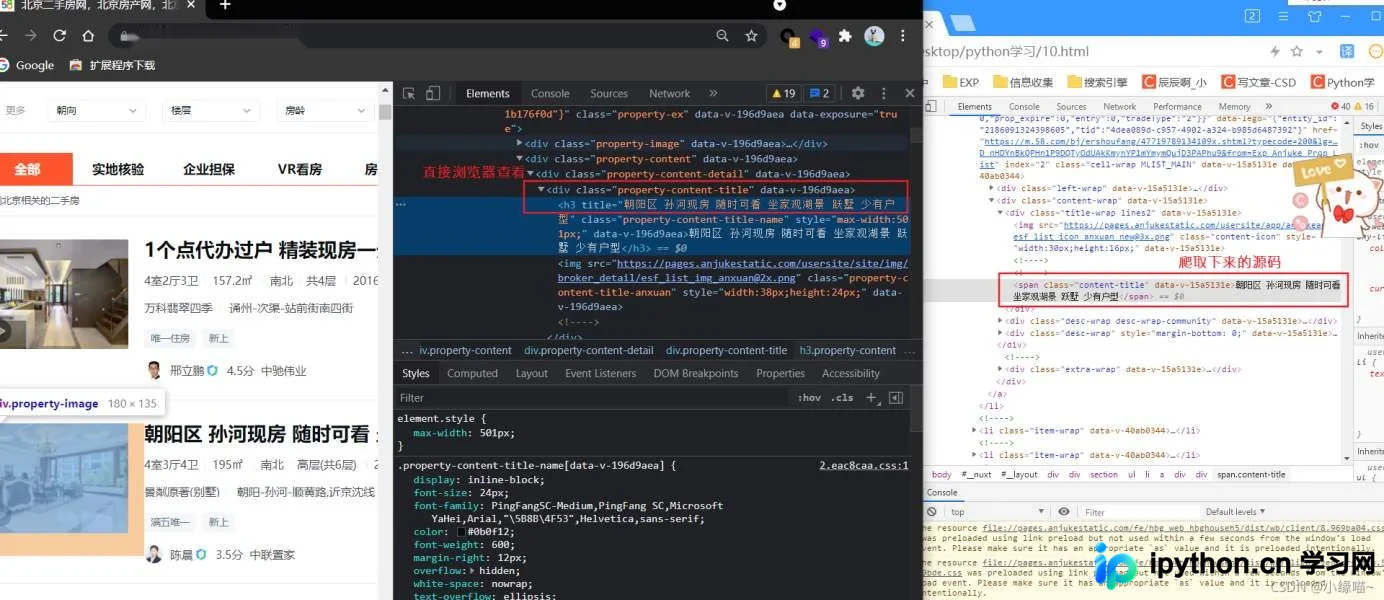
Tips:在使用XPath进行数据解析时,不能仅依赖浏览器中直接查看的元素来构造XPath表达式,因为浏览器渲染后的元素结构往往与爬取到的原始源码结构存在差异。正确的做法是先获取源码,再基于源码结构构造XPath表达式。
如下浏览器中的元素结构和爬取的元素结构就不一样。如果按照浏览器汇总的元素来构造xpath表达式,则不会解析成功!
总结
本篇文章就到这里了,希望能够给你带来帮助,也希望您能够多多关注本站的更多内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















