


Python实现数据透视表的三种方法详解

发布时间:2026-10-14 |
4人浏览过
本文详细介绍在Python中使用Pandas库创建数据透视表的三种核心方法:groupby结合agg、crosstab函数以及pivot_table函数。通过对比各方法的参数设置与适用场景,结合贷款违约率分析的实际案例,展示如何高效进行多维数据交叉统计与汇总。
在Python中,利用Pandas库可以高效实现数据透视表功能。尽管Excel操作直观便捷,但在处理大规模数据或需要自动化流程时,Python代码更具优势。
1. groupby + agg
该方法生成的表格结构可能不够直观,视觉效果不如专用透视表工具友好。
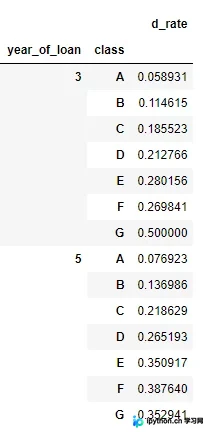
以贷款年份和贷款种类为维度创建数据透视表为例,首先使用groupby对这两个字段进行分组,然后利用agg函数计算目标指标。
train_data.groupby(['year_of_loan', 'class']).agg(d_roat =('isDefault', 'mean'))
2. crosstab
pandas.crosstab(index, columns,values, rownames=None, colnames,
				aggfunc, margins, margins_name, dropna, normalize)
crosstab函数主要涉及以下关键参数:
index:用于指定作为数据透视表行索引的变量。
columns:用于指定作为数据透视表列索引的变量。
values:指定需要聚合的具体数值列。
aggfunc:指定使用的聚合函数,如求和、均值或计数等。
margins:布尔值,决定是否添加总计列或行。
margins_name:当启用汇总时,指定汇总行或列的名称。
以下是具体应用示例:
继续使用贷款年份和贷款种类作为维度,构建数据透视表。
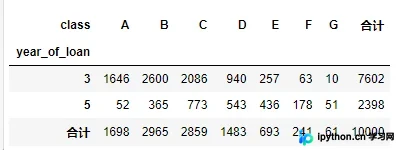
pd.crosstab(train_data['year_of_loan'], train_data['class'], train_data['loan_id'], aggfunc='count',margins = True, margins_name = '合计')
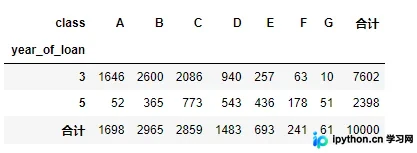
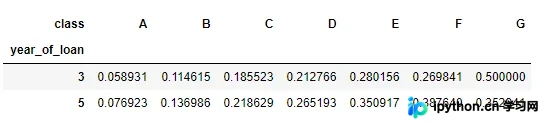
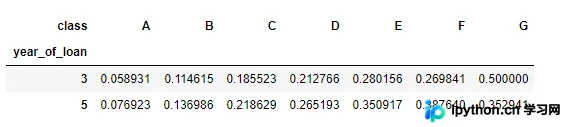
通过交叉组合,可以直接观察到不同年份与种类下的违约比例,便于快速分析。
pd.crosstab(train_data['year_of_loan'], train_data['class'], train_data['isDefault'], aggfunc='mean')
3. groupby + pivot
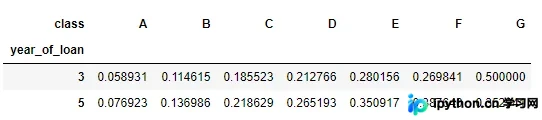
train_data.groupby(['year_of_loan', 'class'], as_index = False)['isDefault'].mean().pivot('year_of_loan', 'class', 'isDefault')
pivot_table
pandas.pivot_table(data, values, index, columns, aggfunc, fill_value,
					margins, dropna, margins_name, observed, sort)
其常用参数与crosstab基本一致,均支持指定索引、列、聚合值及函数。
具体实现示例如下:
通过上述代码,可以实现与前述方法相同的数据透视表效果。
pandas.pivot_table(data, values, index, columns, aggfunc, fill_value,
					margins, dropna, margins_name, observed, sort)
pd.pivot_table(train_data[['year_of_loan', 'class', 'isDefault']],
			   values='isDefault', index=['year_of_loan'], columns=['class'],
			   aggfunc='mean')
总结
本文介绍了相关技术要点,希望能为您提供帮助。欢迎持续关注本站,获取更多技术更新与资源。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















