


Python 更快进行探索性数据分析的四个方法

本文介绍Python中利用Pandas库加速探索性数据分析的四种实用方法。包括通过创建groupby对象复用聚合结果以节省内存并提升速度,使用nlargest和nsmallest快速获取Top N或Bottom N记录,以及利用比较运算符及其包装器进行高效数据切片和条件列生成。这些技巧能显著简化数据处理流程,提高分析效率。
大家好,在进行探索性数据分析时,我们常使用Pandas DataFrame的多种内置方法,例如.head()、.tail()、.info()、.describe()、.plot()以及.value_counts()等,这些是基础且常用的操作。
import pandas as pd
import numpy as np
df = pd.DataFrame( {
"Student" : ["Mike", "Jack", "Diana", "Charles", "Philipp", "Charles", "Kale", "Jack"] ,
"City" : ["London", "London", "Berlin", "London", "London", "Berlin", "London", "Berlin"] ,
"Age" : [20, 40, 18, 24, 37, 40, 44, 20 ],
"Maths_Score" : [84, 80, 50, 36, 44, 24, 41, 35],
"Science_Score" : [66, 83, 51, 35, 43, 58, 71, 65]} )
df
在Pandas中创建groupby()对象
在实际数据处理中,我们往往需要将数据集拆分为多个组并对各组分别进行处理。Pandas提供的groupby()方法正是用于将DataFrame中的数据按照指定条件进行分组。
与其每次调用groupby()后直接跟随聚合方法,不如先创建一个groupby()对象。理想的做法是保留这个对象,以便在后续需要时直接复用,避免重复计算。
假设我们要根据列“City”将给定的DataFrame进行分组。
df_city_group = df.groupby("City")
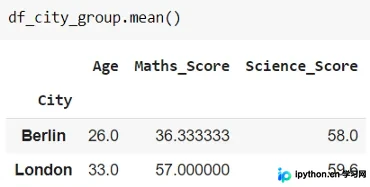
我们可以创建一个名为df_city_group的对象,该对象可以灵活地与min()、max()、mean()、describe()和count()等多种聚合函数结合使用。具体示例如下。
若需获取“City”为Berlin的DataFrame子集,只需调用.get_group()方法即可。
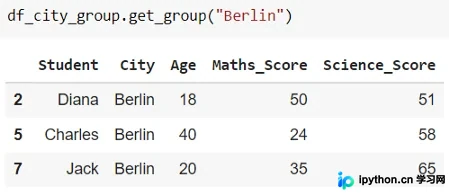
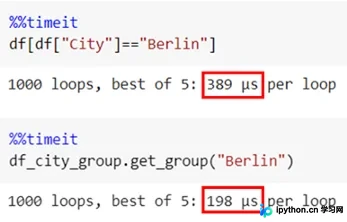
这种方法无需为每个组单独创建子DataFrame的副本,从而有效节省了内存空间。
此外,使用.groupby()进行切片操作的速度比常规方法快2倍。
使用.nlargest()
通常情况下,我们需要根据特定列的值来了解DataFrame中Top 3或Top 5的数据。例如,找出考试中得分最高的前3名学生,或数据集中观看次数最多的前5部电影。使用Pandas的.nlargest()方法是实现这一目标的最简单方式。
df.nlargest(N, column_name, keep = ‘first' )
通过.nlargest()方法,可以检索包含指定列中Top ‘N'值的DataFrame行。
在上面的示例中,让我们获取前3个“Maths_Score”对应的DataFrame行。
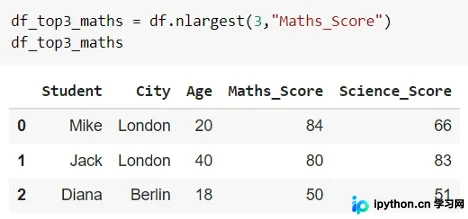
如果存在并列值,可以通过修改附加参数和可选参数来处理。该参数需要“first”、“last”或“all”值,分别用于检索并列值中的第一个、最后一个或所有值。这种方法的优点是无需对DataFrame进行预先排序。
使用.nsmallest()
与获取Top 3或5类似,有时我们也需要DataFrame中Last 5条记录。例如,找出评分最低的5部电影或考试中得分最低的5名学生。使用Pandas的.nsmallest()方法是最简单的实现方式。
df.nsmallestst(N, column_name, keep = ‘first' )
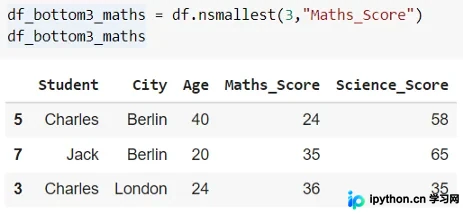
通过.nsmallest()方法,可以检索包含指定列中底部“N”个值的DataFrame行。
在同一个示例中,让我们获取DataFrame“df”中“Maths_Score”最低的3行。
逻辑比较
比较运算符<、>、<=、>=、==、!=及其对应的包装器.lt()、.gt()、.le()、.ge()、.eq()和.ne()在将DataFrame与基值进行比较时非常有用。这种比较会产生一系列布尔值,可作为后续操作的索引依据。
- 基于比较对DataFrame进行切片
- 可以根据与值的比较结果从DataFrame中提取子集。
- 还可以根据两列的比较结果,在现有DataFrame中创建一个新列。
上述所有场景均在下面的示例中进行了解释。
# 1. Comparing the DataFrame to a base value
# Selecting the columns with numerical values only
df.iloc[:,2:5].gt(50)
df.iloc[:,2:5].lt(50)

# 2. Slicing the DataFrame based on comparison
# df1 is subset of df when values in "Maths_Score" column are not equal or equal to '35'
df1 = df[df["Maths_Score"].ne(35)]
df2 = df[df["Maths_Score"].eq(35)]


# 3. Creating new column of True-False values by comparing two columns
df["Maths_Student"] = df["Maths_Score"].ge(df["Science_Score"])
df["Maths_Student_1"] = df["Science_Score"].le(df["Maths_Score"])
总结
在使用Python进行数据分析时,我发现这些方法非常便捷,确实让数据分析过程更加高效。欢迎大家尝试这些技巧,如果你有更棒的方法,欢迎在评论区留言交流!
技术交流
欢迎转载、收藏,如有收获请点赞支持!
到此这篇关于Python 更快进行探索性数据分析的四个方法的文章就介绍到这了,更多相关Python 数据分析内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















