


Python破解起点中文网月票榜字体反爬策略实战

本文详细解析起点中文网月票榜的字体反爬机制,通过Python结合requests、lxml和fonttools库,实现从HTML中提取加密字体文件,解析Unicode编码映射关系,最终还原书名与月票数。教程涵盖XPath定位、正则提取及字体文件动态加载,提供完整代码示例与常见错误排查。
前言:
所谓字体反爬,是指网站将核心数据不直接以明文形式展示在源代码中,而是通过自定义字体文件(通常为ttf或woff格式)将特定编码映射为可见字符。理解这一原理后,我们即可开始进行技术实现。
1.解析过程
按照常规流程,首先打开起点中文网月票榜页面,按下F12打开开发者工具,定位到书名及其对应的月票数据位置,并尝试使用XPath进行提取。
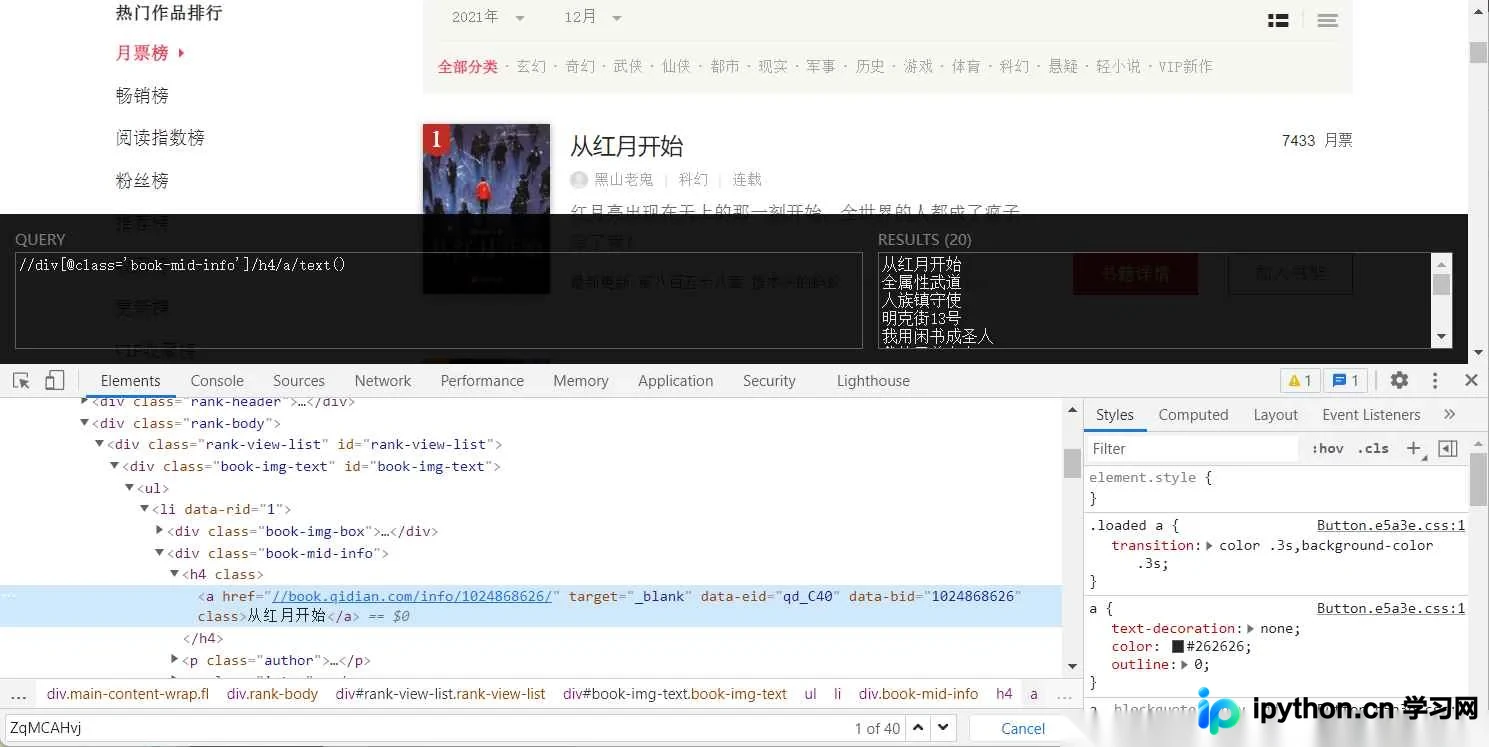
页面恰好显示20条数据,接下来我们需要定位月票的具体数值。
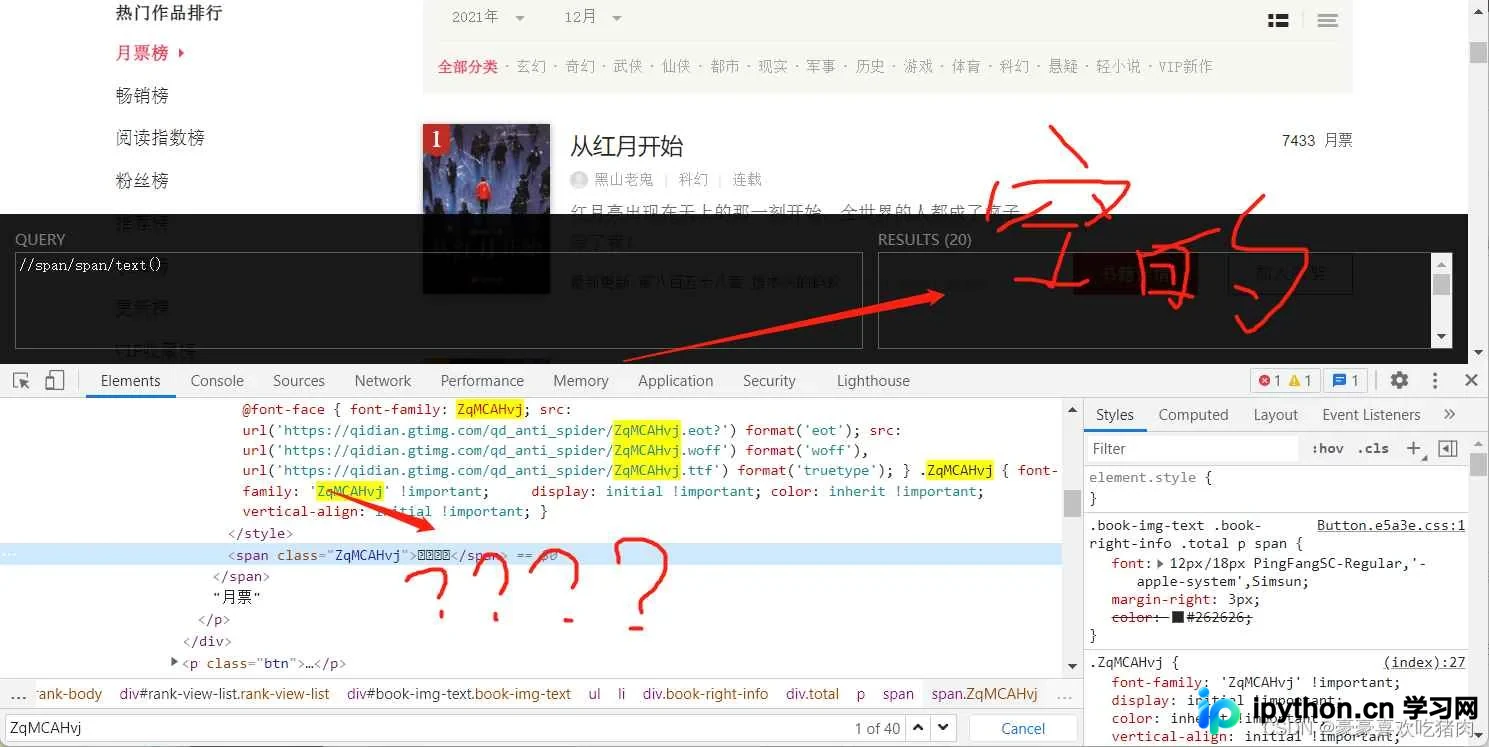
使用XPath检索返回了20条数据,但实际值为空。在Elements面板中查看,数据显示为未知符号,看似无有效数据。此时观察源代码,搜索关键字font-face,可以发现一堆难以直接阅读的编码,这正是前言中提到的字体编码机制。
接下来,我们需要定位字体文件的数据包。
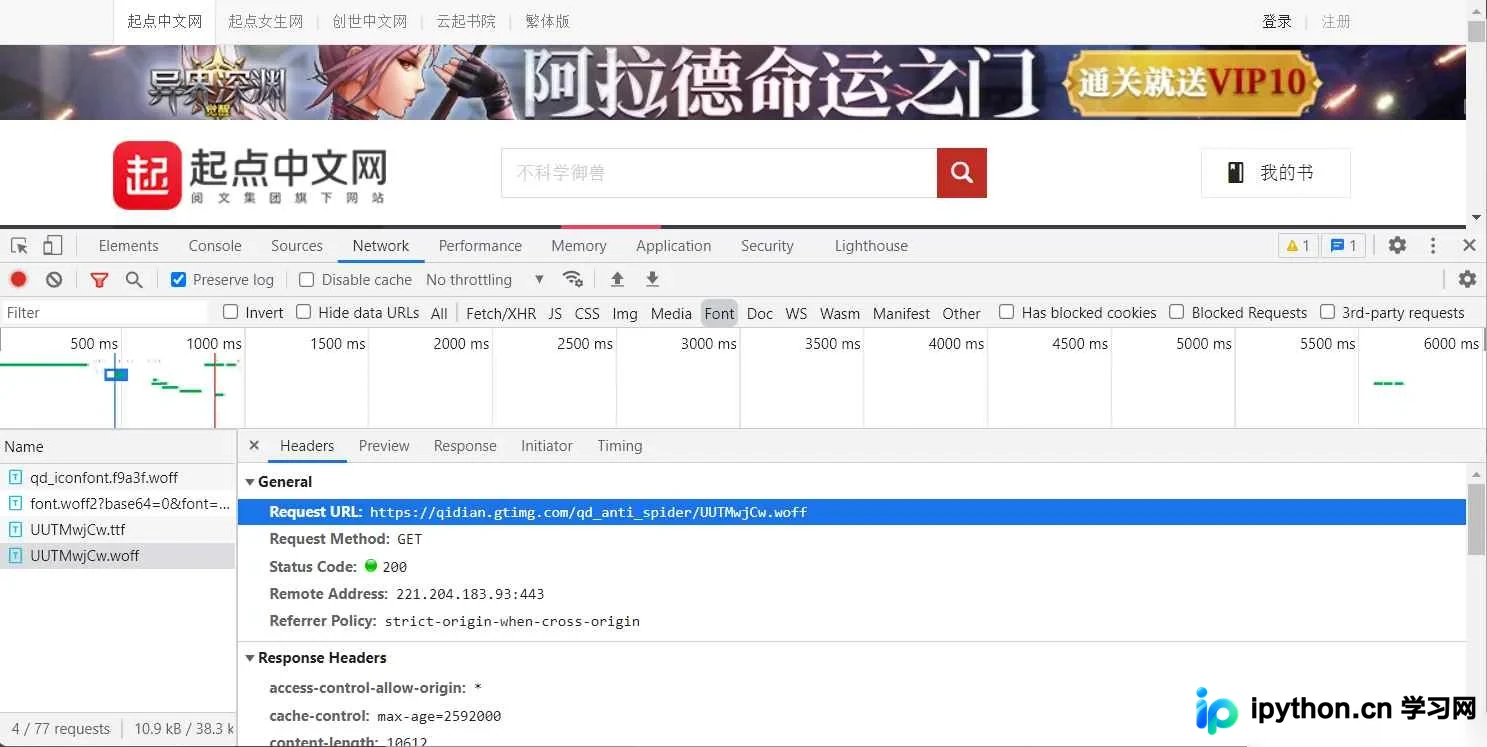
通过观察可以发现woff文件,其请求地址与页面中看到的地址一致。需要注意的是,每次请求的地址和文件名都可能不同,因此每次爬取时都需要单独获取字体加密数据。可以使用第三方库fonttools来解析这些数据。
目前我们已掌握以下要素:
1.书名
2.月票数据的密文编码
3.与密文对应的字体文件
2.开始敲代码
首先定义获取书名的函数get_book_name,并进行初步测试。
import requests
from lxml import etree


def get_book_name(xml_obj):
    name_list = xml_obj.xpath("//div[@class='book-mid-info']/h4/a/text()")
    return name_list


if __name__ == '__main__':
    # 设置我们通用的请求头,避免被反爬拦截
    headers_ = {
        'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36',
        'referer': 'https://www.qidian.com/rank/',
        'cookie': 'e1=%7B%22pid%22%3A%22qd_P_rank_19%22%2C%22eid%22%3A%22%22%2C%22l1%22%3A5%7D; e2=%7B%22pid%22%3A%22qd_P_rank_19%22%2C%22eid%22%3A%22%22%2C%22l1%22%3A5%7D; _yep_uuid=6a2ad124-678f-04d3-7195-2e4e9f5c470e; _gid=GA1.2.501012674.1638335311; newstatisticUUID=1638335311_1217304635; _csrfToken=adBfL5dzru0KuzVgLJpxtsE8zQcfgZT8MzKf0aMs; e2=; e1=%7B%22pid%22%3A%22qd_p_qidian%22%2C%22eid%22%3A%22qd_A16%22%2C%22l1%22%3A3%7D; _ga_FZMMH98S83=GS1.1.1638362844.2.1.1638362855.0; _ga_PFYW0QLV3P=GS1.1.1638362844.2.1.1638362855.0; _ga=GA1.2.2025243050.1638335311; _gat_gtag_UA_199934072_2=1'
    }
    url_ = 'https://www.qidian.com/rank/yuepiao/'
    # 请求网页源代码
    str_data = requests.get(url_, headers=headers_).text
    # 使用xpath解析书名
    xml_obj = etree.HTML(str_data)
    print(get_book_name(xml_obj))   # ['从红月开始', '人族镇守使', '全属性武道', '深空彼岸', '我的云养女友', '我用闲书成圣人', '明克街13号', '星门', '东晋北府一丘八', '夜的命名术', '这个人仙太过正经', '顶级气运,悄悄修炼千年', '不科学御兽', '我的治愈系游戏', '这游戏也太真实了', '长夜余火', '赤心巡天', '轮回乐园', '合道', '宇宙职业选手']
第二步,请求月票数据的密文,并进行测试。
import re
import requests
from lxml import etree
# 获取书名
def get_book_name(xml_obj):
name_list = xml_obj.xpath("//div[@class='book-mid-info']/h4/a/text()")
return name_list
# 获取月票加密数据
def get_yuepiao(str_data):
# 这里我们之前分析发现xpath取出来的数据是空值,我们直接对网页源代码使用re正则匹配获取加密数据
yuepiao_list=re.findall(r'''</style><span class=".*?">(.*?)</span>''',str_data)
return yuepiao_list
if __name__ == '__main__':
# 设置我们通用的请求头,避免被反爬拦截
headers_ = {
'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36',
'referer': 'https://www.qidian.com/rank/',
'cookie': 'e1=%7B%22pid%22%3A%22qd_P_rank_19%22%2C%22eid%22%3A%22%22%2C%22l1%22%3A5%7D; e2=%7B%22pid%22%3A%22qd_P_rank_19%22%2C%22eid%22%3A%22%22%2C%22l1%22%3A5%7D; _yep_uuid=6a2ad124-678f-04d3-7195-2e4e9f5c470e; _gid=GA1.2.501012674.1638335311; newstatisticUUID=1638335311_1217304635; _csrfToken=adBfL5dzru0KuzVgLJpxtsE8zQcfgZT8MzKf0aMs; e2=; e1=%7B%22pid%22%3A%22qd_p_qidian%22%2C%22eid%22%3A%22qd_A16%22%2C%22l1%22%3A3%7D; _ga_FZMMH98S83=GS1.1.1638362844.2.1.1638362855.0; _ga_PFYW0QLV3P=GS1.1.1638362844.2.1.1638362855.0; _ga=GA1.2.2025243050.1638335311; _gat_gtag_UA_199934072_2=1'
}
url_ = 'https://www.qidian.com/rank/yuepiao/'
# 请求网页源代码
str_data = requests.get(url_, headers=headers_).text
# 使用xpath解析书名
xml_obj = etree.HTML(str_data)
print(get_book_name(xml_obj)) # ['从红月开始', '人族镇守使', '全属性武道', '深空彼岸', '我的云养女友', '我用闲书成圣人', '明克街13号', '星门', '东晋北府一丘八', '夜的命名术', '这个人仙太过正经', '顶级气运,悄悄修炼千年', '不科学御兽', '我的治愈系游戏', '这游戏也太真实了', '长夜余火', '赤心巡天', '轮回乐园', '合道', '宇宙职业选手']
print(get_yuepiao(str_data)) # ['𘢒𘢒𘢐𘢉𘢎', '𘢌𘢋𘢐𘢐', '𘢌𘢏𘢌𘢑', '𘢑𘢉𘢒𘢎', '𘢑𘢎𘢋𘢔', '𘢑𘢏𘢏𘢉', '𘢎𘢑𘢐𘢉', '𘢎𘢏𘢑𘢔', '𘢎𘢒𘢉𘢏', '𘢏𘢎𘢏𘢎', '𘢔𘢑𘢑𘢔', '𘢔𘢎𘢐𘢓', '𘢔𘢔𘢑𘢐', '𘢔𘢒𘢑𘢏', '𘢔𘢐𘢒𘢐', '𘢒𘢌𘢉𘢌', '𘢒𘢑𘢌𘢓', '𘢒𘢑𘢎𘢓', '𘢒𘢎𘢓𘢉', '𘢒𘢎𘢏𘢐']第三步,获取字体加密文件中编码与数值的对应关系。
安装fonttools库。
初次使用fonttools库时,可能会遇到错误。经查询,这可能是由于字体文件名不正确导致。将名称替换为URL中携带的名称后,即可成功提取键值对。
(也可能是因为使用re正则提取font_url时格式不规范,导致URL获取错误。)
目前的键值对显示为英文单词,这给程序员带来了不便。我们需要定义一个英文单词与阿拉伯数字对应的字典,用于替换这些英文编码。
def get_font(xml_obj, headers_):
    # 使用xpath与re获取字体加密数据包地址
    font_div = xml_obj.xpath("//span/style/text()")[0]
    font_url = re.findall("eot.*?(https:.*?.woff)", font_div)[0]
    font_name = str(font_url).rsplit('/', 1)[1]
    # 获取font文件进行本地保存
    font_data = requests.get(font_url, headers_).content
    with open(f'{font_name}', 'wb') as f:
        f.write(font_data)
    # 加载字体文件
    font_data = TTFont(f'{font_name}')
    # font_data.saveXML('字体.xml')
    font_doct01 = font_data.getBestCmap()
    font_doct02 = {
        'period': '.',
        'zero': '0',
        'one': '1',
        'two': '2',
        'three': '3',
        'four': '4',
        'five': '5',
        'six': '6',
        'seven': '7',
        'eight': '8',
        'nine': '9'

    }
    for i in font_doct01:
        font_doct01[i]=font_doct02[font_doct01[i]]
    return font_doct01
程序运行结果完美。
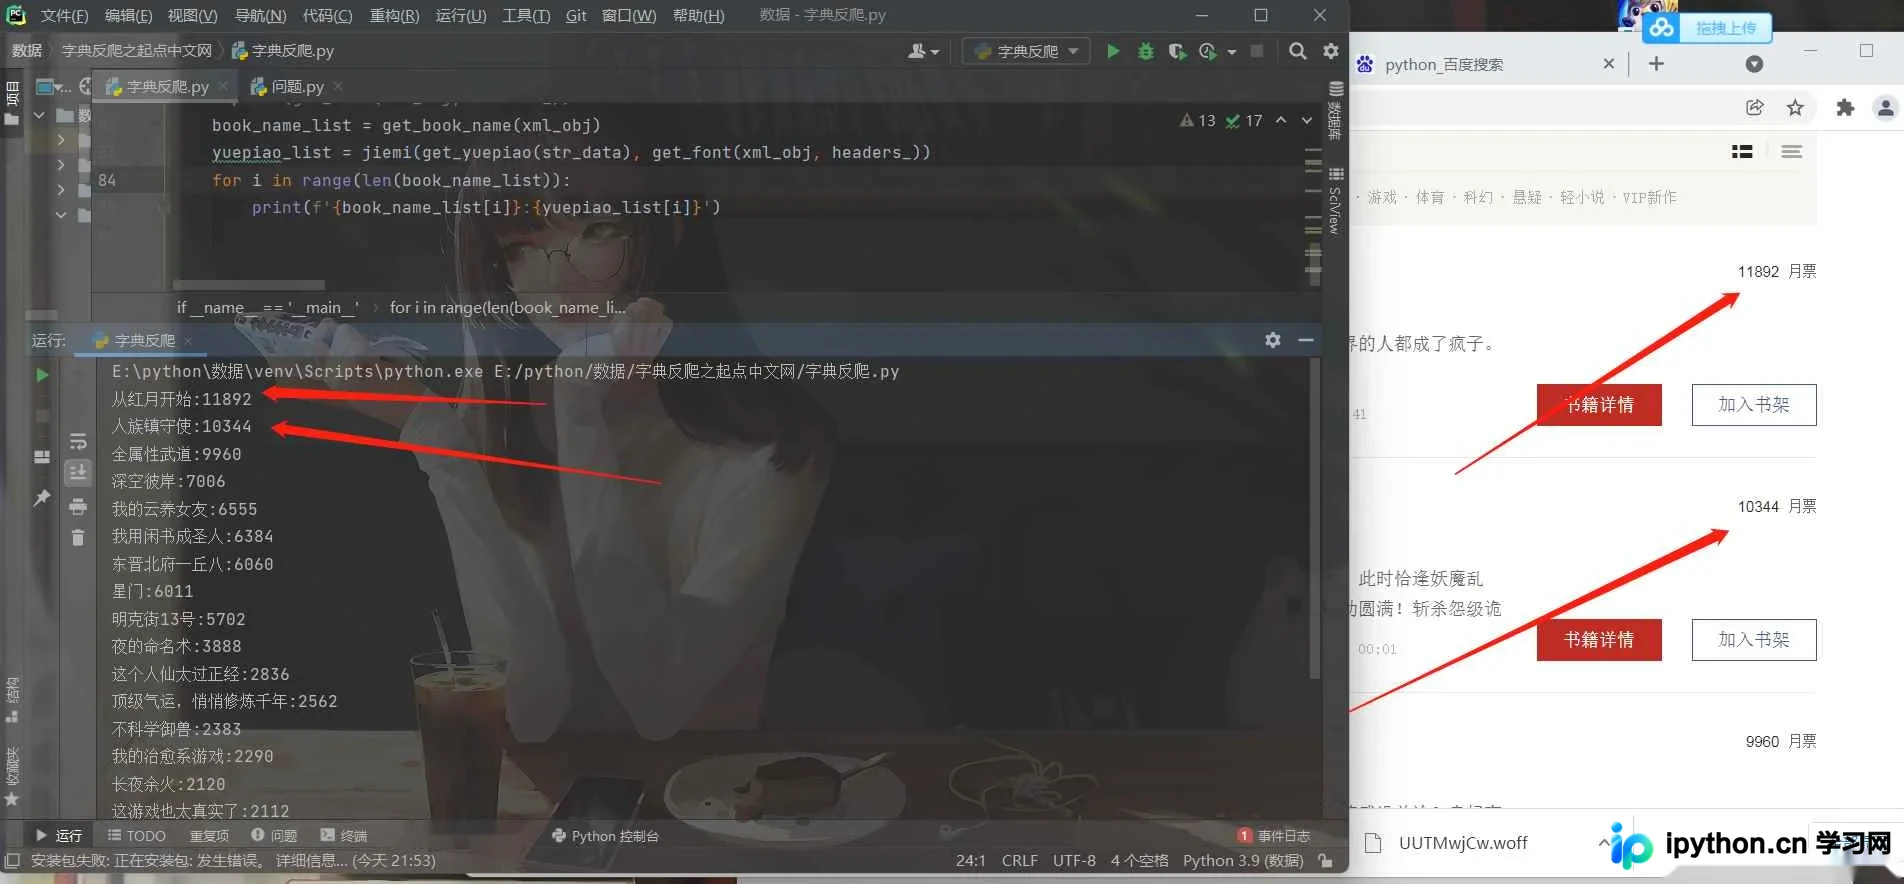
完整代码如下:
import re
import requests
from lxml import etree
from fontTools.ttLib import TTFont
# 获取书名
def get_book_name(xml_obj):
name_list = xml_obj.xpath("//div[@class='book-mid-info']/h4/a/text()")
return name_list
# 获取月票加密数据
def get_yuepiao(str_data):
# 这里我们之前分析发现xpath取出来的数据是空值,我们直接对网页源代码使用re正则匹配获取加密数据
yuepiao_list = re.findall(r'''</style><span class=".*?">(.*?)</span>''', str_data)
return yuepiao_list
def get_font(xml_obj, headers_):
# 使用xpath与re获取字体加密数据包地址
font_div = xml_obj.xpath("//span/style/text()")[0]
font_url = re.findall("eot.*?(https:.*?.woff)", font_div)[0]
font_name = str(font_url).rsplit('/', 1)[1]
# 获取font文件进行本地保存
font_data = requests.get(font_url, headers_).content
with open(f'{font_name}', 'wb') as f:
f.write(font_data)
# 加载字体文件
font_data = TTFont(f'{font_name}')
# font_data.saveXML('字体.xml')
font_doct01 = font_data.getBestCmap()
font_doct02 = {
'period': '.',
'zero': '0',
'one': '1',
'two': '2',
'three': '3',
'four': '4',
'five': '5',
'six': '6',
'seven': '7',
'eight': '8',
'nine': '9'
}
for i in font_doct01:
font_doct01[i] = font_doct02[font_doct01[i]]
return font_doct01
def jiemi(miwen_list, font_list):
yuepiao = []
for i in miwen_list:
num = ''
mw_list=re.findall('&#(.*?);', i)
for j in mw_list:
num += font_list[int(j)]
yuepiao.append(int(num))
return yuepiao
if __name__ == '__main__':
# 设置我们通用的请求头,避免被反爬拦截
headers_ = {
'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36',
'referer': 'https://www.qidian.com/rank/',
'cookie': 'e1=%7B%22pid%22%3A%22qd_P_rank_19%22%2C%22eid%22%3A%22%22%2C%22l1%22%3A5%7D; e2=%7B%22pid%22%3A%22qd_P_rank_19%22%2C%22eid%22%3A%22%22%2C%22l1%22%3A5%7D; _yep_uuid=6a2ad124-678f-04d3-7195-2e4e9f5c470e; _gid=GA1.2.501012674.1638335311; newstatisticUUID=1638335311_1217304635; _csrfToken=adBfL5dzru0KuzVgLJpxtsE8zQcfgZT8MzKf0aMs; e2=; e1=%7B%22pid%22%3A%22qd_p_qidian%22%2C%22eid%22%3A%22qd_A16%22%2C%22l1%22%3A3%7D; _ga_FZMMH98S83=GS1.1.1638362844.2.1.1638362855.0; _ga_PFYW0QLV3P=GS1.1.1638362844.2.1.1638362855.0; _ga=GA1.2.2025243050.1638335311; _gat_gtag_UA_199934072_2=1'
}
url_ = 'https://www.qidian.com/rank/yuepiao/'
# 请求网页源代码
str_data = requests.get(url_, headers=headers_).text
# 使用xpath解析书名
xml_obj = etree.HTML(str_data)
# print(get_book_name(
# xml_obj)) # ['从红月开始', '人族镇守使', '全属性武道', '深空彼岸', '我的云养女友', '我用闲书成圣人', '明克街13号', '星门', '东晋北府一丘八', '夜的命名术', '这个人仙太过正经', '顶级气运,悄悄修炼千年', '不科学御兽', '我的治愈系游戏', '这游戏也太真实了', '长夜余火', '赤心巡天', '轮回乐园', '合道', '宇宙职业选手']
# print(get_yuepiao(
# str_data)) # ['𘢒𘢒𘢐𘢉𘢎', '𘢌𘢋𘢐𘢐', '𘢌𘢏𘢌𘢑', '𘢑𘢉𘢒𘢎', '𘢑𘢎𘢋𘢔', '𘢑𘢏𘢏𘢉', '𘢎𘢑𘢐𘢉', '𘢎𘢏𘢑𘢔', '𘢎𘢒𘢉𘢏', '𘢏𘢎𘢏𘢎', '𘢔𘢑𘢑𘢔', '𘢔𘢎𘢐𘢓', '𘢔𘢔𘢑𘢐', '𘢔𘢒𘢑𘢏', '𘢔𘢐𘢒𘢐', '𘢒𘢌𘢉𘢌', '𘢒𘢑𘢌𘢓', '𘢒𘢑𘢎𘢓', '𘢒𘢎𘢓𘢉', '𘢒𘢎𘢏𘢐']
# print(get_font(xml_obj, headers_))
# 书名列表
book_name_list = get_book_name(xml_obj)
# 月票列表
yuepiao_list = jiemi(get_yuepiao(str_data), get_font(xml_obj, headers_))
for i in range(len(book_name_list)):
print(f'{book_name_list[i]}:{yuepiao_list[i]}')至此,关于Python破解起点中文网月票榜字体反爬的案例介绍完毕。如需了解更多Python字体反爬相关内容,请搜索本站历史文章或继续阅读后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















