


Python数据分析实战:数据清洗与异常值检测详解

发布时间:2026-10-15 |
2人浏览过
本文详细讲解Python中使用Pandas进行数据预处理的核心步骤。通过read_csv读取数据,利用duplicated和drop_duplicates处理重复项,使用notnull筛选非空记录,并基于3σ原则(拉依达准则)识别正态分布下的异常值,为后续分析提供高质量数据基础。
2.1 数据的爬取
代码:
import pandas as pd

data=pd.read_csv("example_data.csv",header=1)

print(data)

data1=pd.read_csv("北京地区信息.csv",header=1,encoding='gbk')

data2=pd.read_csv("天津地区信息.csv",encoding='gbk')

print(data1)

print(data2)
代码运行结果:
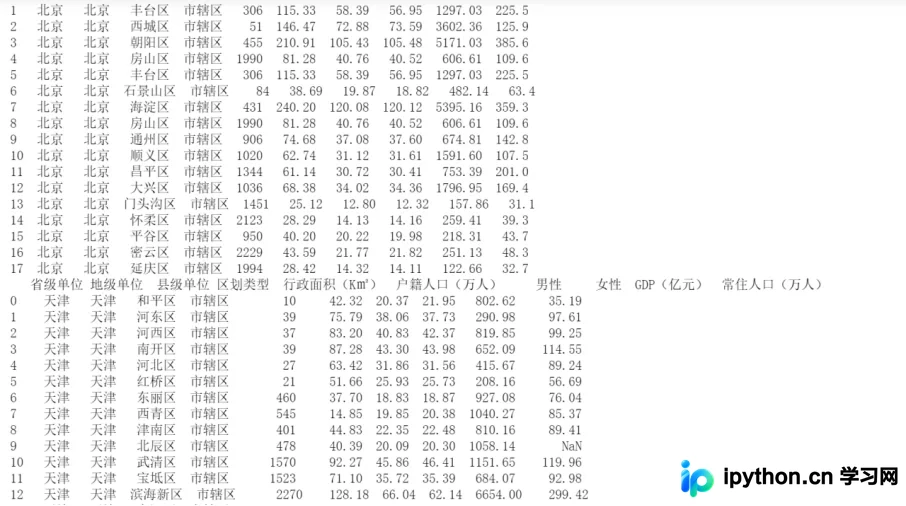
首先调用pandas库中的read_csv()函数来加载数据,随后即可在输出中看到对应的表格结构。
2.2 检查重复数据
dupnum=data.duplicated()

print(dupnum)

\# 对重复值进行处理

caldup=data.drop_duplicates()

print(caldup)
代码运行结果:
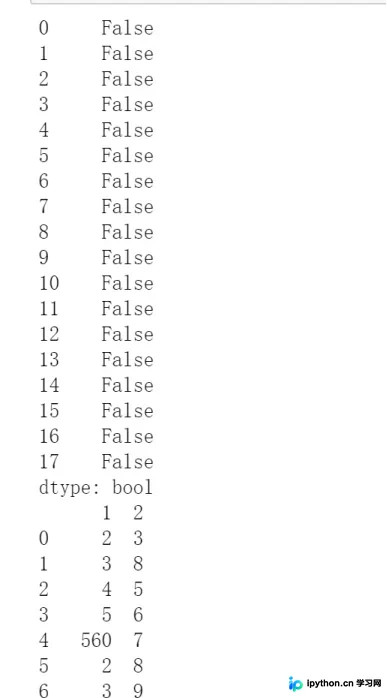
主要利用duplicated()函数执行数据查重操作,该函数返回一个布尔序列,仅对唯一元素标记为True。若存在重复数据,则在对应位置返回Flase。
随后,我们可以调用drop_duplicates()方法来删除重复的值。
2.3 检查缺失值
代码:
from pandas import Series

from numpy import NAN

\# import pandas as pd

series_obj=Series([1,None])

pd.notnull(series_obj)

\# 上面做的是测试

pd.notnull(data)

pd.notnull(data1)

pd.notnull(data2)
代码运行结果:
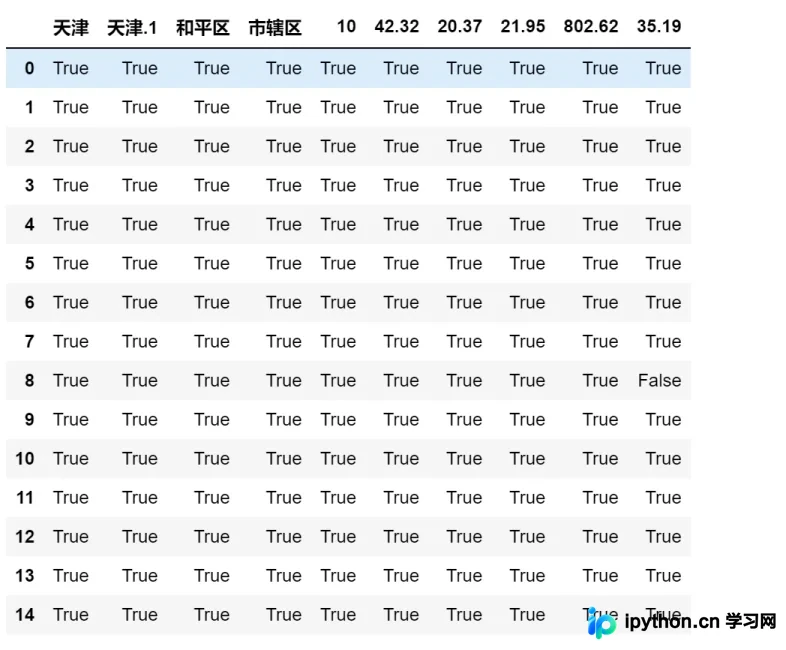
使用pd.notnull(data1)函数返回非空数值,其返回值是一个布尔型矩阵;通过提取df[布尔型矩阵],可以筛选出指定列(如id)非空的行。
2.4 检查异常值
import numpy as np

\# 2.4 检查异常值

def three_sig(ser1):

  mean_value=ser1.mean()

\#   标准差

  std_value=ser1.std()

\#   位于3σ范围外的都是异常值

\# 数值大于u+3σ小雨u-3σ

  rule=(mean_value-3*std_value>ser1)|(ser1.mean()+3*ser1.std()<ser1)

  index=np.arange(ser1.shape[0])[rule]

  outrange=ser1.iloc[index]

  return outrange

three_sig(data2["女性"])
代码运行结果:
3σ原则,亦称拉依达准则,其核心逻辑是:假设检测数据仅包含随机误差,先对原始数据进行计算得出标准差,再依据特定概率确定一个区间,凡误差超出该区间的数值即被判定为异常值。
通俗而言,这对应于正态分布的统计特性。
至此,关于Python数据分析与处理——处理中国地区信息的介绍已完毕,更多相关Python数据分析与处理内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















