


Python pandas多级索引取值实战:重置列与直接索引法

本文详解pandas中多级索引数据的提取技巧。通过重置索引为列并结合布尔条件或query方法,以及利用链式调用和元组索引直接取值,解决多层级数据查找问题。文章对比两种方法的操作步骤与注意事项,帮助开发者高效处理复杂索引结构。
近期观察到许多开发者倾向于使用其他数据操作库而较少使用pandas,作为数据领域从业者,日常工作中离不开pandas,因此撰写此系列文章旨在帮助更多伙伴熟悉并掌握pandas的使用。
运行环境配置如下:
操作系统为windows 10
Python版本为3.8
pandas库版本为1.2.4
具体数据需求
面对一份包含多级索引的数据集,目标是查找并提取指定数值。
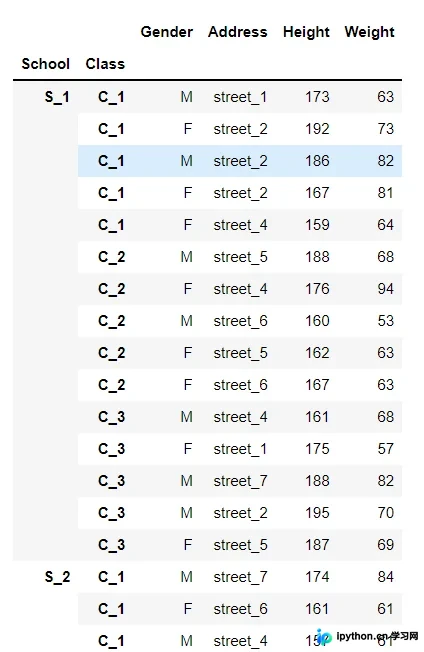
需求分析与拆解
在pandas或Python中进行数据提取本质上是索引操作。对于单层索引,使用.loc或.iloc方法已十分普遍;但当索引层级增加时,操作变得复杂。解决思路是将各层索引视为整体进行统一提取。
具体处理方案
第一种方法较为繁琐:首先将多级索引重置为普通列,然后基于这些列构建布尔条件进行数据筛选。
具体操作是将索引转换为列,利用列值生成筛选条件。
datac.reset_index(inplace=True)
datac[(datac['School'] == 'S_2') & (datac['Class'] == 'C_3')]
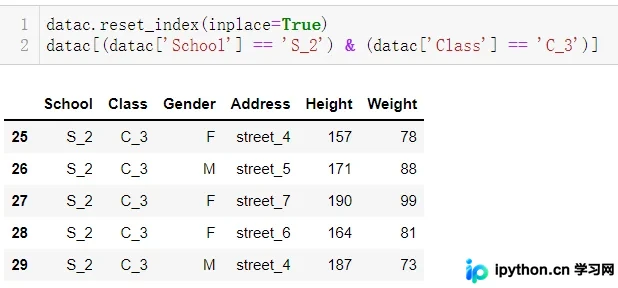
通过上述流程,可以成功获取目标数据。
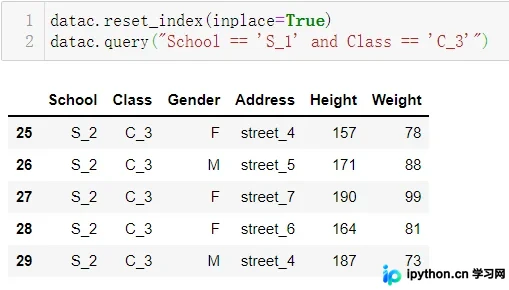
此外,还可以使用.query方法来实现同样的条件筛选效果。
datac.reset_index(inplace=True)
datac.query("School == 'S_1' and Class == 'C_3'")
第二种方法
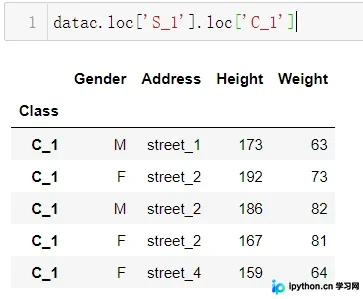
针对多级索引,pandas提供了专门的取值机制。既支持链式调用,也支持通过元组直接索引。首先观察多级索引的输出结构:
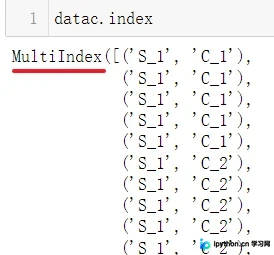
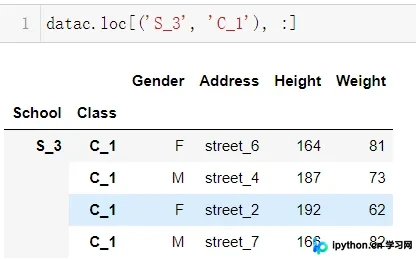
输出结果为MultiIndex类型,其内部元素均为元组,因此可以直接利用元组形式进行索引访问。
这两种方式均遵循从左至右、先外层后内层的访问顺序,若顺序颠倒则会引发KeyError错误。
# 链式调用
datac.loc['S_1'].loc['C_1']
# 元组作为索引调用
datac.loc[('S_3', 'C_1'), :]
注意事项:
1. 若列名本身具有层次结构(即多级索引),同样适用上述提取逻辑。
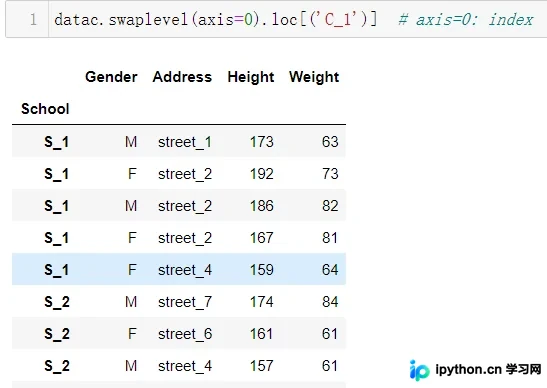
2. 若需跳过外层索引直接访问内层索引,必须先交换索引层级顺序,方可正常提取。
# swaplevel 交换索引层级
datac.swaplevel(axis=0).loc[('C_1')]  # axis=0: index
总结
无论技巧多高,基础操作不可或缺。本文介绍的常规方法旨在夯实基础,确保在遇到类似问题时,能直接利用索引取值,避免不必要的索引重置操作,从而提升数据提取效率。
本文内容至此结束,希望能为读者提供帮助,欢迎持续关注本站获取更多技术资讯!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















