


sklearn中make_blobs的用法详情

发布时间:2026-10-15 |
4人浏览过
本文详细介绍sklearn中make_blobs函数的用法,涵盖n_features、n_samples、centers、random_state及cluster_std等核心参数的含义与配置方法,通过具体代码示例展示如何生成指定特征、样本量及方差的多类聚类数据集,并说明随机种子对结果复现的重要性。
sklearn库中的make_blobs函数主要用于生成用于聚类分析的合成数据集,其具体应用如下所述。
1.调用make_blobs
from sklearn.datasets import make_blobs2.make_blobs的用法
data, label = make_blobs(n_features=2, n_samples=100, centers=3, random_state=3, cluster_std=[0.8, 2, 5])n_features参数用于指定每个样本包含的特征值数量。n_samples参数用于指定生成的样本总数。centers参数设定聚类中心点的数量,这通常对应于标签(label)的种类数。random_state参数用于设置随机种子,通过固定该值可以确保每次生成的数据保持一致。cluster_std参数用于设置每个类别的方差,控制簇的分散程度。
以下通过具体代码示例进行说明。
'''创建训练的数据集'''
from sklearn.datasets import make_blobs
data, label = make_blobs(n_features=2, n_samples=100, centers=2, random_state=2019, cluster_std=[0.6,0.7] )
观察生成的数据集情况:
data变量包含2个特征(由n_features=2指定),样本总数量为100(通过n_samples=100设定)。
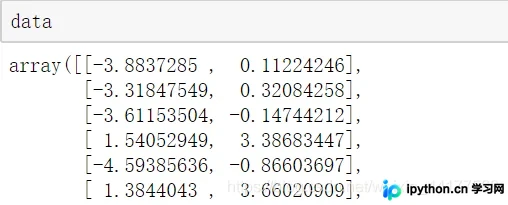
进一步查看生成的标签信息:
由于设置了centers=2,标签仅包含0或1两种值,且标签数组的维度为100。
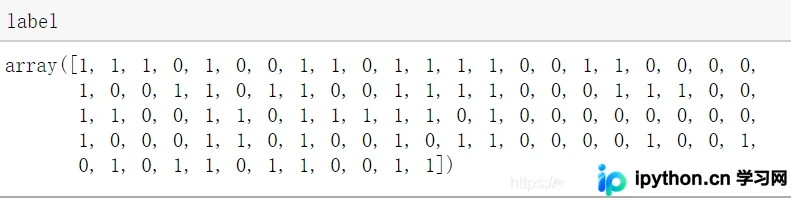
当random_state被赋予具体数值后,每次运行生成的数据集将保持固定,这有利于后续工作的复现;若不设置该参数,默认情况下每次生成随机数据,使用时需注意此差异。
通过以上步骤,我们成功获取了符合需求的数据集,随后可开展后续的算法训练与分析工作。
至此,关于sklearn中make_blobs函数的用法详情介绍完毕,更多相关sklearn中make_blobs函数的内容请搜索本站历史文章或继续浏览下方相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















