


Python线性回归模型检验:深入解析拟合优度R^2

本文详解Python线性回归模型中的拟合优度检验标准,重点解析判定系数R^2的含义、计算公式及评估标准。通过总体平方和、回归平方和与残差平方和的关系,结合具体代码示例演示如何计算R^2并评估模型准确性,帮助开发者掌握模型验证的核心方法。
完成回归模型的构建后,必须对模型的有效性进行验证,即确认该模型能否准确反映因变量与自变量之间的真实关系。这一验证过程通常采用拟合优度作为核心评估指标。
拟合优度用于衡量回归方程对观测数据的匹配程度,其核心度量统计量为判定系数R^2。R^2的取值区间为[0, 1]。当R^2的值越接近1时,表明回归方程对观测值的拟合效果越佳;反之,若R^2的值越接近0,则说明拟合效果较差。
目前学术界尚未对拟合优度的统一判定标准达成完全一致,但在实际应用中,通常将R^2大于0.8视为模型具有较高准确性的参考阈值。
拟合优度的计算公式为:R^2 = 1 - RSS/TSS。
其中,RSS代表离差平方和(残差平方和),TSS代表总体平方和。
在深入理解拟合优度公式之前,需要明确三个关键概念:总体平方和、离差平方和以及回归平方和。
一、总体平方和、离差平方和与回归平方和解析
主要涉及的三个指标为:回归平方和(ESS)、残差平方和(RSS)以及总体平方和(TSS)。
TSS(Total Sum of Squares,总体平方和)表示实际观测值与期望值(均值)的离差平方和,它反映了数据变量的总变动程度。
ESS(Explained Sum of Squares,回归平方和)表示预测值与期望值(均值)的离差平方和,它代表了由预测模型所解释的变量变动程度。
RSS(Residual Sum of Squares,残差平方和)表示实际观测值与预测值之间的离差平方和,它代表了模型未能解释的变量未知变动程度。
上述各个平方和的具体计算公式如下:
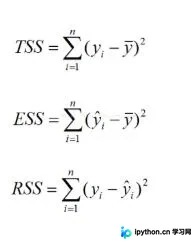
二、拟合优度原理详解
基于前述内容,我们将实际值与期望值的离差平方和(TSS)视为整体变量的总变动程度,这也是构建模型旨在模拟的核心目标。
建立模型后,整体变量的总变动程度(TSS)可被分解为两部分:由模型模拟解释的变动程度(ESS)和未被模型解释的未知变动程度(RSS)。
一般而言,预测模型所解释的变量变动程度在总变动程度中的占比越高,模型越准确。当RSS等于0时,意味着模型能够完全模拟变量的总变动,即完美拟合。
回到文章开头的拟合优度公式:R^2 = 1 - RSS/TSS。通过上述分解,该公式的含义便清晰易懂。
例如,假设计算得出R^2 = 0.8,这意味着所建立的模型能够解释80%的总变动程度,而剩余的20%则属于未知或未被模型捕捉的变动。
三、实战案例分析
以学生成绩分析为例,我们需要探究学生的学习成绩与单一变量——学习时间之间是否存在关联。相关数据如下:
'学习时间':[0.50,0.75,1.00,1.25,1.50,1.75,1.75, 2.00,2.25,2.50,2.75,3.00,3.25,3.50,4.00,4.25,4.50,4.75,5.00,5.50],
'分数':[10,22,13,43,20,22,33,50,62,48,55,75,62,73,81,76,64,82,90,93]
根据常识,学习时间越长,分数通常越高,两者呈现正相关关系。由于仅涉及一个自变量,可直接使用sklearn库计算截距和斜率。
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from pandas import DataFrame,Series
from sklearn.cross_validation import train_test_split
from sklearn.linear_model import LinearRegression

#创建数据集
examDict = {'学习时间':[0.50,0.75,1.00,1.25,1.50,1.75,1.75,
           2.00,2.25,2.50,2.75,3.00,3.25,3.50,4.00,4.25,4.50,4.75,5.00,5.50],
       '分数':[10,22,13,43,20,22,33,50,62,
          48,55,75,62,73,81,76,64,82,90,93]}

#转换为DataFrame的数据格式
examDf = DataFrame(examDict)
#examDf
#绘制散点图
plt.scatter(examDf.分数,examDf.学习时间,color = 'b',label = "Exam Data")

#添加图的标签(x轴,y轴)
plt.xlabel("Hours")
plt.ylabel("Score")
#显示图像
plt.show()

#将原数据集拆分训练集和测试集
exam_X = examDf.学习时间
exam_Y = examDf.分数
X_train,X_test,Y_train,Y_test = train_test_split(exam_X,exam_Y,train_size=0.8)
#X_train为训练数据标签,X_test为测试数据标签,exam_X为样本特征,exam_y为样本标签,train_size 训练数据占比

print("原始数据特征:",exam_X.shape,
   ",训练数据特征:",X_train.shape,
   ",测试数据特征:",X_test.shape)

print("原始数据标签:",exam_Y.shape,
   ",训练数据标签:",Y_train.shape,
   ",测试数据标签:",Y_test.shape)

model = LinearRegression()

#对于模型错误我们需要把我们的训练集进行reshape操作来达到函数所需要的要求
# model.fit(X_train,Y_train)

#reshape如果行数=-1的话可以使我们的数组所改的列数自动按照数组的大小形成新的数组
#因为model需要二维的数组来进行拟合但是这里只有一个特征所以需要reshape来转换为二维数组
X_train = X_train.values.reshape(-1,1)
X_test = X_test.values.reshape(-1,1)

model.fit(X_train,Y_train)
a = model.intercept_#截距
b = model.coef_#回归系数
print("最佳拟合线:截距",a,",回归系数:",b)
接下来计算拟合优度以验证模型,结果显示拟合优度为0.83,符合大于0.8的参考标准。
# 用训练集进行拟合优度,验证回归方程是否合理
def get_lr_stats(x, y, model):
  message0 = '一元线性回归方程为: '+'\ty' + '=' + str(model.intercept_)+' + ' +str(model.coef_[0]) + '*x'
  from scipy import stats
  n = len(x)
  y_prd = model.predict(x)
  Regression = sum((y_prd - np.mean(y))**2) # 回归平方和
  Residual  = sum((y - y_prd)**2)     # 残差平方和
  total = sum((y-np.mean(y))**2) #总体平方和
  R_square  = 1-Residual / total # 相关性系数R^2
  message1 = ('相关系数(R^2): ' + str(R_square) + ';' + '\n'+ '总体平方和(TSS): ' + str(total) + ';' + '\n')
  message2 = ('回归平方和(RSS): ' + str(Regression) + ';' + '\n残差平方和(ESS): ' + str(Residual) + ';' + '\n')
  return print(message0 +'\n' +message1 + message2 )

get_lr_stats(X_train,Y_train,model)
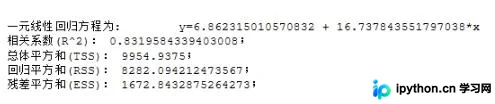
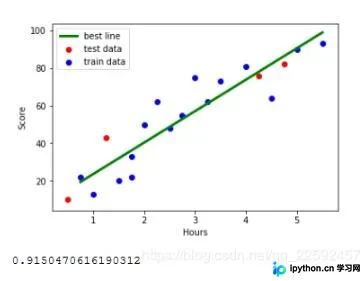
如有需要,可将所有数据点与回归直线绘制在同一图表中,以便直观观察拟合效果。
#训练数据的预测值
y_train_pred = model.predict(X_train)
#绘制最佳拟合线:标签用的是训练数据集中的极值预测值
X_train_pred = [min(X_train),max(X_train)]
y_train_pred = [a+b*min(X_train),a+b*max(X_train)]
plt.plot(X_train_pred, y_train_pred, color='green', linewidth=3, label="best line")

#测试数据散点图
plt.scatter(X_test, Y_test, color='red', label="test data")
plt.scatter(X_train, Y_train, color="blue", label="train data")

#添加图标标签
plt.legend(loc=2)
plt.xlabel("Hours")
plt.ylabel("Score")
#显示图像
plt.savefig("lines.jpg")
plt.show()
#计算拟合优度
score = model.score(X_test,Y_test)
print(score)
以上关于Python线性回归分析模型检验标准及拟合优度的详解内容分享完毕,希望能为读者提供参考与支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















