


Pandas中Lambda函数的进阶用法与实战技巧

本文详解Pandas中Lambda函数的多种应用场景,包括结合apply方法创建复杂新列、处理多条件数据筛选、解决特定数据类型转换报错,以及使用tqdm提升大数据处理时的可视化体验。通过具体代码示例,展示如何高效利用Lambda优化数据处理流程。
导入必要的Python模块并加载数据集是数据处理的第一步。
首先,需要导入Pandas模块,并读取包含电影数据的CSV文件,以便后续进行各项操作。
import pandas as pd

df = pd.read_csv("IMDB-Movie-Data.csv")
df.head()
在现有数据基础上创建新的列是常见需求。
通常,我们可以通过对现有两列进行简单的数学运算来生成新列,例如计算平均评分。
df['AvgRating'] = (df['Rating'] + df['Metascore']/10)/2
然而,当新列的计算逻辑较为复杂时,lambda函数便显得尤为必要。我们可以先定义一个处理逻辑的函数。
def custom_rating(genre,rating):
    if 'Thriller' in genre:
        return min(10,rating+1)
    elif 'Comedy' in genre:
        return max(0,rating-1)
    elif 'Drama' in genre:
        return max(5, rating-1)
    else:
        return rating
针对不同类别的电影,我们采用差异化的评分计算策略:对于“惊悚片”,取“原评分+1”与10分中的较小值;对于“喜剧片”,取0分与“原评分-1”中的较大值;其他类型则保持原评分。随后,利用apply方法配合lambda函数,将该自定义逻辑应用于DataFrame对象中。
df["CustomRating"] = df.apply(lambda x: custom_rating(x['Genre'], x['Rating']), axis = 1)
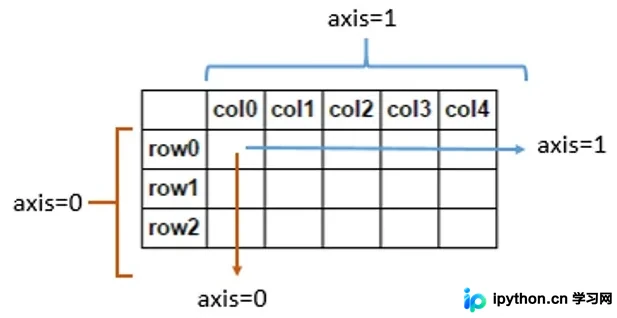
这里需要解释axis参数的含义:axis=1表示沿列方向(跨列)操作,而axis=0表示沿行方向(跨行)操作,具体区别可参考相关图示。
对数据进行筛选是数据分析中的核心环节。
在pandas环境中,利用& | ~等逻辑操作符进行数据筛选相对直观,具体代码实现如下。
# 单个条件,评分大于5分的
df_gt_5 = df[df['Rating']>5]

# 多个条件: AND - 同时满足评分高于5分并且投票大于100000的
And_df = df[(df['Rating']>5) & (df['Votes']>100000)]

# 多个条件: OR - 满足评分高于5分或者投票大于100000的
Or_df = df[(df['Rating']>5) | (df['Votes']>100000)]

# 多个条件:NOT - 将满足评分高于5分或者投票大于100000的数据排除掉
Not_df = df[~((df['Rating']>5) | (df['Votes']>100000))]
上述方法适用于常规场景,但若需筛选电影的影名长度大于5这样的特定条件,直接套用前述逻辑可能会引发错误。
df[len(df['Title'].split(" "))>=5]
程序输出结果。
AttributeError: 'Series' object has no attribute 'split'
为解决上述问题,我们可以结合apply与lambda函数来实现复杂筛选功能。
#创建一个新的列来存储每一影片名的长度
df['num_words_title'] = df.apply(lambda x : len(x['Title'].split(" ")),axis=1)

#筛选出影片名长度大于5的部分
new_df = df[df['num_words_title']>=5]
如果认为上述步骤较为繁琐,也可以尝试一步到位的写法。
new_df = df[df.apply(lambda x : len(x['Title'].split(" "))>=5,axis=1)]
例如,若要筛选出票房低于当年平均水平的电影数据,可按以下步骤操作。
首先,计算每年票房的平均值,相关代码如下。
year_revenue_dict = df.groupby(['Year']).agg({'Revenue(Millions)':np.mean}).to_dict()['Revenue(Millions)']
接着,定义一个函数来判断某部电影的票房是否低于其所在年份的平均水平,该函数返回布尔值。
def bool_provider(revenue, year):
    return revenue<year_revenue_dict[year]
最后,结合apply与lambda方法,将上述逻辑应用于数据集以完成筛选。
new_df = df[df.apply(lambda x : bool_provider(x['Revenue(Millions)'],x['Year']),axis=1)]
在数据筛选过程中,.loc方法使用频率极高,它常与lambda函数配合使用。例如,若要筛选评分在5至8分之间且获取其票房数据,代码如下。
df.loc[lambda x: (x["Rating"] > 5) & (x["Rating"] < 8)][["Title", "Revenue (Millions)"]]
有时需要转变指定列的数据类型以适应后续分析。
通常,我们调用astype方法来实现类型转换,例如将“Price”列转换为整型,代码示例如下。
df['Price'].astype('int')
执行上述代码可能会遇到如下报错信息。
ValueError: invalid literal for int() with base 10: '12,000'
因此,当数据中包含类似“12,000”格式的字符串时,直接调用astype方法转换类型会失败。此时,需结合apply与lambda进行数据清洗,具体代码如下。
df['Price'] = df.apply(lambda x: int(x['Price'].replace(',', '')),axis=1)
在大规模数据处理中,可视化方法调用过程有助于监控进度。
当处理大型数据集且函数调用耗时较长时,添加进度条能直观展示处理进度,提升用户体验。
为此,我们需要导入tqdm模块。
from tqdm import tqdm, tqdm_notebook
tqdm_notebook().pandas()
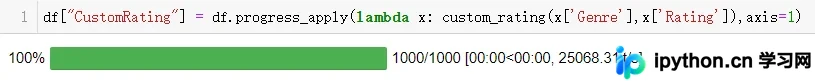
将原有的apply方法替换为progress_apply方法即可实现进度条显示,代码如下。
df["CustomRating"] = df.progress_apply(lambda x: custom_rating(x['Genre'],x['Rating']),axis=1)
程序运行输出。
探讨Lambda与条件判断的结合使用。
我们可以将if-else逻辑嵌入lambda函数中,具体代码示例如下。
Bigger = lambda x, y : x if(x > y) else y
Bigger(2, 10)
程序输出结果。
10
当涉及多组if-else条件时,嵌套写法可能显得杂乱,代码如下。
df['Rating'].apply(lambda x:"低分电影" if x < 3 else ("中等电影" if x>=3 and x < 5 else("高分电影" if x>=8 else "值得观看")))
鉴于上述写法的可读性较差,建议采用自定义函数,并通过apply与lambda方法配合使用,以提高代码清晰度。
以上就是关于Pandas中Lambda函数组合使用的详细介绍,更多Python及Pandas相关内容欢迎查阅本站往期文章或继续浏览后续章节,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















