


Python网络爬虫实战:抓取并保存中国大学排名数据

发布时间:2026-10-15 |
4人浏览过
本文介绍如何使用Python编写网络爬虫,自动获取中国大学排名网站的前20所大学信息。通过requests库请求网页,利用BeautifulSoup解析HTML结构,提取学校名称、省份及总分等关键字段,并将结果格式化输出至控制台及本地文本文件,实现数据的自动化采集与持久化存储。
Python爬取中国大学排名实现方案
本程序旨在解决以下问题:
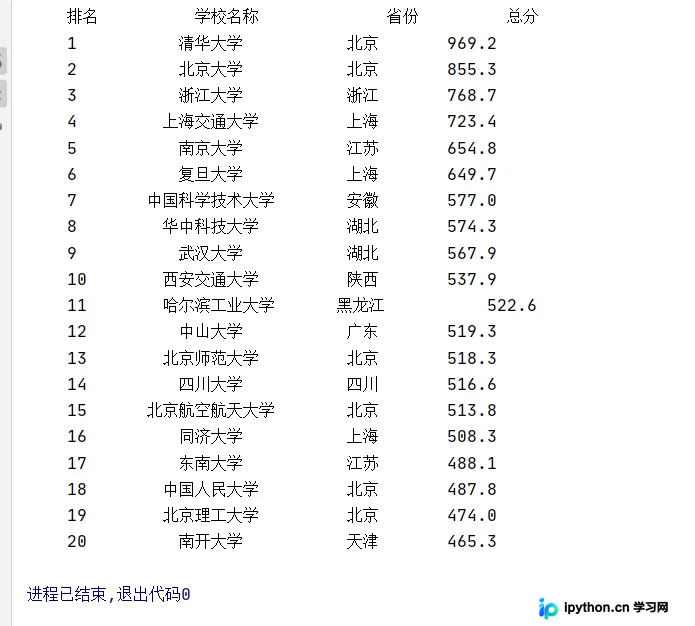
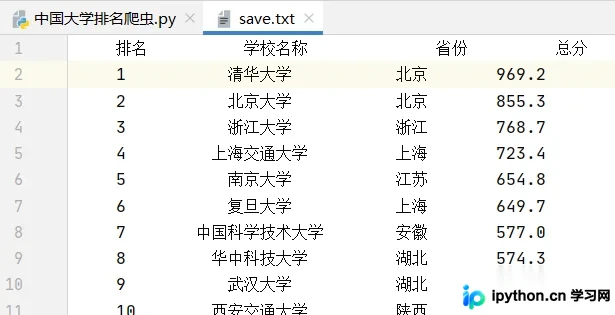
利用Python网络爬虫技术,从指定中国大学排名网站抓取排名数据,将排名前20的高校详细信息保存至文本文件,并在程序窗口中按列格式打印这20所大学的信息。
具体实现代码如下:
import requests
from bs4 import BeautifulSoup
import bs4

def getHTMLText(url):
    try:
        r = requests.get(url, timeout=30)
        r.raise_for_status()
        r.encoding = r.apparent_encoding
        return r.text
    except:
        return ""

def fillUnivList(ulist, html):
    soup = BeautifulSoup(html, "html.parser")
    for tr in soup.find('tbody').children:
        if isinstance(tr, bs4.element.Tag):
            tds = tr('td')
            hdfd = tds[0].find('div')
            tt = hdfd.string.split()
            ff = "".join(tt)
            attr = tds[1].find('a')
            hh = tds[4].string.split()
            hg = "".join(hh)
            shf=tds[2].text.split()
            shfn="".join(shf)
            ulist.append([ff, attr.string,shfn,hg])


def printUnivList(ulist, num):
    tplt = "{0:^10}\t{1:{4}^10}\t{2:^10}\t{3:^10}"
    print(tplt.format("排名","学校名称","省份","总分", chr(12288)))
    with open('save.txt', 'w+', encoding='utf-8') as f:
        f.write(tplt.format("排名","学校名称","省份","总分", chr(12288)))
        f.write('\n')
    for i in range(num):
        u = ulist[i]
        print(tplt.format(u[0], u[1], u[2],u[3],chr(12288)))
        with open('save.txt', 'a', encoding='utf-8') as f:
            f.write(tplt.format(u[0], u[1], u[2],u[3],chr(12288)))
            f.write('\n')

def main():
    with open('save.txt', 'w+', encoding='utf-8') as f:
        f.write("排名,学校,省份,总分\n")
        f.close()
    uinfo = []
    url = 'https://www.shanghairanking.cn/rankings/bcur/2021'
    html = getHTMLText(url)
    fillUnivList(uinfo, html)
    printUnivList(uinfo, 20)
main()
程序运行后的输出结果如下:
以上就是关于使用Python爬取中国大学排名信息的完整教程,更多相关Python爬虫及大学排名数据抓取的内容,欢迎查阅本站历史文章或继续浏览后续内容,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















