


基于Python3开发带GUI界面的小说爬虫工具

发布时间:2026-10-15 |
3人浏览过
本文介绍如何使用Python3结合PySimpleGUI库开发一款带图形界面的小说爬虫工具。该工具支持多线程并发采集、代理IP设置及线程数限制,能够高效抓取笔趣阁小说内容并打包为exe文件。
效果图
近期协助朋友编写了一个简易爬虫程序,并在此基础上完善开发,最终形成了一款具备图形用户界面(GUI)的小说爬虫工具,主要用于从笔趣阁网站抓取小说数据。
开发完成后的界面
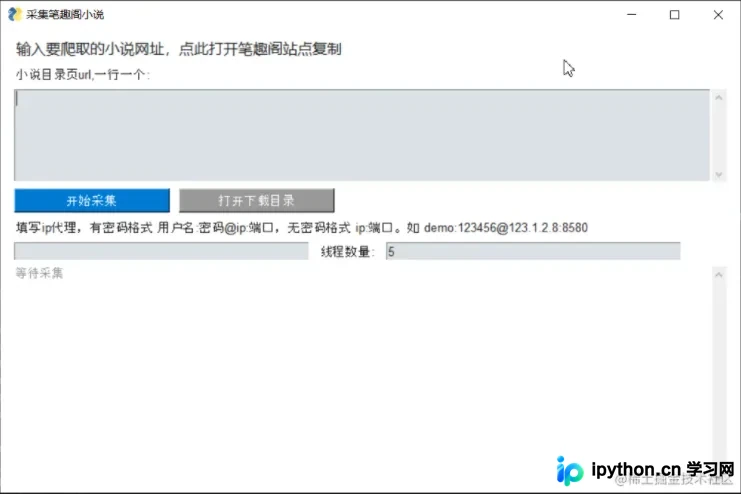
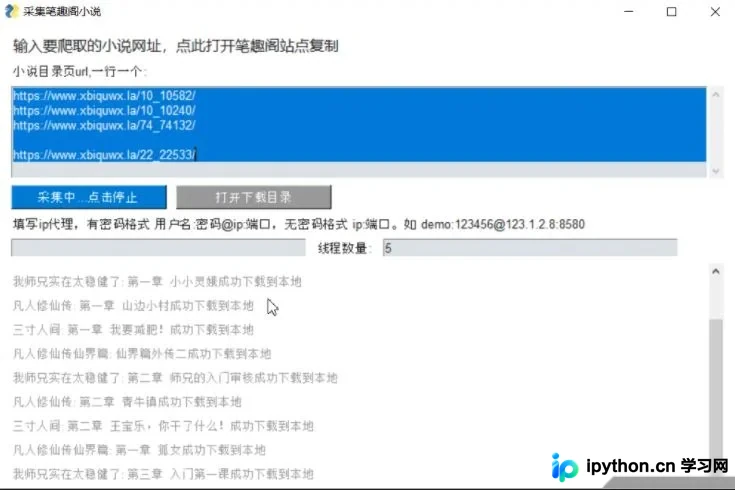
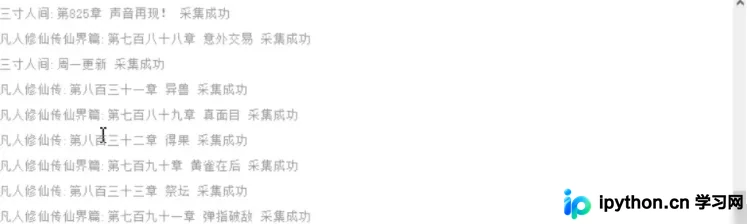
采集过程界面
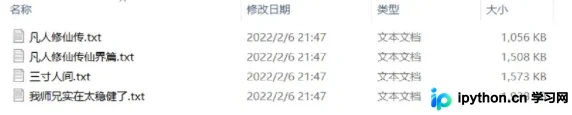
采集后存储
主要功能
1. 采用多线程采集机制,每个线程负责单独处理一本小说的抓取任务。
2. 支持配置代理服务器,特别是在启用多线程采集时,若不使用代理可能导致IP被封禁。
3. 实时输出采集进度与结果。
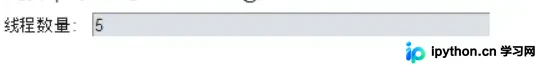
利用 threading.BoundedSemaphore() pool_sema.acquire() pool_sema.release() 来限制并发线程的数量,以避免过多的并发请求导致服务器压力过大或触发风控。具体的线程数量限制可在软件界面中自定义输入,默认设置为5个线程。
# 所有线程任务开始前
pool_sema.threading.BoundedSemaphore(5)

# 具体每个线程开始前 锁
pool_sema.acquire()
....
# 线程任务执行结束释放
pol_sema.release()
用到的第三方模块
pip install requests
pip install pysimplegui
pip install lxml
pip install pyinstaller
GUI界面开发选用了一个基于tkinter封装的库 PySimpleGUI,其使用便捷性较高。尽管界面美观度有限,但胜在结构简单,非常适合用于快速开发小型工具。例如,上述界面的布局仅需通过简单的列表定义即可实现。
layout = [
        [sg.Text('输入要爬取的小说网址,点此打开笔趣阁站点复制', font=("微软雅黑", 12),
                 key="openwebsite", enable_events=True, tooltip="点击在浏览器中打开")],
        [sg.Text("小说目录页url,一行一个:")],
        [
            sg.Multiline('', key="url", size=(120, 6), autoscroll=True, expand_x=True, right_click_menu=['&Right', ['粘贴']]
                         )
        ],
        [sg.Text(visible=False, text_color="#ff0000", key="error")],
        [
            sg.Button(button_text='开始采集', key="start", size=(20, 1)),
            sg.Button(button_text='打开下载目录', key="opendir",
                      size=(20, 1), button_color="#999999")
        ],
        [sg.Text('填写ip代理,有密码格式 用户名:密码@ip:端口,无密码格式 ip:端口。如 demo:123456@123.1.2.8:8580')],
        [
            sg.Input('', key="proxy"),
            sg.Text('线程数量:'),
            sg.Input('5', key="threadnum"),
        ],
        [
            sg.Multiline('等待采集', key="res", disabled=True, border_width=0, background_color="#ffffff", size=(
                120, 6), no_scrollbar=False, autoscroll=True, expand_x=True, expand_y=True, font=("宋体", 10), text_color="#999999")
        ],
    ]
打包为 exe 命令
pyinstaller -Fw start.py
全部源码
import time
import requests
import os
import sys
import re
import random
from lxml import etree
import webbrowser
import PySimpleGUI as sg
import threading


# user-agent
header = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/97.0.4692.99 Safari/537.36"
}
# 代理
proxies = {}
# 删除书名中特殊符号
# 笔趣阁基地址
baseurl = 'https://www.xbiquwx.la/'
# 线程数量
threadNum = 6
pool_sema = None
THREAD_EVENT = '-THREAD-'
cjstatus = False

# txt存储目录
filePath = os.path.abspath(os.path.join(os.getcwd(), 'txt'))
if not os.path.exists(filePath):
    os.mkdir(filePath)

# 删除特殊字符
def deletetag(text):
    return re.sub(r'[\[\]#\/\\:*\,;\?\"\'<>\|\(\)《》&\^!~=%\{\}@!:。·!¥……() ]','',text)

# 入口
def main():
    global cjstatus, proxies, threadNum, pool_sema
    sg.theme("reddit")
    layout = [
        [sg.Text('输入要爬取的小说网址,点此打开笔趣阁站点复制', font=("微软雅黑", 12),
                 key="openwebsite", enable_events=True, tooltip="点击在浏览器中打开")],
        [sg.Text("小说目录页url,一行一个:")],
        [
            sg.Multiline('', key="url", size=(120, 6), autoscroll=True, expand_x=True, right_click_menu=['&Right', ['粘贴']]
                         )
        ],
        [sg.Text(visible=False, text_color="#ff0000", key="error")],
        [
            sg.Button(button_text='开始采集', key="start", size=(20, 1)),
            sg.Button(button_text='打开下载目录', key="opendir",
                      size=(20, 1), button_color="#999999")
        ],
        [sg.Text('填写ip代理,有密码格式 用户名:密码@ip:端口,无密码格式 ip:端口。如 demo:123456@123.1.2.8:8580')],
        [
            sg.Input('', key="proxy"),
            sg.Text('线程数量:'),
            sg.Input('5', key="threadnum"),
        ],
        [
            sg.Multiline('等待采集', key="res", disabled=True, border_width=0, background_color="#ffffff", size=(
                120, 6), no_scrollbar=False, autoscroll=True, expand_x=True, expand_y=True, font=("宋体", 10), text_color="#999999")
        ],
    ]
    window = sg.Window('采集笔趣阁小说', layout, size=(800, 500), resizable=True,)
    while True:
        event, values = window.read()
        if event == sg.WIN_CLOSED or event == 'close':  # if user closes window or clicks cancel
            break
        if event == "openwebsite":
            webbrowser.open('%s' % baseurl)
        elif event == 'opendir':
            os.system('start explorer ' + filePath)
        elif event == 'start':
            if cjstatus:
                cjstatus = False
                window['start'].update('已停止...点击重新开始')
                continue
            window['error'].update("", visible=False)
            urls = values['url'].strip().split("\n")
            lenth = len(urls)
            for k, url in enumerate(urls):
                if (not re.match(r'%s\d+_\d+/' % baseurl, url.strip())):
                    if len(url.strip()) > 0:
                        window['error'].update("地址错误:%s" % url, visible=True)
                    del urls[k]

            if len(urls) < 1:
                window['error'].update(
                    "每行地址需符合 %s84_84370/ 形式" % baseurlr, visible=True)
                continue
            # 代理
            if len(values['proxy']) > 8:
                proxies = {
                    "http": "http://%s" % values['proxy'],
                    "https": "http://%s" % values['proxy']
                }
            # 线程数量
            if values['threadnum'] and int(values['threadnum']) > 0:
                threadNum = int(values['threadnum'])
            pool_sema = threading.BoundedSemaphore(threadNum)
            cjstatus = True
            window['start'].update('采集中...点击停止')
            window['res'].update('开始采集')

            for url in urls:
                threading.Thread(target=downloadbybook, args=(
                    url.strip(), window,), daemon=True).start()
        elif event == "粘贴":
            window['url'].update(sg.clipboard_get())

        print("event", event)
        if event == THREAD_EVENT:
            strtext = values[THREAD_EVENT][1]
            window['res'].update(window['res'].get()+"\n"+strtext)
    cjstatus = False
    window.close()

#下载
def downloadbybook(page_url, window):
    try:
        bookpage = requests.get(url=page_url, headers=header, proxies=proxies)
    except Exception as e:
        window.write_event_value(
            '-THREAD-', (threading.current_thread().name, '\n请求 %s 错误,原因:%s' % (page_url, e)))
        return
    if not cjstatus:
        return
    # 锁线程
    pool_sema.acquire()

    if bookpage.status_code != 200:
        window.write_event_value(
            '-THREAD-', (threading.current_thread().name, '\n请求%s错误,原因:%s' % (page_url, page.reason)))
        return

    bookpage.encoding = 'utf-8'
    page_tree = etree.HTML(bookpage.text)
    bookname = page_tree.xpath('//div[@id="info"]/h1/text()')[0]
    bookfilename = filePath + '/' + deletetag(bookname)+'.txt'
    zj_list = page_tree.xpath(
        '//div[@class="box_con"]/div[@id="list"]/dl/dd')
    for _ in zj_list:
        if not cjstatus:
            break
        zjurl = page_url + _.xpath('./a/@href')[0]
        zjname = _.xpath('./a/@title')[0]
        try:
            zjpage = requests.get(
                zjurl, headers=header, proxies=proxies)
        except Exception as e:
            window.write_event_value('-THREAD-', (threading.current_thread(
            ).name, '\n请求%s:%s错误,原因:%s' % (zjname, zjurl, zjpage.reason)))
            continue

        if zjpage.status_code != 200:
            window.write_event_value('-THREAD-', (threading.current_thread(
            ).name, '\n请求%s:%s错误,原因:%s' % (zjname, zjurl, zjpage.reason)))
            return

        zjpage.encoding = 'utf-8'
        zjpage_content = etree.HTML(zjpage.text).xpath('//div[@id="content"]/text()')
        content = "\n【"+zjname+"】\n"
        for _ in zjpage_content:
            content += _.strip() + '\n'
        with open(bookfilename, 'a+', encoding='utf-8') as fs:
            fs.write(content)
            window.write_event_value(
                '-THREAD-', (threading.current_thread().name, '\n%s:%s 采集成功' % (bookname, zjname)))
        time.sleep(random.uniform(0.05, 0.2))

    # 下载完毕
    window.write_event_value('-THREAD-', (threading.current_thread(
    ).name, '\n请求 %s 结束' % page_url))
    pool_sema.release()


if __name__ == '__main__':
    main()
以上就是基于Python3制作一个带GUI界面的小说爬虫工具的详细内容,更多关于Python3小说爬虫工具的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















