


Python实现微信公众号文章图片批量下载与PDF生成工具

发布时间:2026-10-15 |
3人浏览过
本文介绍了一款基于Python的微信公众号文章图片抓取与PDF转换工具。该工具支持自动解析文章中的图片链接并批量下载,利用fpdf库将图片按原始比例整合为PDF文档,同时添加序号以便查阅。文章提供了完整的代码逻辑说明及操作示例,帮助开发者快速实现图文内容的本地化归档。
工具功能介绍与版本更新
面对包含大量图片的微信公众号文章,手动逐一保存显得繁琐低效。应朋友需求,笔者开发了一款自动化抓取工具。目前2.0版本已上线,主要优化了PDF生成功能:系统可根据图片原始比例自动调整页面布局,防止内容溢出;同时增加了图片序号显示,方便用户浏览和查找。
核心代码实现逻辑
#-----------------settings---------------
#url='https://mp.weixin.qq.com/s/8JwB_SXQ-80uwQ9L97BMgw'
print('jd3096 for king 2.0 VIP8钻石永久会员版')
print('愿你远离流氓软件每一天')
url=input('请输入网址:')
#-----------------get data----------------
import requests
import re
from bs4 import BeautifulSoup
import os
from PIL import Image

try:
    os.makedirs('pics')
except:
    pass

os.chdir('pics')

page=requests.get(url).text
soup = BeautifulSoup(page, 'html.parser')
jdata = soup.find_all('img')
pn=0
for i in jdata:
    try:
        src=i['data-src']
        print(src)
        rp = requests.get(src)
        with open(str(pn)+'.jpg','wb+')as f : # 循环写入图片
            print(str(pn)+'.jpg')
            f.write(rp.content)
        pn+=1
    except:
        pass
#--------------------make pdf--------------------
from fpdf import FPDF
import os
path=os.getcwd()
print(path)
pdf = FPDF()
pdf.set_auto_page_break(1)
imagelist = [i for i in os.listdir()]
imagelist.sort(key=lambda x: int(x.split('.')[0]))
print(imagelist)
for image in imagelist:
    try:
        img = Image.open(image)
        w = img.width       #图片的宽
        h = img.height      #图片的高
        ii=h/w
        print(ii)
        if ii>1.41:
            ww=int(250/ii)
            pdf.add_page()
            pdf.set_xy(0,0)
            pdf.set_font('arial','B',14)
            pdf.cell(60)
            pdf.cell(70,10,image,border=0, ln=1, align='C')
            pdf.image(os.path.join(path, image), w=ww, h=250)
        else:
            hh=int(180*ii)
            pdf.add_page()
            pdf.set_xy(0,0)
            pdf.set_font('arial','B',14)
            pdf.cell(60)
            pdf.cell(70,10,image,border=0, ln=1, align='C')
            pdf.image(os.path.join(path, image), w=180, h=hh)
    except:
        pass

pdf.output(os.path.join(path, "merge.pdf"), "F")
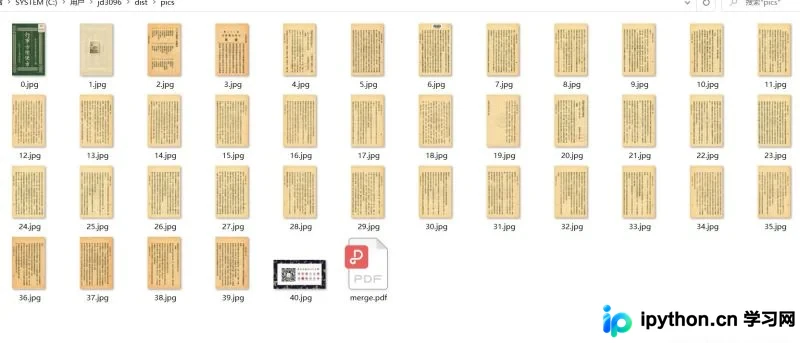
抓取结果展示
抓取完成后的本地文件列表如下所示:
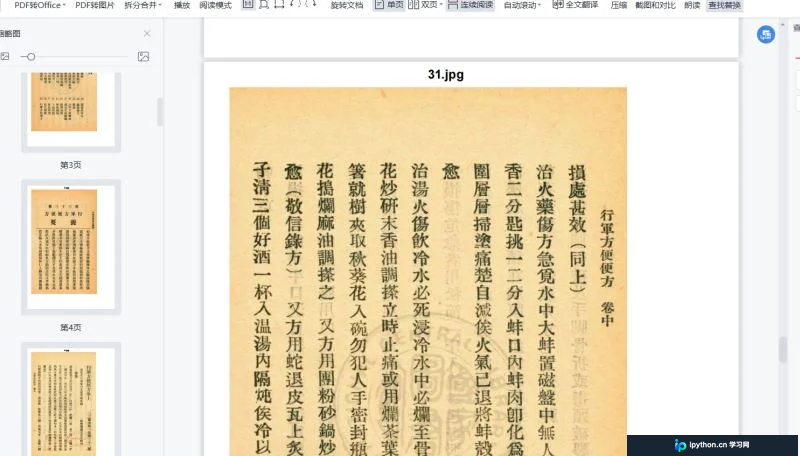
PDF生成效果
生成的PDF文档效果如上图所示,图片比例适中,阅读体验良好。
以上就是关于使用Python爬取微信公众号文章图片并转换为PDF的完整介绍。如需了解更多相关技术细节,欢迎查阅本站历史文章或继续浏览后续内容,感谢大家的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















