


Python实现王者荣耀全皮肤批量下载:16行代码详解

本文介绍如何使用Python通过16行代码批量下载王者荣耀高清皮肤。教程涵盖获取英雄列表JSON、解析皮肤URL规则、利用urllib.urlretrieve下载及文件管理逻辑,帮助开发者快速掌握基础爬虫技巧。
Python批量下载王者荣耀皮肤教程
如今许多手游玩家对《王者荣耀》情有独钟,其中精美的皮肤设计更是让人爱不释手。你是否曾想过将这些高清皮肤保存下来,用作电脑或手机壁纸,效果如同下图所示?
本文将指导大家使用Python编写仅16行核心代码,实现《王者荣耀》所有高清皮肤的批量下载。
具体操作流程主要包含两个关键步骤:
第一步是定位皮肤图片的URL地址;
第二步则是执行图片下载操作。
获取英雄列表数据
1. 定位皮肤图片地址 1. 获取英雄列表数据
首先访问百度搜索“王者荣耀”进入官方网站 https://pvp.qq.com/。以Google Chrome浏览器为例,通过“更多工具”菜单打开开发者工具,或直接按下F12键进入调试模式,随后按F5刷新页面。
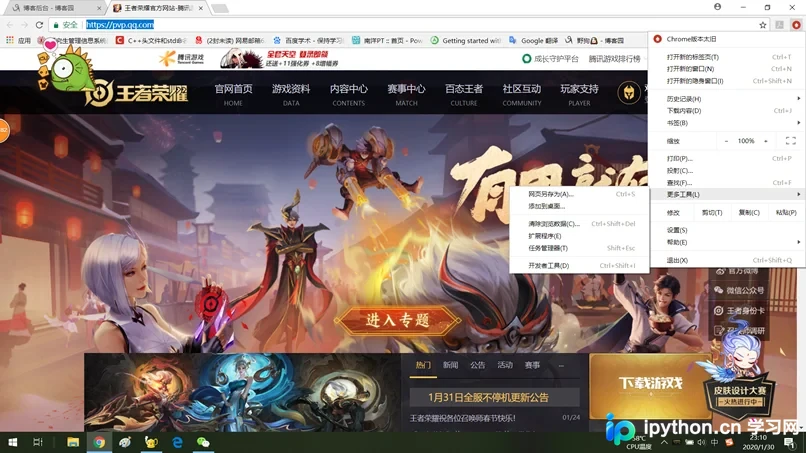
图中高亮显示的herolist.json文件即为我们需要的英雄列表数据源,其中包含了英雄编号、名称、类型以及皮肤名称等详细信息。右键点击该文件复制链接,地址为:http://pvp.qq.com/web201605/js/herolist.json
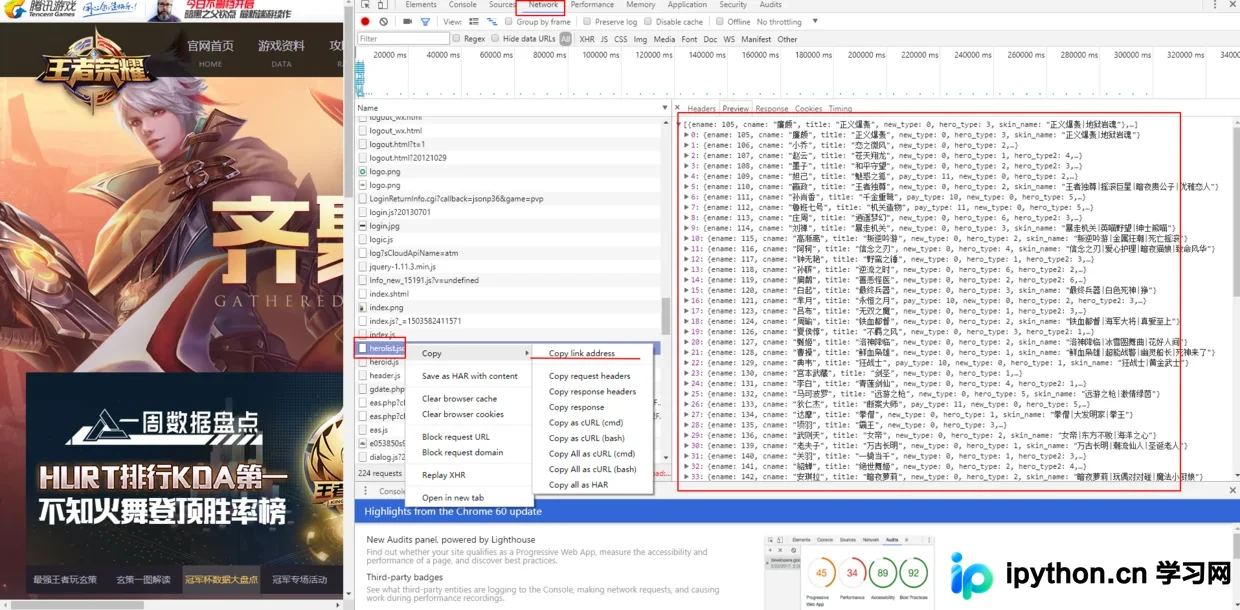
接下来通过代码验证我们获取的地址是否正确,参考代码1:
import urllib.request
import json
import os

response = urllib.request.urlopen("http://pvp.qq.com/web201605/js/herolist.json")

hero_json = json.loads(response.read())
hero_num = len(hero_json)

print(hero_json)
print("hero_num : " , str(hero_num))
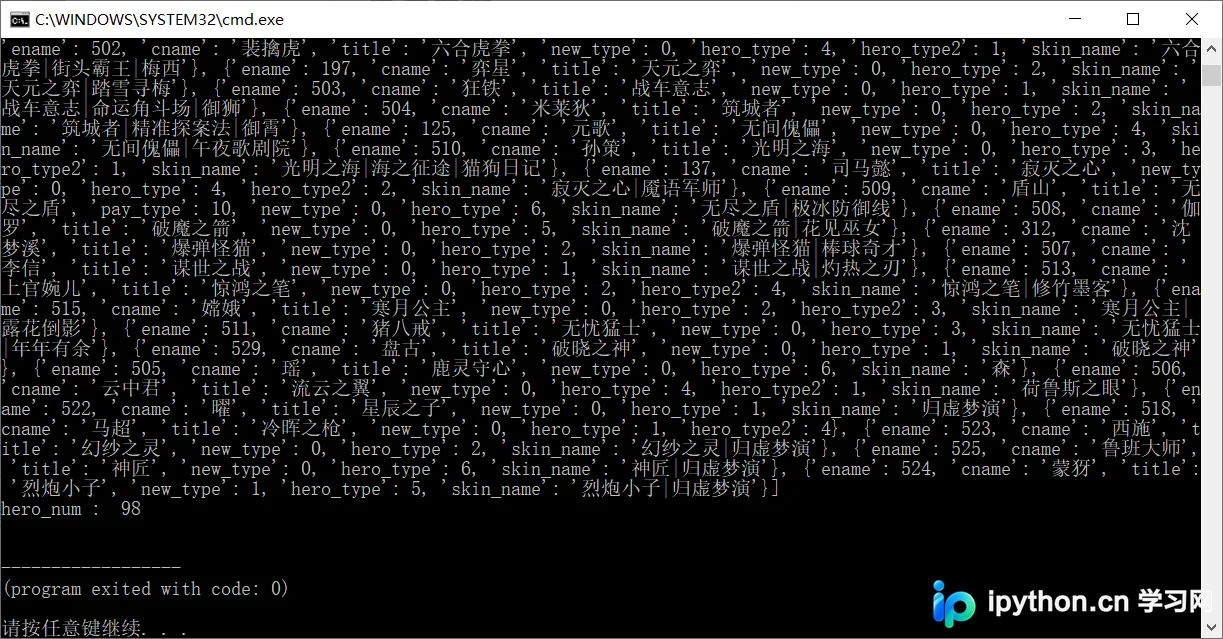
上述代码负责读取英雄列表数据并存储至变量hero_json中,同时统计英雄总数。运行效果如下图所示:
解析英雄皮肤URL地址
2. 解析英雄皮肤URL地址
点击首页的“游戏资料”标签页,进入新页面后随意点击一个英雄头像进入详情页面,此处以李白为例。同样使用F12打开调试工具并按F5刷新,将鼠标悬停在李白的不同皮肤上依次划过,
观察调试窗口中的网络请求记录。
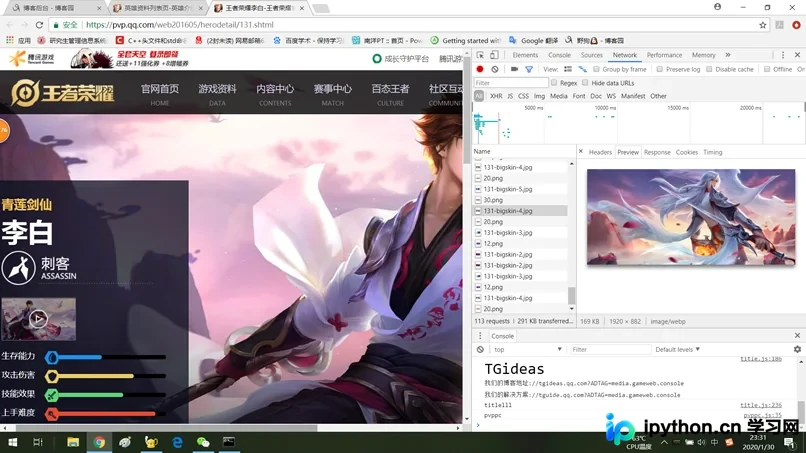
可以看到李白的皮肤图片共有5个。我们在任意一个皮肤图片上右键复制链接,得到如下地址:
https://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/131/131-bigskin-5.jpg
这便是我们需要获取的英雄皮肤图片链接。
分析该链接结构可以发现,其中‘131’代表英雄编号,而末尾的‘-5’则表示该英雄的第几个皮肤。至此,浏览器端所需的关键信息已全部获取完毕。
执行图片下载逻辑
2. 执行图片下载 1. 确定英雄皮肤数量
在第一步获取的herolist.json文件中存在'skin_name'字段,解析该字段即可获取皮肤的数量与具体名称。测试代码接续代码1,见代码2:
hero_name = hero_json[0]['cname']
skin_names = hero_json[0]['skin_name'].split('|')
skin_num = len(skin_names)

print('hero_name: ', hero_name)
print('skin_names :', skin_names)
print('skin_num: ' + str(skin_num))
测试后的运行结果如下所示:
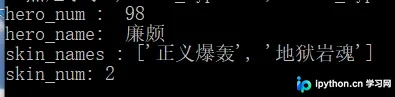
结果显示廉颇共有两个皮肤,名称分别为:正义爆轰和地狱岩魂。
2. 执行文件下载
下载文件功能依赖于urlretrieve接口,同时需考虑以下两个逻辑问题:
1. 检查目标文件夹是否存在,若不存在则自动创建;
save_dir = 'D:\heroskin\\'
if not os.path.exists(save_dir):
os.mkdir(save_dir)
2. 检查本地图片文件是否已存在,若存在则跳过下载以避免重复。
if not os.path.exists(save_file_name):
urllib.request.urlretrieve(skin_url, save_file_name)
代码3如下所示:
save_dir = 'D:\heroskin\\'
if not os.path.exists(save_dir):
 os.mkdir(save_dir)
 for i in range(hero_num):
  # 获取英雄皮肤列表
  skin_names = hero_json[i]['skin_name'].split('|')
  for cnt in range(len(skin_names)):
   save_file_name = save_dir + str(hero_json[i]['ename']) + '-' +hero_json[i]['cname']+ '-' +skin_names[cnt] + '.jpg'
   skin_url = 'http://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/'+str(hero_json[i]['ename'])+ '/' +str(hero_json[i]['ename'])+'-bigskin-' + str(cnt+1) +'.jpg'
   print(skin_url)
   if not os.path.exists(save_file_name):
    urllib.request.urlretrieve(skin_url, save_file_name)
总结
以下是完整的代码实现,去除注释和空行后共计16行代码,成功实现了下载《王者荣耀》全部高清皮肤的功能:
import urllib.request
import json
import os

response = urllib.request.urlopen("http://pvp.qq.com/web201605/js/herolist.json")
hero_json = json.loads(response.read())
hero_num = len(hero_json)
save_dir = 'D:\heroskin\\'
if not os.path.exists(save_dir):
 os.mkdir(save_dir)
 for i in range(hero_num):
  # 获取英雄皮肤列表
  skin_names = hero_json[i]['skin_name'].split('|')
  for cnt in range(len(skin_names)):
   save_file_name = save_dir + str(hero_json[i]['ename']) + '-' +hero_json[i]['cname']+ '-' +skin_names[cnt] + '.jpg'
   skin_url = 'http://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/'+str(hero_json[i]['ename'])+ '/' +str(hero_json[i]['ename'])+'-bigskin-' + str(cnt+1) +'.jpg'
   print(skin_url)
   if not os.path.exists(save_file_name):
    urllib.request.urlretrieve(skin_url, save_file_name)
运行后的效果如图所示:
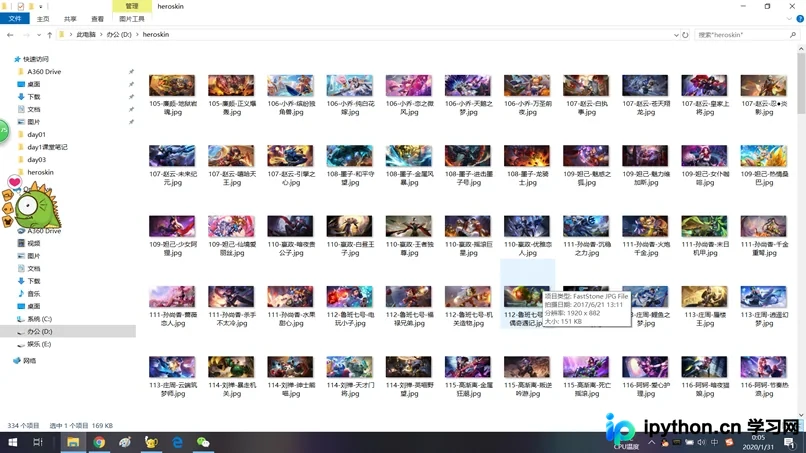
由此可见,掌握一门编程语言的重要性不言而喻。
上述知识点较为基础,如果大家有任何补充建议,欢迎联系本站编辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















