


详解Pandas的三大利器(map,apply,applymap)

本文深入解析Pandas中处理数据的三大核心函数:map、apply和applymap。通过模拟数据演示,详细对比三者在Series与DataFrame上的应用差异,涵盖性别映射、数值运算及BMI计算等实际案例,帮助开发者高效完成数据清洗与转换任务。
在实际的数据处理工作中,我们常需对数据框中的单行、多行(列同理)乃至整个数据集执行统一的转换逻辑。例如,将“sex”字段中的“男”替换为1,“女”替换为0,这类批量操作是数据预处理中的常见需求。
面对此类需求,初学者往往首先想到使用for循环。虽然这种方式直观且易于理解,但其运行效率较低,尤其在处理大规模数据时性能瓶颈明显。为此,本文重点介绍Pandas中高效解决此类需求的三大工具:map、apply和applymap。
- map
- apply
- applymap
模拟数据
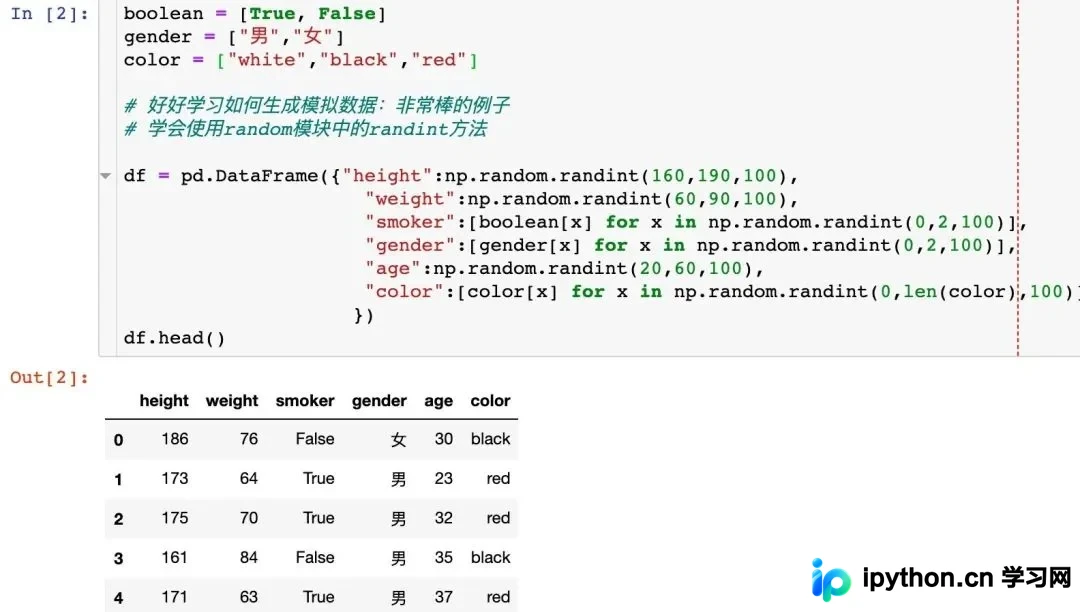
为了清晰展示这三个函数的具体用法,我们构建一个包含多种数据类型的模拟数据集。通过该示例,读者可以掌握如何生成各类模拟数据。具体数据结构如下:
import pandas as pd
import numpy as np

boolean = [True, False]
gender = ["男","女"]
color = ["white","black","red"]

# 好好学习如何生成模拟数据:非常棒的例子
# 学会使用random模块中的randint方法

df = pd.DataFrame({"height":np.random.randint(160,190,100),
                     "weight":np.random.randint(60,90,100),
                     "smoker":[boolean[x] for x in np.random.randint(0,2,100)],
                     "gender":[gender[x] for x in np.random.randint(0,2,100)],
                     "age":np.random.randint(20,60,100),
                     "color":[color[x] for x in np.random.randint(0,len(color),100)]
                    })
df.head()
1、map
demo
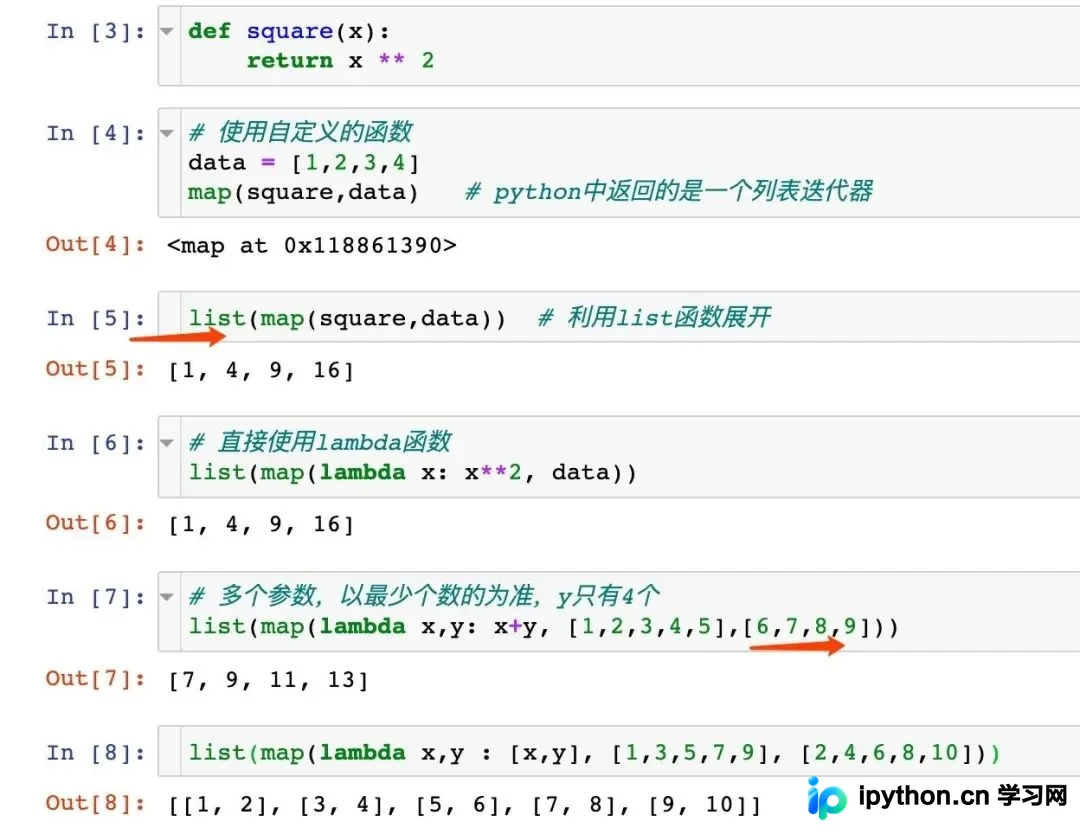
map()函数的核心作用是对指定序列进行映射操作。
该函数接收两个主要参数:function和iterable。它会遍历序列中的每个元素,调用提供的function函数,并返回一个包含每次调用返回值的新列表。
map(function, iterable)
实际数据
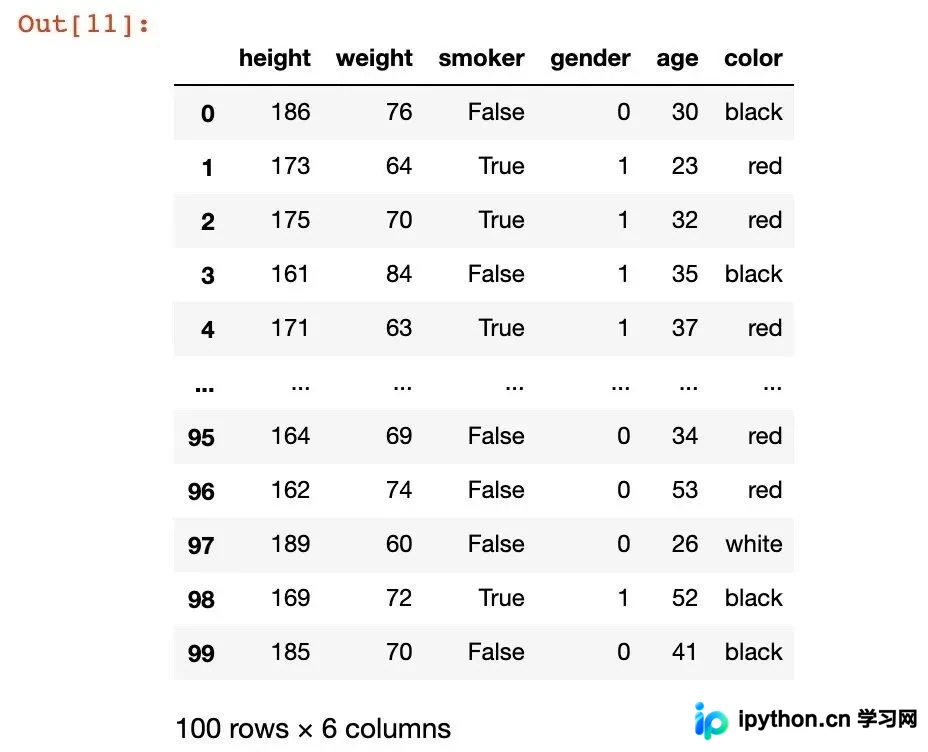
以实际数据为例,我们需要将“gender”列中的“男”转换为1,“女”转换为0。
# 方式1:通过字典映射实现
dic = {"男":1, "女":0}  # 通过字典映射
df1 = df.copy()   # 副本,不破坏原来的数据df
df1["gender"] = df1["gender"].map(dic)
df1

# 方式2:通过函数实现
def map_gender(x):
    gender = 1 if x == "男" else 0
    return gender

df2 = df.copy()
# 将df["gender"]这个S型数据中的每个数值传进去
df2["gender"] = df2["gender"].map(map_gender)
df2
2、apply
apply方法的作用机制与map类似,但其优势在于能够接收功能更复杂的函数,因此可视为map的高级版本。
Pandas的apply()函数可作用于Series或整个DataFrame。其工作原理是自动遍历Series或DataFrame中的每个元素,并对每个元素执行指定的函数操作。
在DataFrame的多数方法中,存在一个axis参数,用于控制操作沿0轴(列columns)还是1轴(行row)进行。其中,axis=0表示对列执行操作,axis=1表示对行执行操作。
demo
基于上述数据,我们将“age”字段的值统一减去3(即加上-3)。
def apply_age(x,bias):
    return x + bias

df4 = df.copy()
# df4["age"]当做第一个值传给apply_age函数,args是第二个参数
df4["age"] = df4["age"].apply(apply_age,args=(-3,))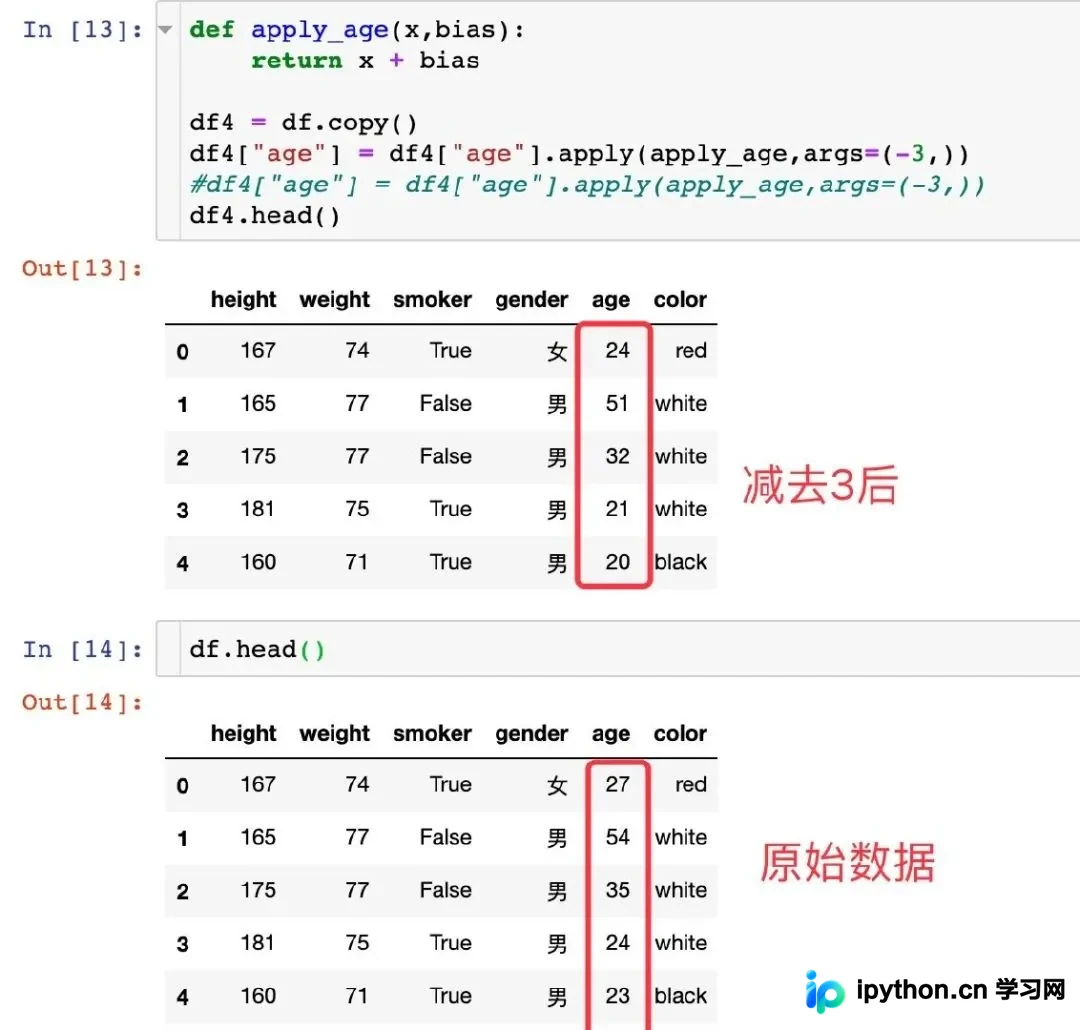
计算BMI指数
# 实现计算BMI指数:体重/身高的平方(kg/m^2)
def BMI(x):
    weight = x["weight"]
    height = x["height"] / 100
    BMI = weight / (height **2)

    return BMI

df5 = df.copy()
df5["BMI"] = df5.apply(BMI,axis=1)  # df5现在就相当于BMI函数中的参数x;axis=1表示在列上操作
df5
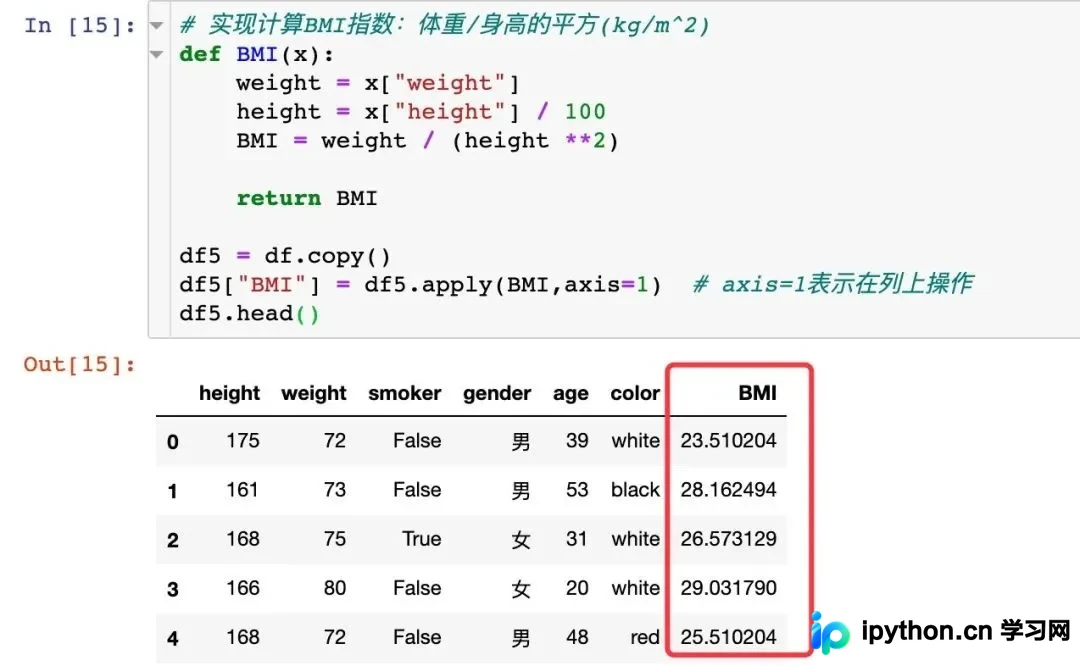
针对DataFrame型数据的apply操作,可总结为以下几点:
- 当axis=0时,对每一列columns执行指定函数;当axis=1时,对每一行row执行指定函数。
- 无论axis取0还是1,传入指定函数的默认形式均为Series对象。若需传入numpy数组,可通过设置raw=True实现。
- 对每个Series执行函数后,结果会被整合并返回。若需保留计算结果,定义函数时必须包含相应的return语句。
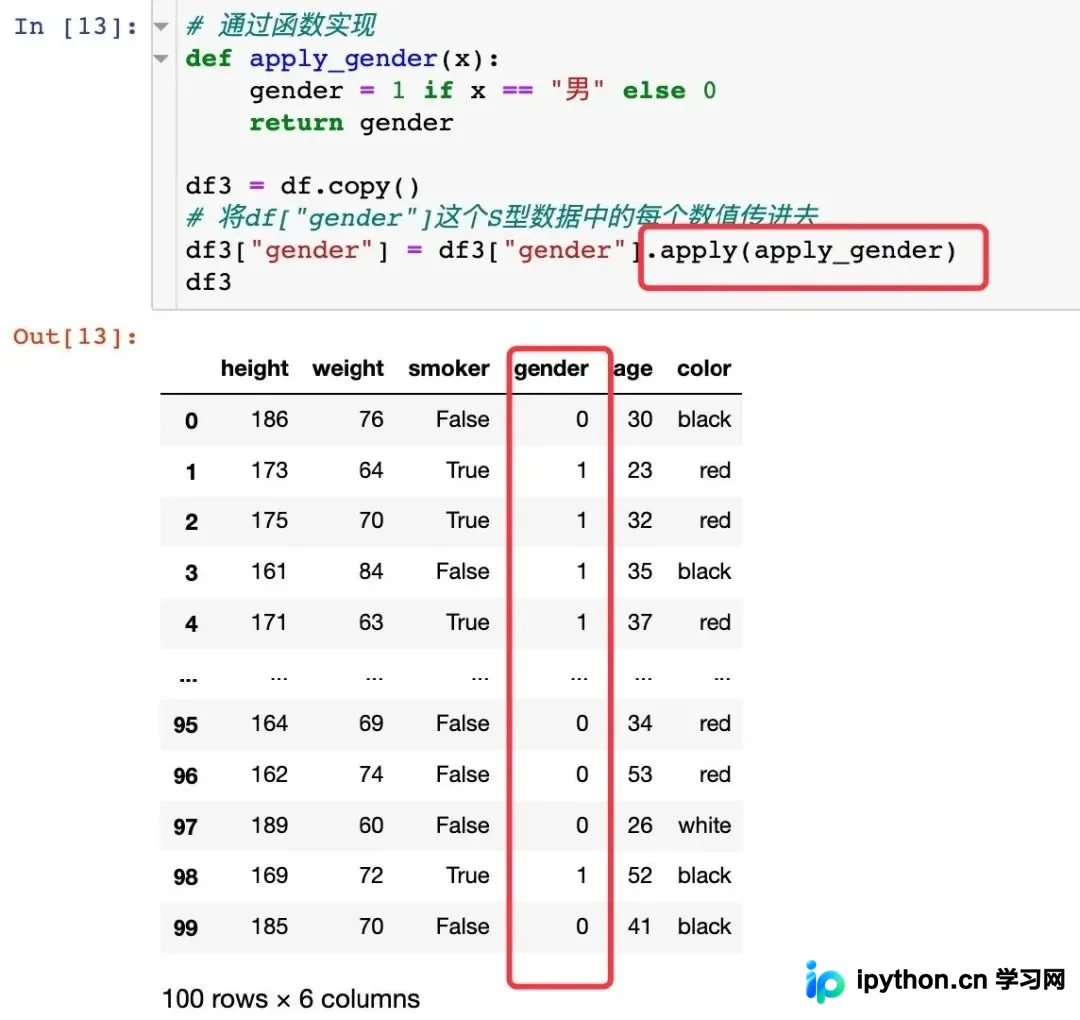
apply实现需求
接下来,我们通过apply方法实现前述的性别转换需求。需注意,apply方法接收的第一个参数必须是一个函数。
3、applymap
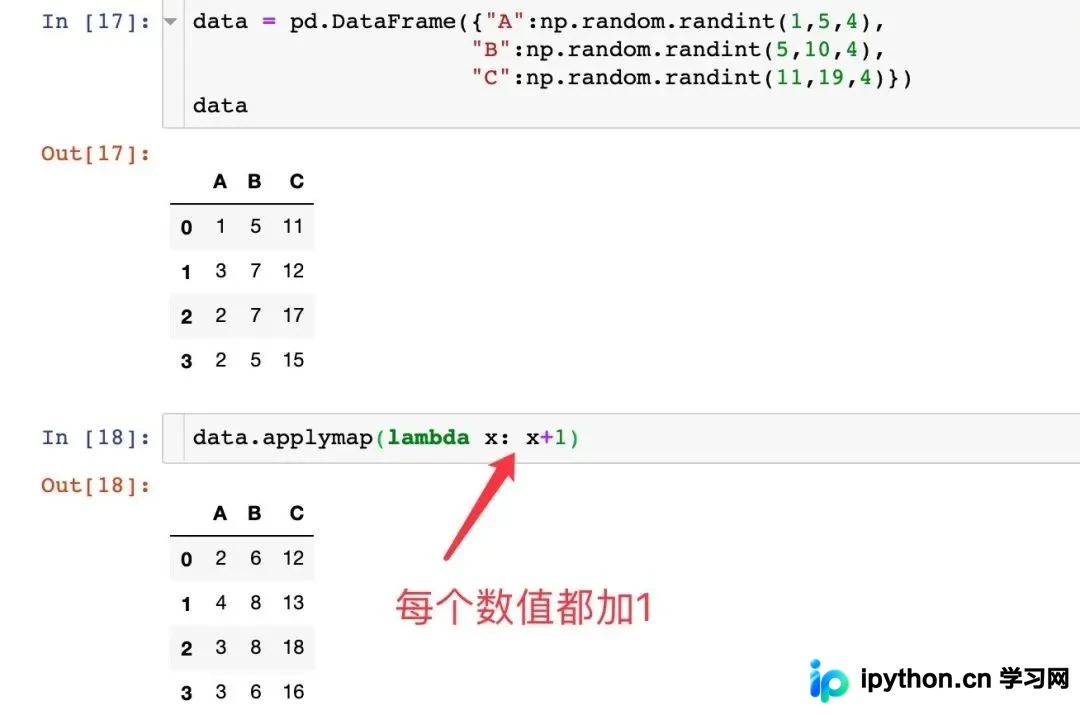
DF数据加1
applymap函数用于对DataFrame型数据中的每个元素执行相同的函数操作,例如对所有元素加1:
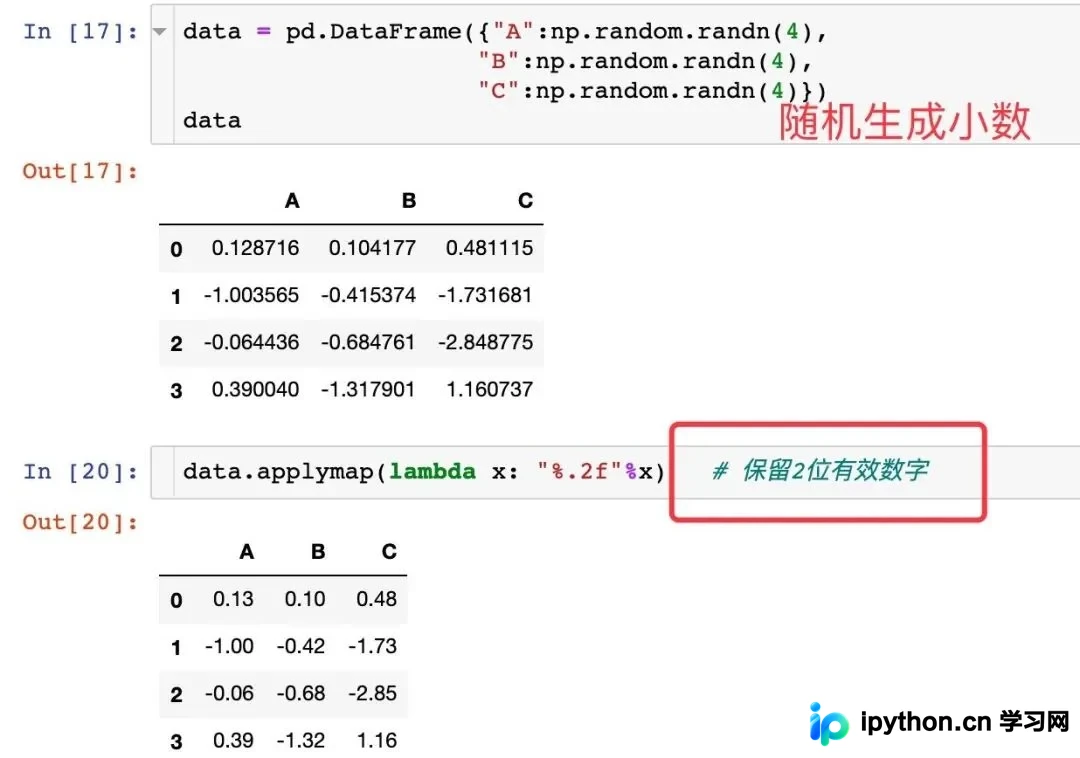
保留2位有效数字
至此,关于Pandas三大核心函数map、apply和applymap的详细解析已介绍完毕。如需了解更多相关内容,可查阅本站过往文章或继续浏览后续内容,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















