


Python DataFrame分组统计groupby()函数详解与实战

本文详细介绍Python中Pandas库DataFrame数据分组统计的核心函数groupby()。内容涵盖基础的一级与多级分类求和、指定列索引统计、分组数据迭代遍历,以及结合agg()函数实现多列不同聚合计算和自定义函数应用。此外,还演示了如何利用字典和Series对象进行灵活分组,帮助开发者高效处理复杂数据分析任务。
groupby()函数
在Python的DataFrame中进行数据分组统计时,主要依赖groupby()函数来实现。
1. groupby基本用法
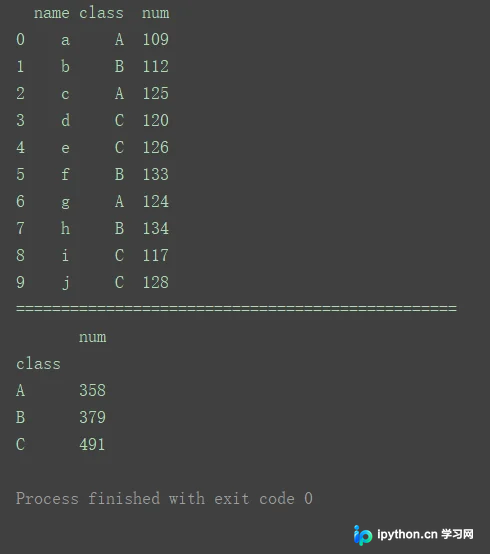
1.1 一级分类_分组求和
import pandas as pd
data = [['a', 'A', 109], ['b', 'B', 112], ['c', 'A', 125], ['d', 'C', 120],
        ['e', 'C', 126], ['f', 'B', 133], ['g', 'A', 124], ['h', 'B', 134],
        ['i', 'C', 117], ['j', 'C', 128]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
columns = ['name', 'class', 'num']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("=================================================")
df1 = df.groupby('class').sum()       # 分组统计求和
print(df1)
1.2 二级分类_分组求和
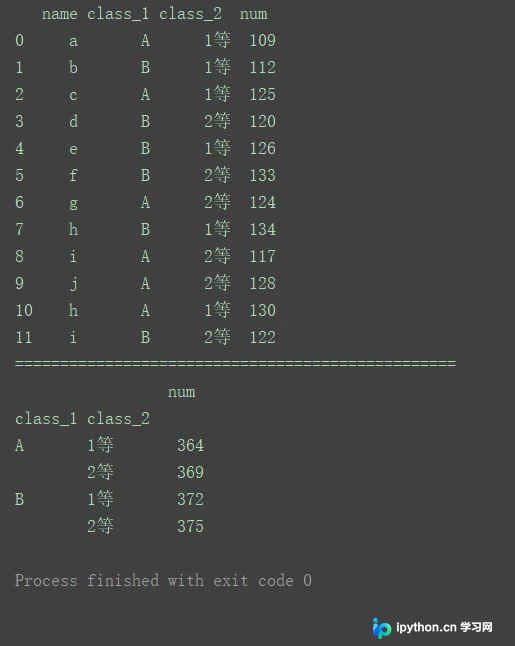
向groupby()传入包含分类字段的列表,列表元素从左至右代表分类层级逐渐升高(如一级分类、二级分类等)。
import pandas as pd
data = [['a', 'A', '1等', 109], ['b', 'B', '1等', 112], ['c', 'A', '1等', 125], ['d', 'B', '2等', 120],
        ['e', 'B', '1等', 126], ['f', 'B', '2等', 133], ['g', 'A', '2等', 124], ['h', 'B', '1等', 134],
        ['i', 'A', '2等', 117], ['j', 'A', '2等', 128], ['h', 'A', '1等', 130], ['i', 'B', '2等', 122]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
columns = ['name', 'class_1', 'class_2', 'num']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("=================================================")
df1 = df.groupby(['class_1', 'class_2']).sum()       # 分组统计求和
print(df1)
1.3 对DataFrameGroupBy对象列名索引(对指定列统计计算)
执行df.groupby('class_1')会返回一个DataFrameGroupBy对象,可通过列名索引该对象以针对特定列进行统计。例如:df.groupby('class_1')['num'].sum()。
import pandas as pd
data = [['a', 'A', '1等', 109], ['b', 'B', '1等', 112], ['c', 'A', '1等', 125], ['d', 'B', '2等', 120],
        ['e', 'B', '1等', 126], ['f', 'B', '2等', 133], ['g', 'A', '2等', 124], ['h', 'B', '1等', 134],
        ['i', 'A', '2等', 117], ['j', 'A', '2等', 128], ['h', 'A', '1等', 130], ['i', 'B', '2等', 122]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
columns = ['name', 'class_1', 'class_2', 'num']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("=================================================")
df1 = df.groupby('class_1')['num'].sum()
print(df1)
代码运行结果与前述示例一致。
2. 对分组数据进行迭代
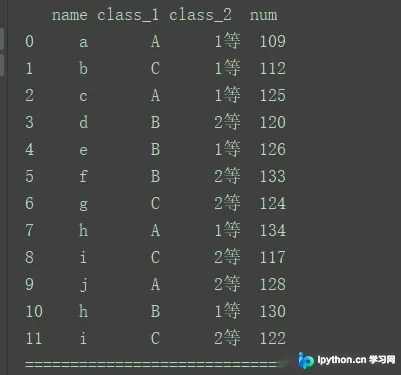
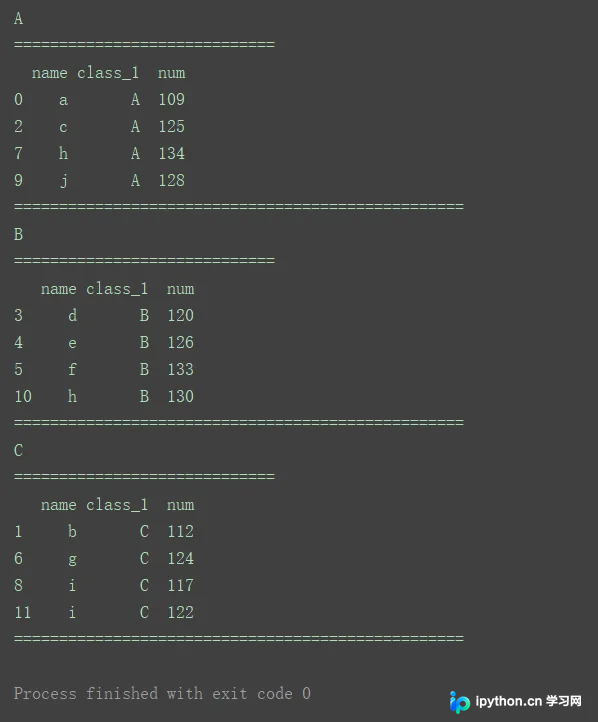
2.1 对一级分类的DataFrameGroupBy对象进行遍历
语法格式为:for name, group in DataFrameGroupBy_object。
其中,name表示分类的类别名称,group则包含该类别下的所有数据记录。
import pandas as pd
data = [['a', 'A', '1等', 109], ['b', 'C', '1等', 112], ['c', 'A', '1等', 125], ['d', 'B', '2等', 120],
        ['e', 'B', '1等', 126], ['f', 'B', '2等', 133], ['g', 'C', '2等', 124], ['h', 'A', '1等', 134],
        ['i', 'C', '2等', 117], ['j', 'A', '2等', 128], ['h', 'B', '1等', 130], ['i', 'C', '2等', 122]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
columns = ['name', 'class_1', 'class_2', 'num']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("===============================")

# 获取目标数据。
df1 = df[['name', 'class_1', 'num']]
for name, group in df1.groupby('class_1'):
        print(name)
        print("=============================")
        print(group)
        print("==================================================")
2.2 对二级分类的DataFrameGroupBy对象进行遍历
以遍历二级分类的DataFrameGroupBy对象为例,使用for (key1, key2), group in df.groupby(['class_1', 'class_2'])。与一级分类不同,(key1, key2)是一个包含多级类别的元组,而group表示该多级分类下的具体数据。
import pandas as pd
data = [['a', 'A', '1等', 109], ['b', 'C', '1等', 112], ['c', 'A', '1等', 125], ['d', 'B', '2等', 120],
        ['e', 'B', '1等', 126], ['f', 'B', '2等', 133], ['g', 'C', '2等', 124], ['h', 'A', '1等', 134],
        ['i', 'C', '2等', 117], ['j', 'A', '2等', 128], ['h', 'B', '1等', 130], ['i', 'C', '2等', 122]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
columns = ['name', 'class_1', 'class_2', 'num']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("===============================")


for (key1, key2), group in df.groupby(['class_1', 'class_2']):
        print(key1, key2)
        print("=============================")
        print(group)
        print("==================================================")
程序运行结果如下:
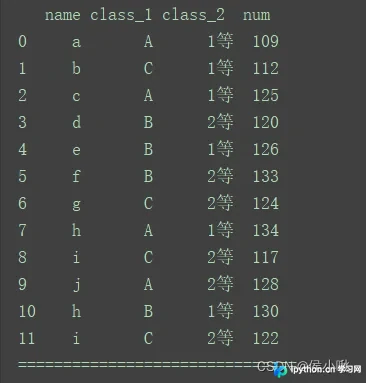
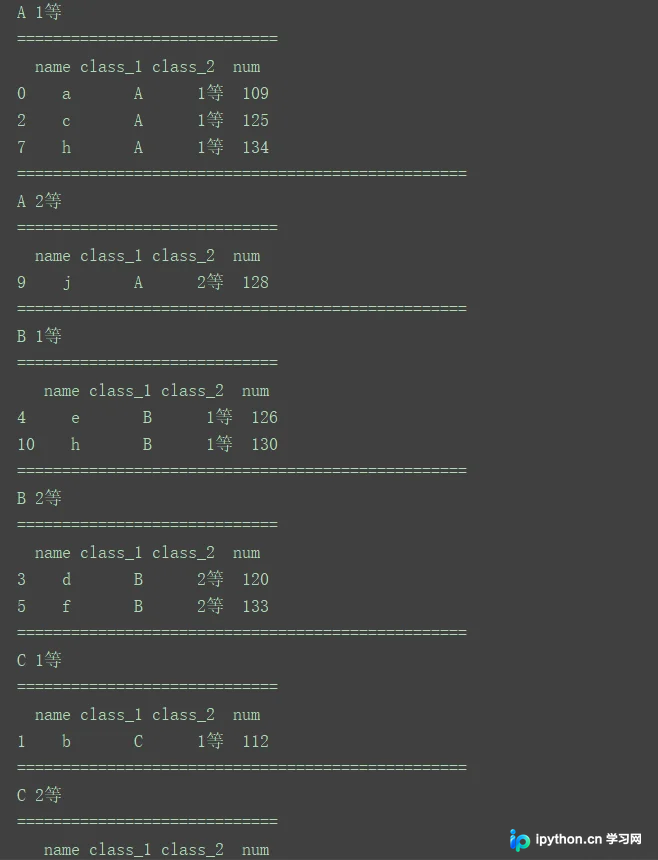
(部分输出)
3. agg()函数
结合groupby()与agg()函数可实现分组聚合运算。
3.1一般写法_对目标数据使用同一聚合函数
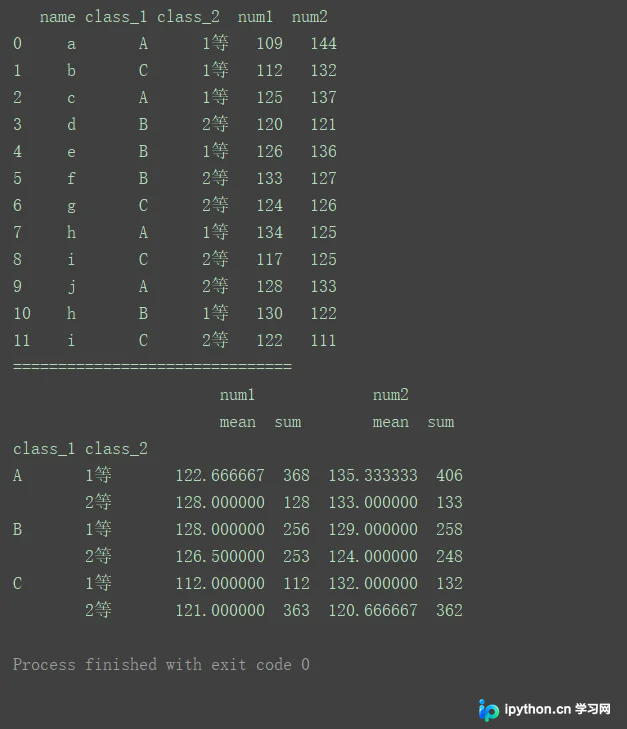
以计算分组均值和求和为例。
向agg()传入一个列表即可。
df1.groupby(['class_1', 'class_2']).agg(['mean', 'sum'])。
import pandas as pd
data = [['a', 'A', '1等', 109, 144], ['b', 'C', '1等', 112, 132], ['c', 'A', '1等', 125, 137], ['d', 'B', '2等', 120, 121],
        ['e', 'B', '1等', 126, 136], ['f', 'B', '2等', 133, 127], ['g', 'C', '2等', 124, 126], ['h', 'A', '1等', 134, 125],
        ['i', 'C', '2等', 117, 125], ['j', 'A', '2等', 128, 133], ['h', 'B', '1等', 130, 122], ['i', 'C', '2等', 122, 111]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
columns = ['name', 'class_1', 'class_2', 'num1', 'num2']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("===============================")
df1 = df[['class_1', 'class_2', 'num1', 'num2']]
print(df1.groupby(['class_1', 'class_2']).agg(['mean', 'sum']))
3.2 对不同列使用不同聚合函数
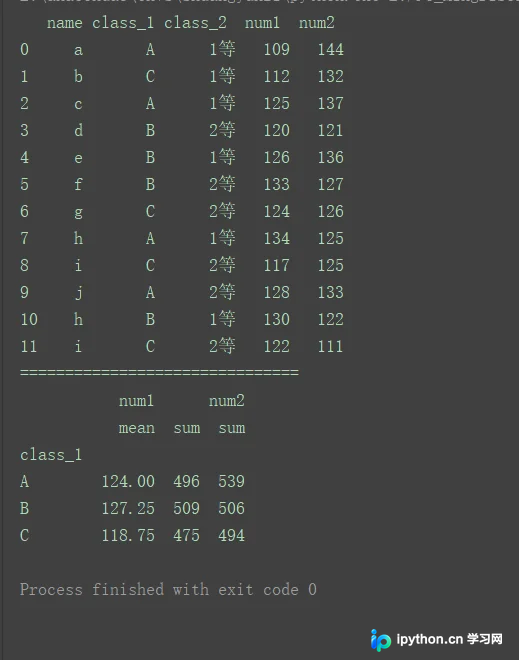
向agg()方法传入一个字典来指定不同列的聚合方式。
import pandas as pd
data = [['a', 'A', '1等', 109, 144], ['b', 'C', '1等', 112, 132], ['c', 'A', '1等', 125, 137], ['d', 'B', '2等', 120, 121],
        ['e', 'B', '1等', 126, 136], ['f', 'B', '2等', 133, 127], ['g', 'C', '2等', 124, 126], ['h', 'A', '1等', 134, 125],
        ['i', 'C', '2等', 117, 125], ['j', 'A', '2等', 128, 133], ['h', 'B', '1等', 130, 122], ['i', 'C', '2等', 122, 111]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
columns = ['name', 'class_1', 'class_2', 'num1', 'num2']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("===============================")
df1 = df[['class_1', 'num1', 'num2']]
print(df1.groupby('class_1').agg({'num1': ['mean', 'sum'], 'num2': ['sum']}))
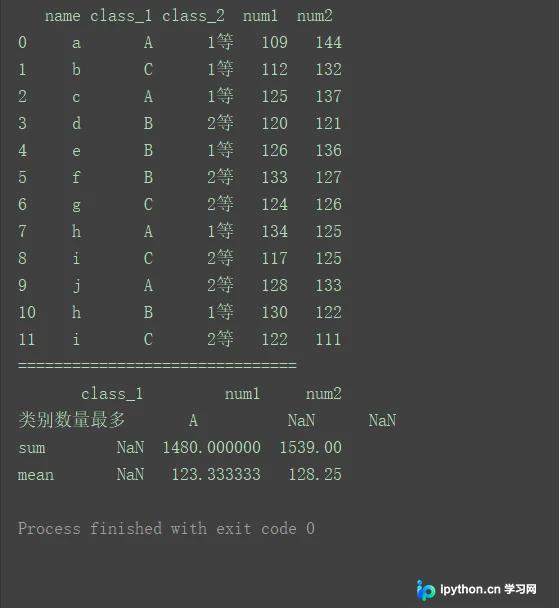
3.3 自定义函数写法
还可以定义自定义函数(例如名为max1),并将其传入agg()中使用。
import pandas as pd
data = [['a', 'A', '1等', 109, 144], ['b', 'C', '1等', 112, 132], ['c', 'A', '1等', 125, 137], ['d', 'B', '2等', 120, 121],
        ['e', 'B', '1等', 126, 136], ['f', 'B', '2等', 133, 127], ['g', 'C', '2等', 124, 126], ['h', 'A', '1等', 134, 125],
        ['i', 'C', '2等', 117, 125], ['j', 'A', '2等', 128, 133], ['h', 'B', '1等', 130, 122], ['i', 'C', '2等', 122, 111]]
index = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
columns = ['name', 'class_1', 'class_2', 'num1', 'num2']
df = pd.DataFrame(data=data, index=index, columns=columns)
print(df)
print("===============================")

max1 = lambda x: x.value_counts(dropna=False).index[0]
max1.__name__ = "类别数量最多"
df1 = df.agg({'class_1': [max1],
        'num1': ['sum', 'mean'],
        'num2': ['sum', 'mean']})
print(df1)
4. 通过 字典 和 Series 对象进行分组统计
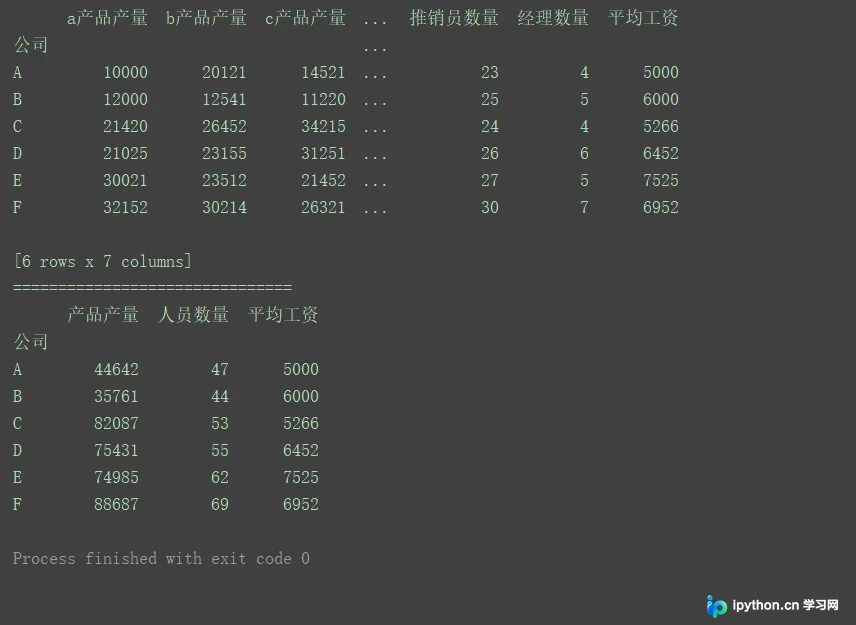
groupby()不仅支持传入单列或多列组成的列表,还可以传入字典或Series对象来实现分组操作。
4.1通过一个字典
import pandas as pd
data = [['A', 10000, 20121, 14521, 20, 23, 4, 5000],
        ['B', 12000, 12541, 11220, 14, 25, 5, 6000],
        ['C', 21420, 26452, 34215, 25, 24, 4, 5266],
        ['D', 21025, 23155, 31251, 23, 26, 6, 6452],
        ['E', 30021, 23512, 21452, 30, 27, 5, 7525],
        ['F', 32152, 30214, 26321, 32, 30, 7, 6952]]
columns = ['公司', 'a产品产量', 'b产品产量', 'c产品产量', '搬运工数量', '推销员数量', '经理数量', '平均工资']
pd.set_option('display.unicode.east_asian_width', True)
df = pd.DataFrame(data=data, columns=columns)
df = df.set_index(['公司'])
print(df)
print("===============================")

mapping = {
    'a产品产量': '产品产量', 'b产品产量': '产品产量',
    'c产品产量': '产品产量', '搬运工数量': '人员数量',
    '推销员数量': '人员数量', '经理数量': '人员数量',
    '平均工资': '平均工资'
}

df1 = df.groupby(mapping, axis=1).sum()
print(df1)
程序运行结果:
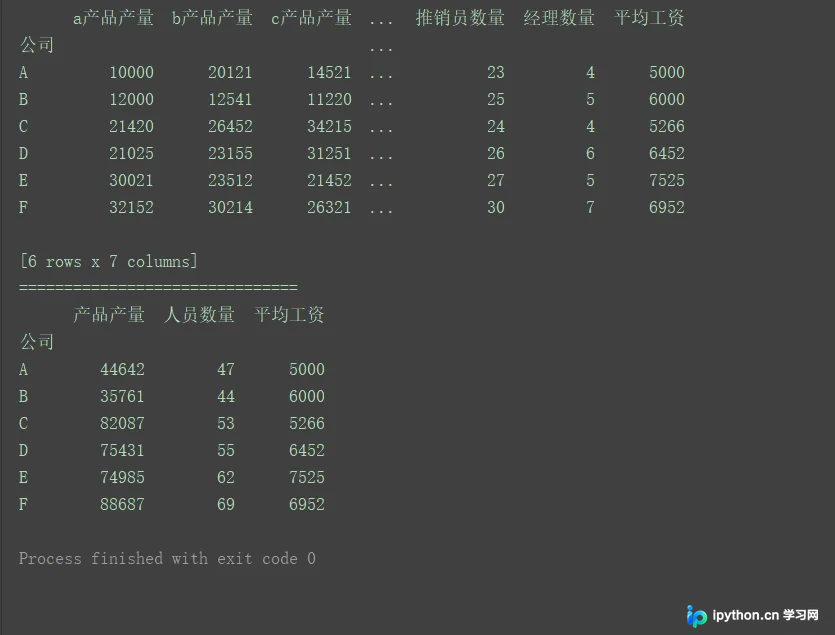
4.2通过一个Series
import pandas as pd
data = [['A', 10000, 20121, 14521, 20, 23, 4, 5000],
        ['B', 12000, 12541, 11220, 14, 25, 5, 6000],
        ['C', 21420, 26452, 34215, 25, 24, 4, 5266],
        ['D', 21025, 23155, 31251, 23, 26, 6, 6452],
        ['E', 30021, 23512, 21452, 30, 27, 5, 7525],
        ['F', 32152, 30214, 26321, 32, 30, 7, 6952]]
columns = ['公司', 'a产品产量', 'b产品产量', 'c产品产量', '搬运工数量', '推销员数量', '经理数量', '平均工资']
pd.set_option('display.unicode.east_asian_width', True)
df = pd.DataFrame(data=data, columns=columns)
df = df.set_index(['公司'])
print(df)
print("===============================")

data = {
    'a产品产量': '产品产量', 'b产品产量': '产品产量',
    'c产品产量': '产品产量', '搬运工数量': '人员数量',
    '推销员数量': '人员数量', '经理数量': '人员数量',
    '平均工资': '平均工资'
}
s1 = pd.Series(data)
df1 = df.groupby(s1, axis=1).sum()
print(df1)
程序运行结果:
参考资源: python数据分析从入门到精通 明日科技编著 清华大学出版社
到此这篇关于python DataFrame数据分组统计groupby()函数的使用的文章就介绍到这了,更多相关python DataFrame groupby() 内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















