


Python Pandas分割DataFrame中字符串及元组的实现方法

本文详解在Python Pandas中分割DataFrame数据的两种核心场景:字符串分割与元组拆分。通过str.split()结合expand参数可将地址字符串拆分为多级列;利用join()与split()组合可保留原数据并合并结果。此外,演示了使用apply(pd.Series)或join方法高效处理元组列,将其元素展开为独立列,适用于各类结构化数据清洗任务。
1.使用str.split()方法
利用Pandas内置的str.split()函数,可以直接对字符串类型的列进行分割操作,并将生成的结果直接写入DataFrame,以表格形式直观展示。
语法:
Series.str.split(pat=None, n=-1, expand=False)
参数说明:pat指定用于分割的字符串或正则表达式;n为整数,默认值为-1,表示分割次数无限制(即最大次数),若设为0或其他正整数则限制分割次数;expand为布尔值,默认为False,若设为True则将分割结果转换为DataFrame对象。
首先准备一组DataFrame数据:
import pandas as pd

pd.set_option('display.unicode.east_asian_width', True)
address = ['重庆 重庆市 南岸区 ',
           '江苏省 苏州市 吴江区 吴江经济技术开发区亨通路',
           '江苏省 苏州市 园区 苏州市工业园区唯亭镇阳澄湖大道维纳阳光花园',
           '重庆 重庆市 南岸区 长生桥镇茶园新区长电路',
           '安徽省 滁州市 明光市 三界镇中心街10001号',
           '山东省 潍坊市 寿光市 圣城街道潍坊科技学院',
           '吉林省 长春市 二道区 东盛街道彩虹风景',
           '福建省 厦门市 湖里区 江头街道厦门市湖里区祥店福满园小区',
           '山西省 吕梁市 离石区 滨河街道山西省吕梁市离石区后瓦师巷',
           '河南省 濮阳市 华龙区 中原路街道中原路与107国道交叉口东',
           '广东省 深圳市 宝安区 松岗街道松岗镇潭头第二工业区',
           '河北省 石家庄市 辛集市 辛集镇辛集市新皮革城7期125楼',
           '广东省 深圳市 宝安区 松岗街道松岗镇潭头第二工业区',
           '贵州省 贵阳市 花溪区 党武镇师范大学师大超市',
           '广东省 深圳市 福田区 沙头街道上沙龙秋村五十巷',
           '福建省 福州市 闽侯县 上街镇福州闽侯上街国宾大道',
           '湖北省 鄂州市 鄂城区 西山街道江碧路和馨居',
           '上海 上海市 松江区',
           '山东省 青岛市 市北区',
           '山西省 晋中市 灵石县',
           '浙江省 杭州市 余杭区']
df = pd.DataFrame()
df['address'] = address
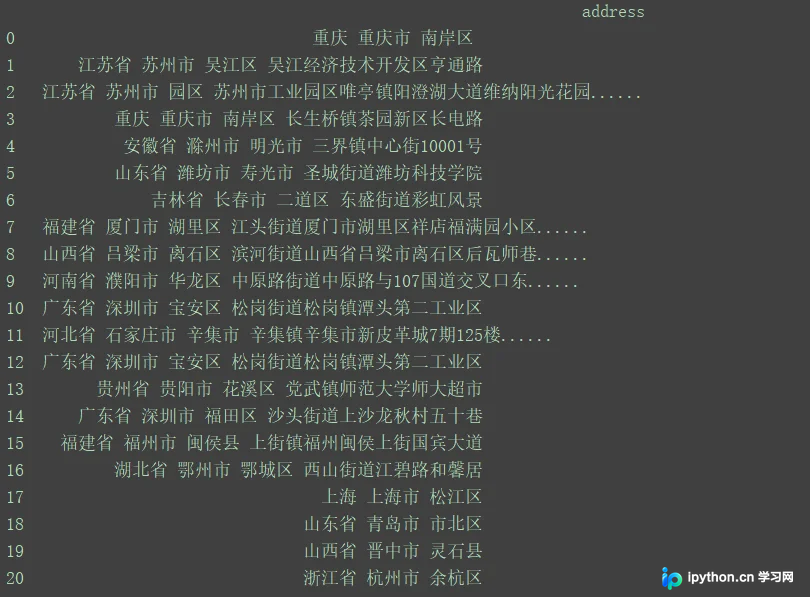
print(df)
原数据示例如下:
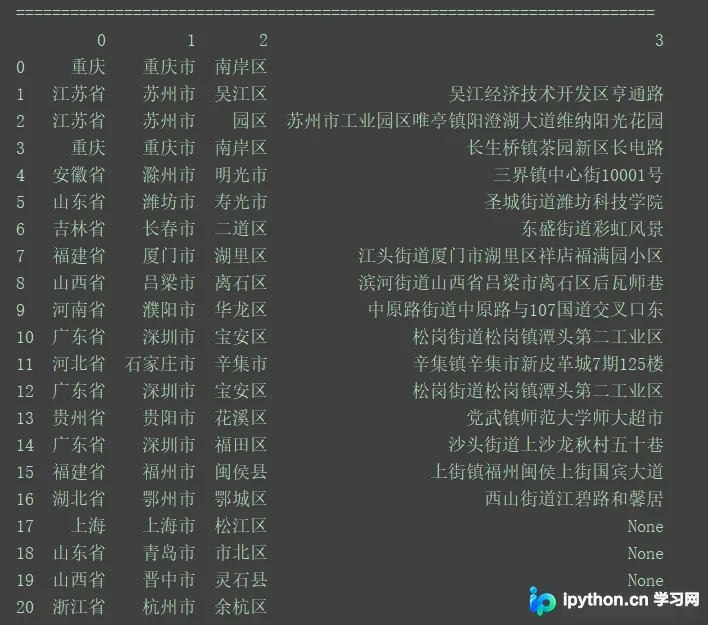
将address列按空格分割为不同的地理层级,结果生成一个DataFrame对象:
print("=======================================================================")
df1 = df['address'].str.split(' ', expand=True)
print(df1)
结果如下:
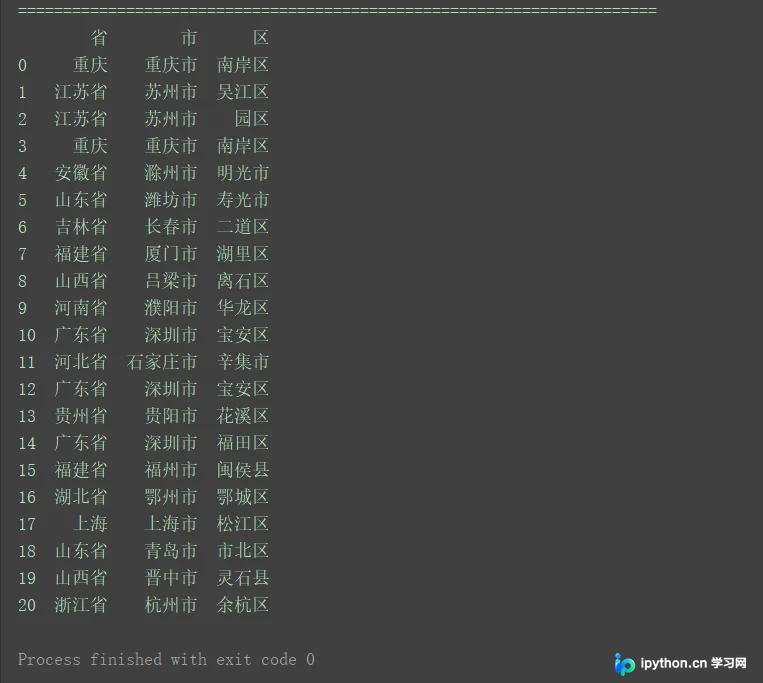
最后将分割后的结果合并回原DataFrame中。
df['省'] = series[0]
df['市'] = series[1]
df['区'] = series[2]
df = df[['省', '市', '区']]
print(df)
2.使用join()与split()方法结合
import pandas as pd

pd.set_option('display.unicode.east_asian_width', True)
address = ['重庆 重庆市 南岸区 ',
           '江苏省 苏州市 吴江区 吴江经济技术开发区亨通路',
           '江苏省 苏州市 园区 苏州市工业园区唯亭镇阳澄湖大道维纳阳光花园',
           '重庆 重庆市 南岸区 长生桥镇茶园新区长电路',
           '安徽省 滁州市 明光市 三界镇中心街10001号',
           '山东省 潍坊市 寿光市 圣城街道潍坊科技学院',
           '吉林省 长春市 二道区 东盛街道彩虹风景',
           '福建省 厦门市 湖里区 江头街道厦门市湖里区祥店福满园小区',
           '山西省 吕梁市 离石区 滨河街道山西省吕梁市离石区后瓦师巷',
           '河南省 濮阳市 华龙区 中原路街道中原路与107国道交叉口东',
           '广东省 深圳市 宝安区 松岗街道松岗镇潭头第二工业区',
           '河北省 石家庄市 辛集市 辛集镇辛集市新皮革城7期125楼',
           '广东省 深圳市 宝安区 松岗街道松岗镇潭头第二工业区',
           '贵州省 贵阳市 花溪区 党武镇师范大学师大超市',
           '广东省 深圳市 福田区 沙头街道上沙龙秋村五十巷',
           '福建省 福州市 闽侯县 上街镇福州闽侯上街国宾大道',
           '湖北省 鄂州市 鄂城区 西山街道江碧路和馨居',
           '上海 上海市 松江区',
           '山东省 青岛市 市北区',
           '山西省 晋中市 灵石县',
           '浙江省 杭州市 余杭区']
df = pd.DataFrame()
df['address'] = address
df = df.join(df['address'].str.split(' ', expand=True))
print(df)
运行结果同上。
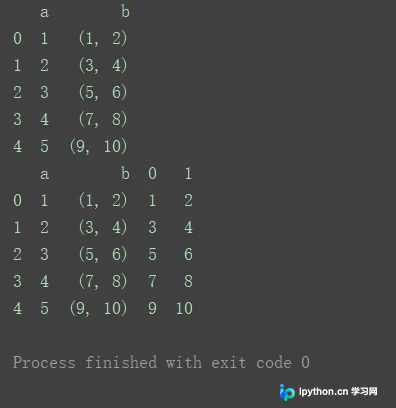
3. 使用apply方法分割元组
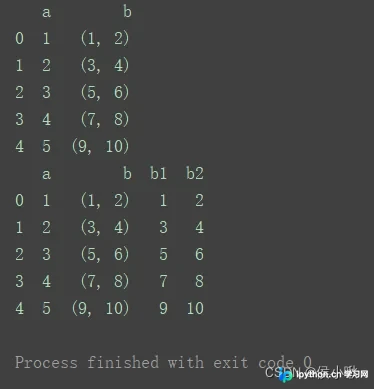
使用apply方法,将某个元素类型为元组的列,将其元组中的元素拆分为不同的列。
import pandas as pd

df = pd.DataFrame({'a': [1, 2, 3, 4, 5], 'b': [(1, 2), (3, 4), (5, 6), (7, 8), (9, 10)]})
print(df)
df[['b1', 'b2']] = df['b'].apply(pd.Series)
print(df)
或者也可以这样写:
import pandas as pd

df = pd.DataFrame({'a': [1, 2, 3, 4, 5], 'b': [(1, 2), (3, 4), (5, 6), (7, 8), (9, 10)]})
print(df)

df = df.join(df['b'].apply(pd.Series))
print(df)
参考资源: python数据分析从入门到精通 明日科技编著 清华大学出版社
到此这篇关于python pandas分割DataFrame中的字符串及元组的方法实现的文章就介绍到这了,更多相关python pandas分割DataFrame字符串及元组内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















