


详解Pandas中stack()和unstack()的使用技巧

本文深入解析Pandas中stack()和unstack()函数的核心用法。通过单层与多层索引案例,展示如何处理缺失值、指定堆叠层级及链式操作,帮助开发者高效完成DataFrame的行列转换与数据预处理。
介绍
Pandas 提供了多种用于重塑 DataFrame 结构的内置方法。其中,stack() 和 unstack() 是最常用的两种用于行列转换的技术:
- stack():将列转换为行进行堆叠
- unstack():将行转换为列进行取消堆叠
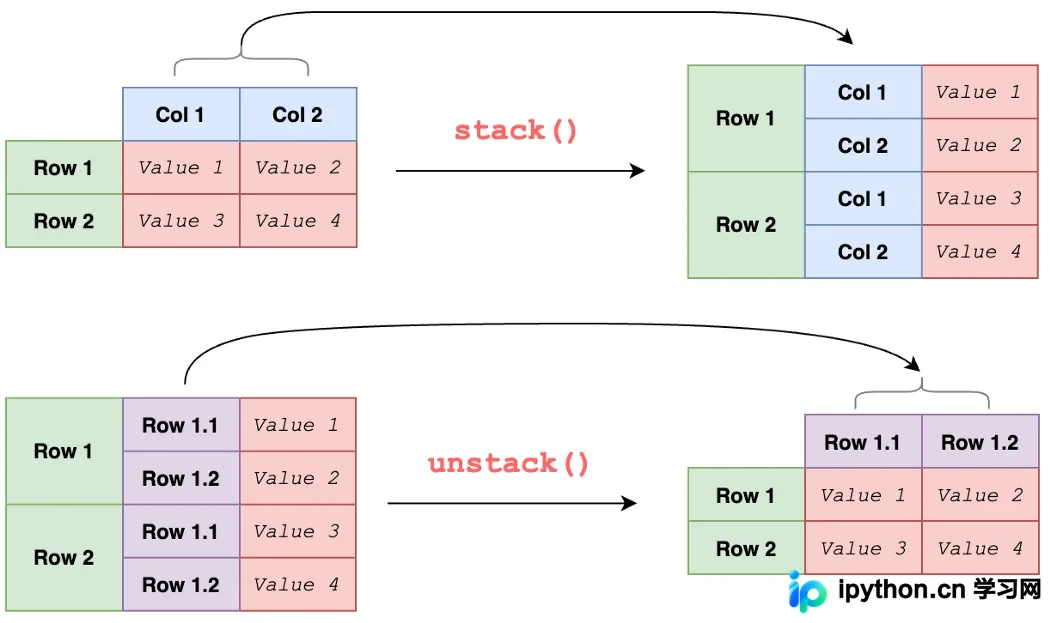
虽然 stack() 和 unstack() 的基本用法看似简单,但掌握一些进阶技巧能显著提升数据分析的效率。
本文将分享 Pandas 中 stack() 和 unstack() 的多个实用技巧:
- 单层索引处理
- 多层索引:基础案例
- 多层索引:处理缺失值
- 多层索引:指定堆叠层级
- 多层索引:移除缺失值
- unstack:基础案例
- unstack:进阶用法
1. 单层索引处理
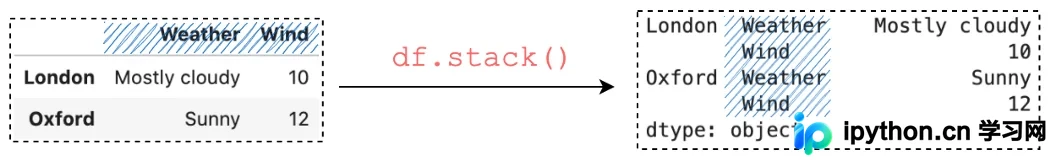
最简单的 stack() 应用适用于具有单层列标签的 DataFrame。该操作会将列标签堆叠至行轴,并返回一个 Series 对象。
df_single_level = pd.DataFrame(
    [['Mostly cloudy', 10], ['Sunny', 12]],
    index=['London', 'Oxford'],
    columns=['Weather', 'Wind']
)
df_single_level.stack()
2. 多层索引:基础案例
通常情况下,我们会对具有多级列(MultiIndex columns)的 DataFrame 使用 stack()。
首先创建一个示例 DataFrame。构建多级列 DataFrame 有多种方式,其中一种简便方法是利用 MultiIndex.from_tuples() 创建 MultiIndex 对象,并将其作为 columns 参数传入 pd.DataFrame():
multi_col_1 = pd.MultiIndex.from_tuples(
    [('Wind', 'mph'), ('Wind', 'm/s')]
)
df_multi_level_1 = pd.DataFrame(
    [[13, 5.5], [19, 8.5]],
    index=['London', 'Oxford'],
    columns=multi_col_1
)
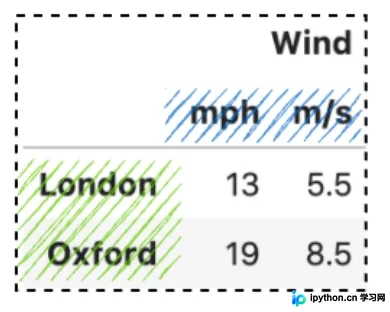
调用 stack() 后,函数会获取列层级(如 mph 和 m/s)并将其堆叠到行轴上。
df_multi_level_1.stack()
# Same as
df_multi_level_1.stack(level=-1)
df_multi_level_1.stack(-1)
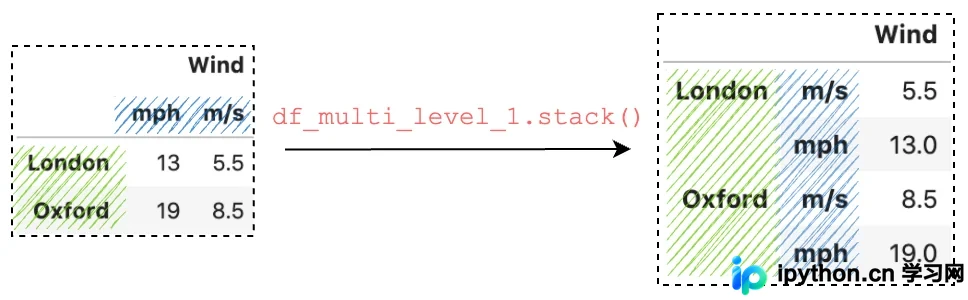
在底层实现中,该操作依据 level 参数执行。level 参数默认值为 -1,表示选取最内层索引,并将其从列轴堆叠到行轴。
3. 多层索引:处理缺失值
在对具有多级列的 DataFrame 进行堆叠时,常会出现缺失值。以下是一个示例 DataFrame:
multi_col_2 = pd.MultiIndex.from_tuples(
    [('Wind', 'mph'), ('Temperature', '°C')]
)
df_multi_level_2 = pd.DataFrame(
    [[13, 8], [19, 6]],
    index=['London', 'Oxford'],
    columns=multi_col_2
)
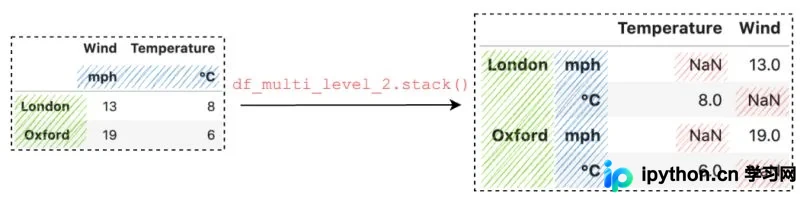
df_multi_level_2.stack()
与前例 multi_col_1 在第一级仅包含“Wind”不同,multi_col_2 的第一级包含“Wind”和“Temperature”两个不同值。由于堆叠后的 DataFrame 包含更多组合值,未出现的组合将以 NaN 填充,从而产生缺失值。
4. 多层索引:指定堆叠层级
stack() 的第一个参数 level 用于控制具体堆叠的层级。以下创建一个包含两个不同级别的 MultiIndex:
multi_col_2 = pd.MultiIndex.from_tuples(
    [('Wind', 'mph'), ('Temperature', '°C')]
)
# Level 0
multi_col_2.get_level_values(0)
# Index(['Wind', 'Temperature'], dtype='object')
# Level 1
multi_col_2.get_level_values(1)
# Index(['mph', '°C'], dtype='object')
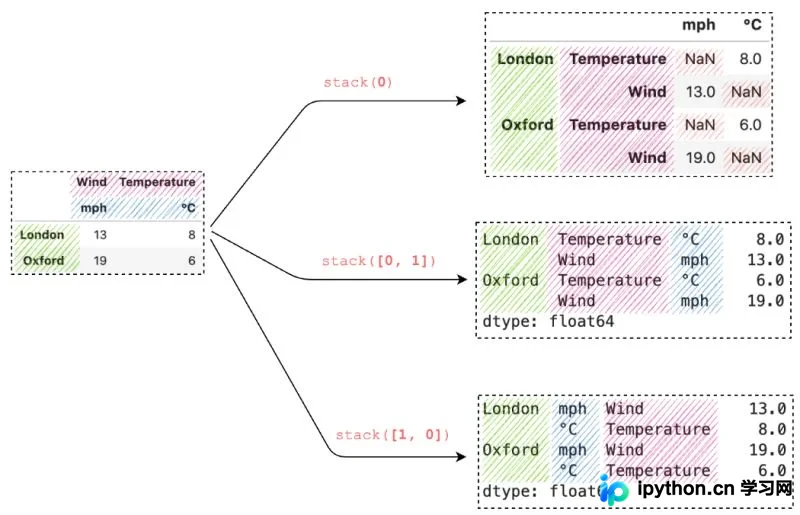
可以通过传递整数来指定需要堆叠的具体层级。若要指定多个层级进行堆叠,可以传递一个列表:
df_multi_level_2.stack(0)
df_multi_level_2.stack([0, 1])
df_multi_level_2.stack([1, 0])
5. 多层索引:移除缺失值
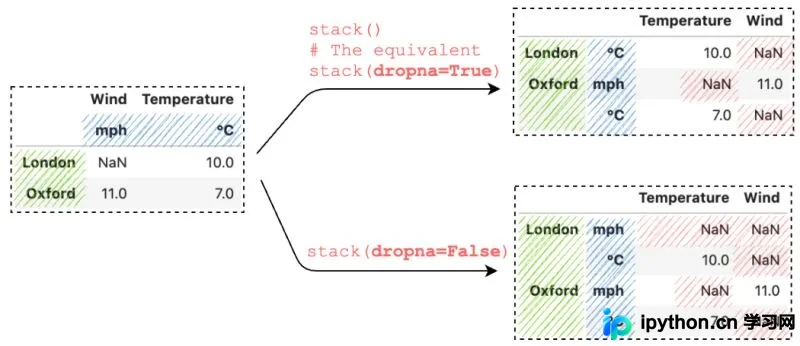
默认情况下,调用 stack() 会自动丢弃所有值均为缺失的行。若需保留这些行,可将 dropna 参数设置为 False 来控制此行为:
df_multi_level_3 = pd.DataFrame(
    [[None, 10], [11, 7.0]],
    index=['London', 'Oxford'],
    columns=multi_col_2
)
df_multi_level_3.stack()
df_multi_level_3.stack(dropna=False)
6. unstack:基础案例
同样,Pandas 的 unstack() 也支持 level 参数,默认值为 -1,即对最内层索引执行操作。
index = pd.MultiIndex.from_tuples([
  ('Oxford', 'Temperature'),
  ('Oxford', 'Wind'),
  ('London', 'Temperature'),
  ('London', 'Wind')
])
s = pd.Series([1,2,3,4], index=index)
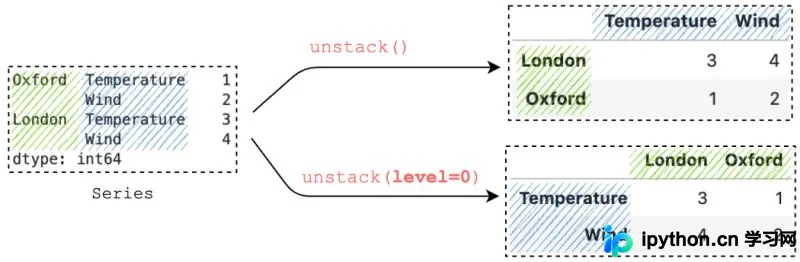
在具有 MultiIndex 的 Series 上调用 unstack(),会将最内层索引取消堆叠至列轴。若需指定取消堆叠的层级,可传递层级编号:
s.unstack()
# It's equivalent to
s.unstack(level=-1)
# Unstack a specific level
s.unstack(level=0)
7. unstack:进阶用法
通常情况下,我们会对具有更多层级的数据使用 unstack()。
以下是一个包含 3 个层级的示例:
index = pd.MultiIndex.from_tuples([
  ('Oxford', 'Weather', '01-01-2022'),
  ('Oxford', 'Temperature', '01-01-2022'),
  ('Oxford', 'Weather', '02-01-2022'),
  ('Oxford', 'Temperature', '02-01-2022'),
  ('London', 'Weather', '01-01-2022'),
  ('London', 'Temperature', '01-01-2022'),
  ('London', 'Weather', '02-01-2022'),
  ('London', 'Temperature', '02-01-2022'),
])
s = pd.Series(
  ['Sunny', 10, 'Shower', 7, 'Shower', 5, 'Sunny', 8],
  index=index
)
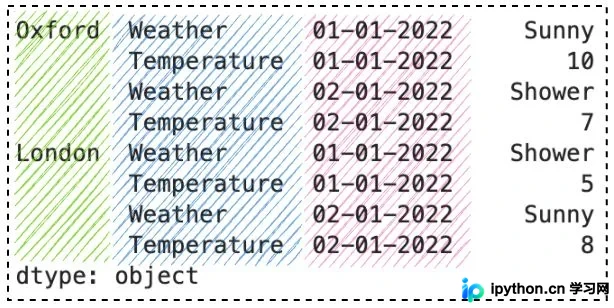
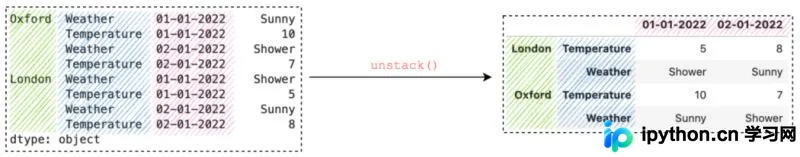
调用 unstack() 会将最内层的索引解栈至列中。
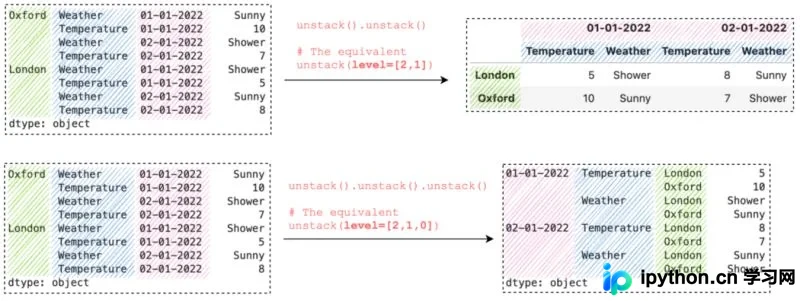
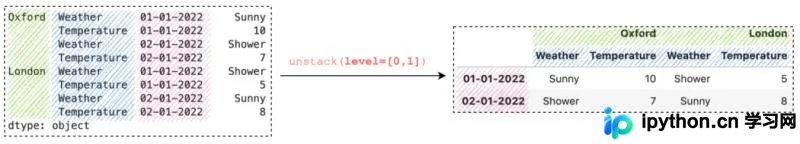
例如,可以使用方法链执行多次 unstack(),或者传递一个列表来指定多个层级:
# Method chaining
df.unstack().unstack()
df.unstack().unstack().unstack()
# The equivalent
df.unstack([2,1])
df.unstack([2,1,0])
结论
本文介绍了 7 种使用 Pandas stack() 和 unstack() 重塑 DataFrame 的用例。这些方法本身易于使用,是数据预处理中操纵数据结构的流行手段之一。
到此这篇关于详解Pandas中stack()和 unstack()的使用技巧的文章就介绍到这了,更多相关Pandas stack() unstack()内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















