


SQL Server 窗口函数实战:排名与分析函数详解

掌握 SQL Server 的窗口函数(Window Functions),可以摆脱传统 GROUP BY 的限制,在单行结果中完成复杂的数据统计。本文详细解析了四类核心排名函数(ROW_NUMBER 等)和七种常用分析函数(LAG/LEAD 等),提供清晰的语法说明与完整的 T-SQL 代码示例,助你高效处理数据分析任务。
一、排名开窗函数概述
SQL Server 的排名函数主要用于对查询结果集的行进行编号或排序。它们必须搭配 OVER() 子句使用,且 OVER() 内部必须包含 ORDER BY 来指定排序规则。
- PARTITION BY:将结果集按指定列拆分为多个逻辑组(分区),函数将在每个分组内独立运行。
- ORDER BY:定义每个分组内数据的排名顺序。
第1步:使用 ROW_NUMBER() 生成唯一序号
功能:为结果集中的每一行生成唯一的连续整数,从 1 开始递增。
适用场景:去重(取每组第一条)、分页查询。
ROW_NUMBER () OVER ( [ PARTITION BY clause ] ORDER BY clause )
第2步:使用 RANK() 处理并列排名
功能:当遇到相同的排序值时,生成相同的排名序号;但下一个排名会发生跳跃。
示例:若有两名员工并列第 1 名,下一位员工的排名将是 第 3 名(而非第 2 名)。
第3步:使用 DENSE_RANK() 实现密集排名
功能:与 RANK 类似,但当遇到相同值时也生成相同序号;关键在于下一个排名是连续的,没有跳跃。
示例:两名员工并列第 1 名,下一位员工的排名紧接为 第 2 名。
第4步:使用 NTILE(N) 进行均等分组
功能:将有序的数据集划分为 N 个近似相等的组,并为每行分配对应的组号。
应用:常用于计算四分位数(如 NTILE(4))。例如以下脚本展示了不同函数的对比效果:
SELECT Department, LastName, Rate,
    ROW_NUMBER() OVER (ORDER BY Rate) AS row_number,
    RANK() OVER (ORDER BY Rate) AS rate_rank,
    DENSE_RANK() OVER (ORDER BY Rate) AS dense_rank,
    NTILE(4) OVER (ORDER BY Rate) AS quartile_by_rate
FROM #data;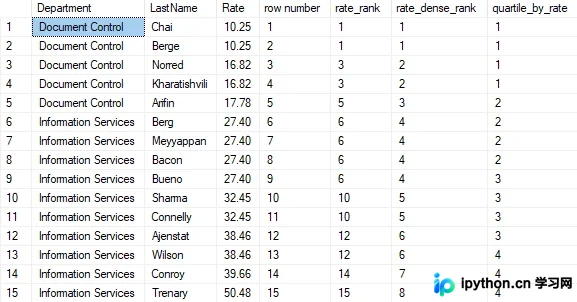
二、高级分析函数操作指南
分析函数基于 OVER() 子句定义的分区进行聚合运算。与普通聚合函数不同,它们在返回结果时不会压缩多行数据,这使得我们可以在同一行结果中看到原始值与聚合值(如中位数、最大值等)。
第1步:准备示例数据
为了准确演示各类函数,首先创建包含部门、姓名及薪水等级 (Rate) 的测试表:
;WITH cte_data AS (
    SELECT 'Document Control' AS Department, 'Arifin' AS LastName, 17.78 AS Rate
    UNION ALL SELECT 'Document Control', 'Norred', 16.82
    UNION ALL SELECT 'Document Control', 'Kharatishvili', 16.82
    UNION ALL SELECT 'Document Control', 'Chai', 10.25
    UNION ALL SELECT 'Document Control', 'Berge', 10.25
    UNION ALL SELECT 'Information Services', 'Trenary', 50.48
    UNION ALL SELECT 'Information Services', 'Conroy', 39.66
    UNION ALL SELECT 'Information Services', 'Ajenstat', 38.46
    UNION ALL SELECT 'Information Services', 'Wilson', 38.46
    UNION ALL SELECT 'Information Services', 'Sharma', 32.45
    UNION ALL SELECT 'Information Services', 'Connelly', 32.45
    UNION ALL SELECT 'Information Services', 'Berg', 27.40
    UNION ALL SELECT 'Information Services', 'Meyyappan', 27.40
    UNION ALL SELECT 'Information Services', 'Bacon', 27.40
    UNION ALL SELECT 'Information Services', 'Bueno', 27.40
)
SELECT Department, LastName, Rate INTO #data FROM cte_data;
GO
第2步:利用 LAG 和 LEAD 计算前后行差值
LAG(expression, offset, default):获取当前行之前的数据(向上查找)。 LEAD(expression, offset, default):获取当前行之后的数据(向下查找)。
关键参数:
offset:向前或向后跳过的行数,默认为 1。default:若超出分组边界(如第一行无前一行),返回指定的默认值,否则返回 NULL。
典型用例:计算同比增长率、环比数据。
SELECT Department, LastName, Rate,
    LAG(Rate, 1, 0) OVER (PARTITION BY Department ORDER BY LastName) AS LastRate,
    LEAD(Rate, 1, 0) OVER (PARTITION BY Department ORDER BY LastName) AS NextRate
FROM #data ORDER BY Department, LastName;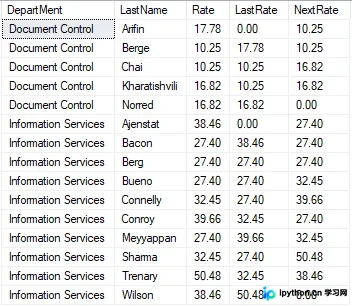
另一个实用场景是利用日期差值分析时间序列:
DECLARE @t TABLE (
    c1 INT IDENTITY,
    c2 DATE
);
INSERT INTO @t (c2) VALUES ('20120101'), ('20120201'), ('20120110'), ('20120221');
-- 插入更多数据以观察差分...

SELECT c1, c2,
    LAG(c2) OVER (ORDER BY c2) AS previous_c2,
    DATEDIFF(day, LAG(c2) OVER (ORDER BY c2), c2) AS diff_days
FROM @t ORDER BY c2;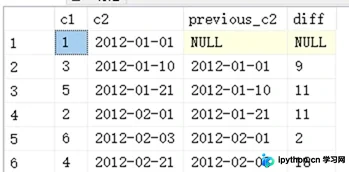
第3步:提取首尾数据 FIRST_VALUE 和 LAST_VALUE
这两个函数用于获取分组排序后首位和末位的数值。注意:LAST_VALUE 默认行为仅查看“当前行及其之前”的数据,因此若要获取真正的分组末尾值,必须使用 ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING 明确窗口的范围。
SELECT Department, LastName, Rate,
    FIRST_VALUE(Rate) OVER (PARTITION BY Department ORDER BY LastName
        ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS FirstVal,
    LAST_VALUE(Rate) OVER (PARTITION BY Department ORDER BY LastName
        ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS LastVal
FROM #data;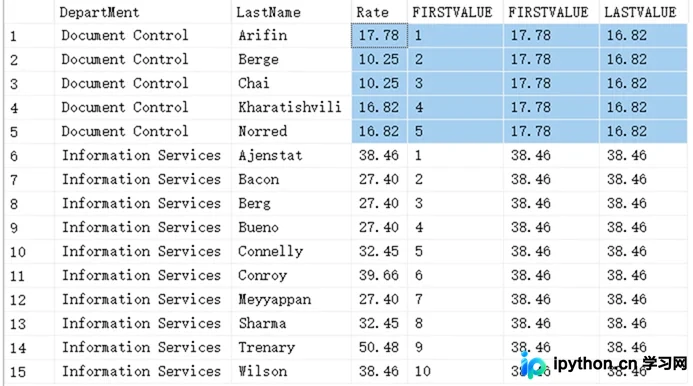
第4步:计算分布比例 CUME_DIST 和 PERCENT_RANK
这两个函数常用于统计分析数据的相对位置:
CUME_DIST():累积分布概率。计算公式为:(≤ 当前值的行数) /总行数。PERCENT_RANK():排名百分比。计算公式为:(RANK - 1) / (总行数 - 1)。
以下查询同时展示了排名与分布情况:
SELECT Department, LastName, Rate,
    CUME_DIST() OVER (PARTITION BY Department ORDER BY Rate) AS CumeDist,
    PERCENT_RANK() OVER (PARTITION BY Department ORDER BY Rate) AS PtcRank,
    COUNT(0) OVER (PARTITION BY Department) AS count_in_group
FROM #data ORDER BY Department, Rate DESC;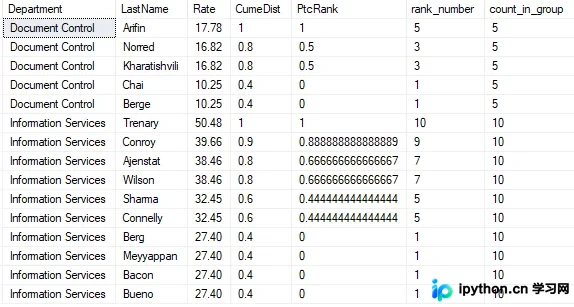
第5步:计算百分位数 PERCENTILE_CONT 与 PERCENTILE_DISC
用于获取特定百分位(如中位数 0.5)对应的实际数据值:
PERCENTILE_CONT(0.5):连续型插值。如果百分位点落在两行之间,会进行线性插值。PERCENTILE_DISC(0.5):离散型选择。直接选择满足条件的那个实际存在的行值。
SELECT Department, LastName, Rate,
    PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY Rate)
        OVER (PARTITION BY Department) AS MedianCont,
    PERCENTILE_DISC(0.5) WITHIN GROUP (ORDER BY Rate)
        OVER (PARTITION BY Department) AS MedianDisc
FROM #data ORDER BY Department, Rate ASC;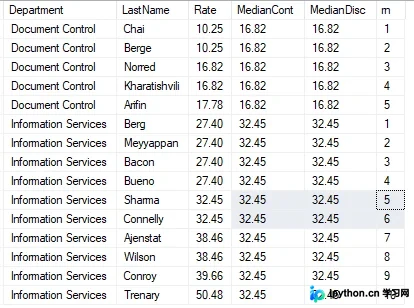
以上就是 SQL Server 窗口函数中排名函数与分析函数的详细内容,通过使用 OVER() 子句及其相关参数,您可以轻松应对各类复杂的数据分析与统计需求,更多关于数据库优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















