


Python用pandas读取CSV:pd.read_csv核心参数与用法详解
详细讲解 Python 中 pandas 库读取 CSV 文件的核心方法 pd.read_csv,涵盖文件路径、编码指定、行列选取、数据类型转换、日期解析、分块读取与常见报错排查。
在日常数据分析和工程实践中,CSV(Comma-Separated Values,逗号分隔值文件)是最基础也是最常见的数据交换格式。使用 Python 读取 CSV 文件时,pandas.read_csv() 是首选工具。然而在实际读取数据时,常常会遇到各种棘手情况:读取带有中文的文件时直接报编码错误、原本应当是数字的列因为混杂了特殊符号变成了字符串对象、带有千分位或特定日期格式的数据未能正确识别、或是上百兆的大文件瞬间占满系统内存导致程序崩溃。掌握 pd.read_csv() 及其核心参数的精确配置,是构建稳健数据处理流水线的第一道防线。
本文将从基础用法出发,针对编码控制、表头与行列裁剪、类型转换、缺失值与时间解析、大文件流式加载等核心场景,系统拆解 pd.read_csv() 的关键参数配置,并提供常见异常的诊断与解决方案。
一、基础调用与执行管道
最简单的读取方式仅需传入文件路径,pandas 会自动解析第一行为列头,按逗号拆分字段,并自动尝试推断每一列的数据类型:
import pandas as pd

# 最简调用
df = pd.read_csv('sales_data.csv')

# 查看数据前 5 行与基本类型信息
print(df.head())
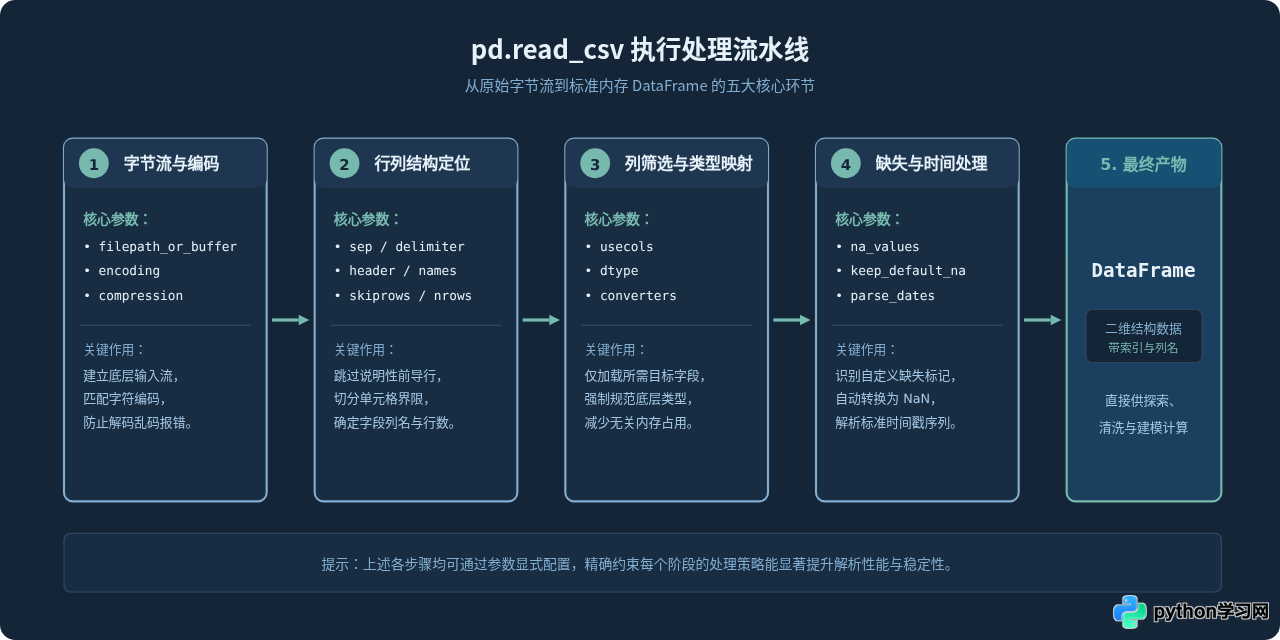
print(df.info())在看似简单的单行函数调用背后,pd.read_csv() 经历了一套严谨的解析管道:定位并解码文件字节流、定位行界定符与字段分隔符、抽取表头并对齐列名、逐列推断或转换数据类型、最终组装并返回规整的二维数据表 DataFrame。下图完整梳理了这一执行逻辑:
二、文件定位、分隔符与字符编码配置
1. 文件路径与对象传递(filepath_or_buffer)
第一个参数 filepath_or_buffer 既可以是本地磁盘路径(字符串或 pathlib.Path),也可以是远程 URL 地址,甚至是任何支持 read() 方法的文件型对象(如 io.StringIO 或压缩文件对象):
import io
import pandas as pd

# 场景 A:从 URL 直接拉取线上公开数据
df_url = pd.read_csv('https://raw.githubusercontent.com/datasets/gdp/master/data/gdp.csv')

# 场景 B:从内存字符串中快速测试读取(调试排错利器)
csv_data = """id,name,score
101,张三,95.5
102,李四,88.0"""
df_mem = pd.read_csv(io.StringIO(csv_data))
2. 分隔符(sep 与 delimiter)
默认分隔符是逗号 sep=','。若处理制表符分隔的 TSV 文件,可设置 sep='\t'。若文件字段由不定长的多个空格分隔,可结合正则表达式解析引擎:
# 读取由多个连续空格分隔的日志类数据,需显式声明 engine='python'
df_space = pd.read_csv('server.log', sep=r'\s+', engine='python')
3. 字符编码(encoding)
中文处理中最常见的异常是 UnicodeDecodeError: 'utf-8' codec can't decode byte...。这是因为 Windows 平台下 Excel 导出的 CSV 文件默认常为 GBK 或 GB18030 编码,或者带有微软专属的 UTF-8 BOM 头:
- 通用 UTF-8:标准数据首选
encoding='utf-8'。 - Excel 导出的中文 CSV:若 UTF-8 报错,通常尝试
encoding='gbk'或支持生僻字更完整的encoding='gb18030'。 - 首列乱码带有 \ufeff:使用
encoding='utf-8-sig'即可自动剥离开头的 BOM 标记。
# 解决中文 Excel 导出乱码
df_chinese = pd.read_csv('orders_win.csv', encoding='gb18030')

# 解决首列列名前带有特殊字符 \ufeff 的情况
df_bom = pd.read_csv('data_with_bom.csv', encoding='utf-8-sig')
三、表头、列名与数据裁剪
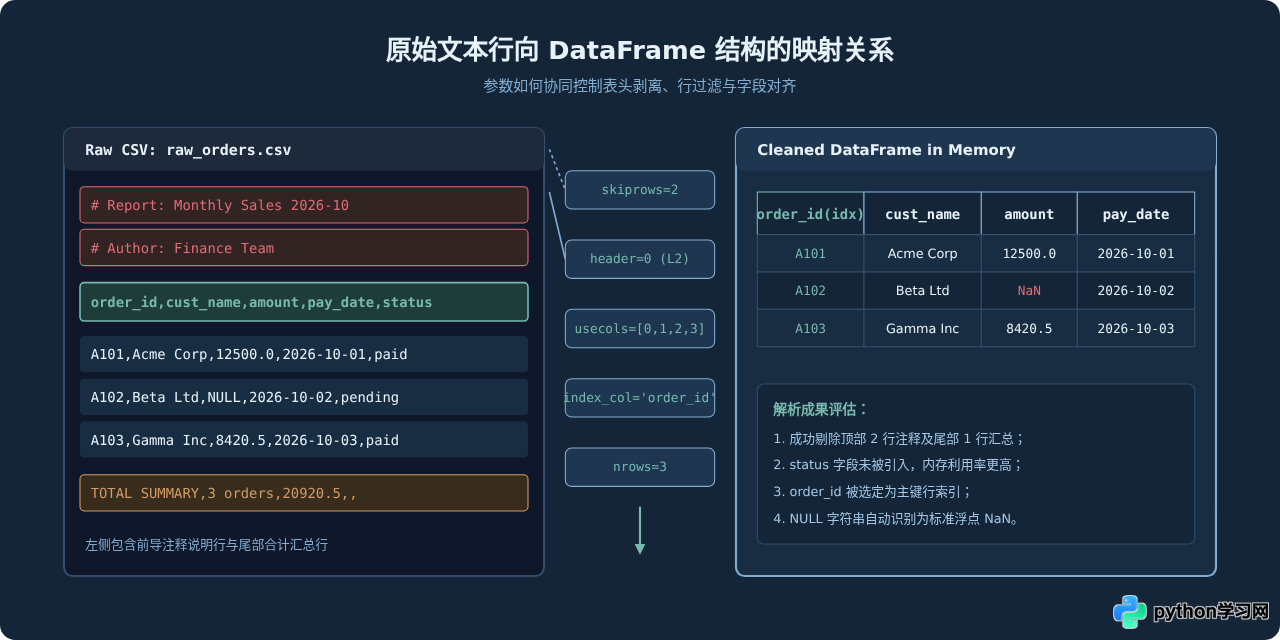
许多业务报表在顶部会附加 2 到 3 行生成说明、版权信息或空行,或者底部附有合计行。合理使用行列裁剪参数,可以在载入内存的瞬间跳过无用信息。
1. header 与 names
header=0(默认值):表示第一行为列名。header=None:文件无表头,自动分配数字索引0, 1, 2...作为列名。names=['col1', 'col2']:显式指定列名列表。注意:若原文件已有表头行,需同时配合header=0替换原列名;若没有表头,则应配合header=None。
2. skiprows 与 skipfooter
skiprows 支持传入整数或回调函数:
# 跳过前两行说明文字
df = pd.read_csv('report.csv', skiprows=2)

# 使用 lambda 表达式自定义过滤规则:如跳过偶数行,或跳过特定行
df_filtered = pd.read_csv('report.csv', skiprows=lambda x: x in [1, 3, 5])

# 跳过文件尾部 2 行合计汇总行(注意需使用 c 引擎之外的 python 引擎)
df_no_footer = pd.read_csv('report.csv', skipfooter=2, engine='python')
3. 限制加载行数(nrows)
在面对数吉字节(GB)的超级大文件时,千万不要直接全量读入。先用 nrows=100 预览数据结构、列名与类型是否符合预期:
# 快速探测大文件前 100 行
df_sample = pd.read_csv('big_data.csv', nrows=100)
print(df_sample.columns)
print(df_sample.dtypes)
四、字段筛选与类型强制转换
1. 按需选择列(usecols)
如果 CSV 文件包含 50 个字段,而业务分析只需用到其中 3 个,使用 usecols 可以极大地降低内存消耗并成倍提高读取速度。usecols 支持传入列名列表、索引列表或可调用函数:
# 方式 1:列名列表
df_sub1 = pd.read_csv('orders.csv', usecols=['order_id', 'amount', 'pay_date'])

# 方式 2:列索引列表(第 0 列与第 2 列)
df_sub2 = pd.read_csv('orders.csv', usecols=[0, 2])

# 方式 3:函数筛选(挑选包含 'date' 或以 'id' 结尾的列)
df_sub3 = pd.read_csv('orders.csv', usecols=lambda col: 'date' in col.lower() or col.endswith('_id'))
2. 指定数据类型(dtype)
默认情况下,pandas 会通过试探判断列类型。但这种自动推断有两个主要弊端:
- 身份证号、电话号码或订单编号前导 0 丢失:比如
00123会被解析成整数123。 - 混合类型推断为 object:消耗大量内存且计算性能差。
通过 dtype 参数在读取阶段显式指定类型,可以确保数据绝对精准并压低内存开销:
# 确保订单号作为字符串保留前导 0,金额使用标准 32 位浮点
df_typed = pd.read_csv(
    'orders.csv',
    dtype={
        'order_id': str,
        'user_phone': str,
        'amount': 'float32',
        'status': 'category'  # 重复度高的文本转为 category 类型,节省数倍内存
    }
)
3. 自定义清洗转换器(converters)
若字段中夹杂货币符号(如 $1,250.00)或百分号(85.5%),直接使用 dtype=float 会导致解析报错。此时可通过 converters 传入转换函数:
# 去除货币符号并清洗为浮点型
clean_price = lambda x: float(x.replace('$', '').replace(',', '').strip()) if x.strip() else 0.0

df_converted = pd.read_csv(
    'financials.csv',
    converters={'revenue': clean_price}
)
五、缺失值识别与日期时间解析
1. 缺失值标记(na_values 与 keep_default_na)
不同系统生成的 CSV 缺失值表示方式各不相同。有的写成 NULL,有的用 \N、NA、-999 或单纯的空格。
# 将自定义字符串统一判定为缺失值 (NaN)
df_na = pd.read_csv(
    'sensor.csv',
    na_values=['NA', 'NULL', 'None', '-999', 'missing']
)pandas 默认会将 NA、N/A、null 等自动识别为 NaN。如果数据中恰好有名为纳米比亚的国家代码 NA,默认解析会将其错误地变成缺失值。此时需要设置 keep_default_na=False,并严格通过 na_values 指定真正的缺失标记。
2. 日期时间解析(parse_dates 与 date_format)
若不设置日期解析参数,所有的日期时间列都会被当成普通字符串读取,后续无法直接进行按月重采样(resample)或周期切片:
# 单列或多列指定解析为 datetime64
df_dates = pd.read_csv(
    'traffic.csv',
    parse_dates=['log_time']
)

# 多列合并解析为单一时间索引(如将 'date' 与 'time' 两列合并)
df_combined = pd.read_csv(
    'events.csv',
    parse_dates={'datetime': ['event_date', 'event_time']}
)

# 在 pandas 2.0+ 中显式提供 date_format 能极大加快解析速度
df_fast_date = pd.read_csv(
    'orders.csv',
    parse_dates=['pay_date'],
    date_format='%Y-%m-%d %H:%M:%S'
)
六、大规模数据流式处理:chunksize 机制
当 CSV 文件容量超过物理可用内存(例如一个 20GB 的点击日志文件),直接调用 pd.read_csv() 将触发 MemoryError。此时应使用 chunksize 参数进行流式分批读取。
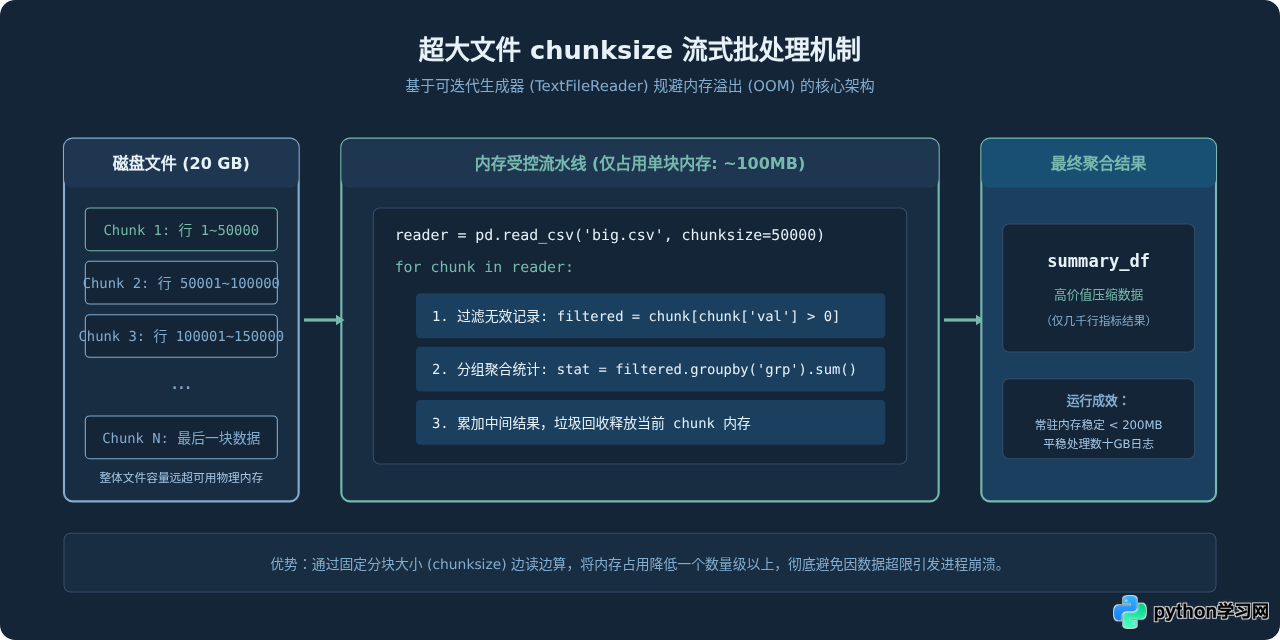
在代码层面,传入 chunksize 后,pd.read_csv() 不会直接返回 DataFrame,而是返回一个 TextFileReader 迭代器对象:
import pandas as pd

# 设定每次迭代读取 100,000 行
chunk_iterator = pd.read_csv('massive_user_actions.csv', chunksize=100000)

total_clicks = 0
category_counts = {}

# 逐块进行增量汇总
for chunk in chunk_iterator:
    # 过滤出有效点击记录
    clicks = chunk[chunk['action_type'] == 'click']
    total_clicks += len(clicks)

    # 统计分类累计频次
    batch_counts = clicks['category'].value_counts()
    for cat, count in batch_counts.items():
        category_counts[cat] = category_counts.get(cat, 0) + count

print(f"总点击次数: {total_clicks}")
七、核心参数全景对比与速查矩阵
为了在实际开发中能迅速定位所需配置,下表归纳了 pd.read_csv() 中最常用的参数职能与典型应用场景:
| 参数名称 | 默认值 | 类型与常用值 | 典型解决问题 |
|---|---|---|---|
filepath_or_buffer |
必填 | str / Path / StringIO / URL | 数据来源入口(本地磁盘、S3/HTTP链接或内存流) |
sep / delimiter |
',' |
str,如 ',', '\t', r'\s+' |
TSV 制表符分隔或多空格正则切分 |
encoding |
'utf-8' |
str,如 'gbk', 'utf-8-sig' |
解决中文解码报错或开头的 \ufeff BOM 乱码 |
header |
0 |
int / list of int / None |
指定列名所在行号;无表头时指定为 None |
names |
None |
list of str | 文件无表头或需要重命名所有字段时提供 |
index_col |
None |
int / str / list | 指定某一列或多列作为 DataFrame 的行索引(如唯一 ID) |
usecols |
None |
list / callable | 只读取目标列,显著节约内存与 CPU 时间 |
dtype |
None |
dict,如 {'code': str} |
强制列类型,防止数字前导 0 丢失,指定低开销类型 |
converters |
None |
dict of functions | 读取时实时清洗货币符号、百分号等非纯数字字符 |
na_values |
None |
list / set / dict | 将业务特定的标记(如 'NULL', '-999')设为缺失 |
parse_dates |
False |
bool / list / dict | 自动将时间戳字符串转为 datetime64[ns] 对象 |
nrows |
None |
int | 限定读取前 N 行,用于大文件结构探测与轻量验证 |
chunksize |
None |
int | 返回分块迭代器,用于百兆/吉字节大文件流式批量计算 |
low_memory |
True |
bool | 大文件按块内部推断类型,若报类型混淆警告可设为 False |
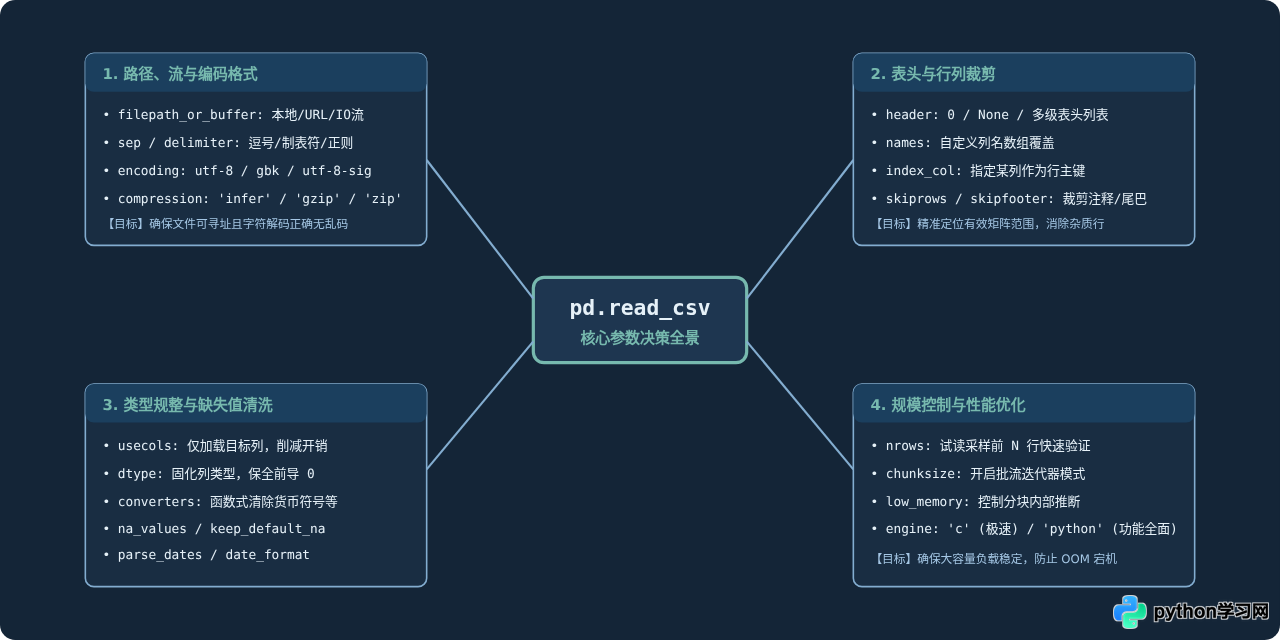
下图进一步通过分类思维导图对这些核心参数建立全局心智模型:
八、常见解析报错与快速排查清单
1. ParserError: Error tokenizing data
原因:某一行的逗号数量与表头不一致。例如表头定义了 5 列,某行内容因为缺少引号包裹,其中一个文本字段本身带有逗号,被切分成了 6 列。
解决办法:
# 临时容错:忽略异常行并打印警告(需注意是否会丢失关键数据)
df_safe = pd.read_csv('dirty_data.csv', on_bad_lines='skip')

# 或者记录并审查异常行(pandas 1.3+ 支持传入可调用函数)
def handle_bad_line(line):
    print(f"异常行: {line}")
    return None

df_inspected = pd.read_csv('dirty_data.csv', on_bad_lines=handle_bad_line, engine='python')
2. DtypeWarning: Columns (x) have mixed types
原因:pandas 在使用 C 引擎读取大文件时,为了节约内存是分块推断数据类型的。如果在第一块中某列全为整数,而在后序块中出现了字符串或缺失,pandas 会发出该警告,并将该列转换为较为低效的 object 类型。
解决办法:
- 优先做法:在
dtype参数中显式声明该列的目标类型(如dtype={'col_x': str})。 - 次选做法:如果内存宽裕,设置
low_memory=False让 pandas 一次性通读整列后再统一确定类型。
3. UnicodeDecodeError: 'utf-8' codec can't decode...
解决流程:
- 优先尝试
encoding='gbk'或encoding='gb18030'。 - 如果文件编码极其混乱,可借助 Python 内置的
chardet库预先读取几十个字节探测编码:
import chardet

with open('mystery_data.csv', 'rb') as f:
    raw_data = f.read(10000)
    detected = chardet.detect(raw_data)
    print(f"探测出的字符编码: {detected['encoding']}")

df = pd.read_csv('mystery_data.csv', encoding=detected['encoding'])
九、总结
pd.read_csv() 是数据分析工程中最基础却最富有深度的高频函数之一。在实际应用中,养成规范的使用习惯能够避免绝大多数常见隐患:
- 对于未知结构的新数据,先通过
nrows=50或nrows=100快速试读,观察字段命名与实际内容。 - 对于包含身份证、工号、电话号码的列,务必通过
dtype参数强制指定为str,严防前导 0 丢失。 - 对于百兆以上的大型数据集,养成结合
usecols裁切字段、配合chunksize进行批流计算的习惯,确保脚本在各类硬件环境中都能稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















