


Python实现腾讯视频视频解析与TS文件合并下载的示例代码

发布时间:2026-10-15 |
4人浏览过
本文介绍使用Python实现腾讯视频目标URL的解析与下载。通过第三方VIP解析接口获取视频源,模拟浏览器请求抓取缓存的TS分片文件,并利用多进程技术加速下载,最终将多个TS文件合并为MP4格式以实现本地播放。
运行环境
- IDE丨pycharm
- 版本丨Python3.6
- 系统丨Windows
实现目的与思路
目的
本示例旨在实现对腾讯视频目标URL的解析与下载。由于第三方VIP解析服务通常仅提供在线观看功能,隐藏了直接下载链接,因此需要技术手段突破限制,实现对目标视频文件的本地下载。
思路
首先获取目标腾讯电影的URL,通过第三方VIP视频解析网站进行解析。接着通过抓包工具分析,模拟浏览器发送正常请求,从而获取视频缓存的TS文件列表。随后下载这些TS分片文件,最后将它们转换为MP4格式,即可实现正常播放。
完整代码
import re
import os,shutil
import requests,threading
from urllib.request import urlretrieve
from pyquery import PyQuery as pq
from multiprocessing import Pool
'''
'''
class video_down():
    def __init__(self,url):
        # 拼接全民解析url
        self.api='https://jx.618g.com'
        self.get_url = 'https://jx.618g.com/?url=' + url
        #设置UA模拟浏览器访问
        self.head = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36'}
        #设置多线程数量
        self.thread_num=32
        #当前已经下载的文件数目
        self.i = 0
        # 调用网页获取
        html = self.get_page(self.get_url)
        if html:
            # 解析网页
            self.parse_page(html)
    def get_page(self,get_url):
        try:
            print('正在请求目标网页....',get_url)
            response=requests.get(get_url,headers=self.head)
            if response.status_code==200:
                #print(response.text)
                print('请求目标网页完成....\n 准备解析....')
                self.head['referer'] = get_url
                return response.text
        except Exception:
            print('请求目标网页失败,请检查错误重试')
            return None


    def parse_page(self,html):
        print('目标信息正在解析........')
        doc=pq(html)
        self.title=doc('head title').text()
        print(self.title)
        url = doc('#player').attr('src')[14:]
        html=self.get_m3u8_1(url).strip()
        #self.url = url + '800k/hls/index.m3u8'
        self.url = url[:-10] +html
        print(self.url)
        print('解析完成,获取缓存ts文件.........')
        self.get_m3u8_2(self.url)
    def get_m3u8_1(self,url):
        try:
            response=requests.get(url,headers=self.head)
            html=response.text
            print('获取ts文件成功,准备提取信息')
            return html[-20:]
        except Exception:
            print('缓存文件请求错误1,请检查错误')


    def get_m3u8_2(self,url):
        try:
            response=requests.get(url,headers=self.head)
            html=response.text
            print('获取ts文件成功,准备提取信息')
            self.parse_ts_2(html)
        except Exception:
            print('缓存文件请求错误2,请检查错误')
    def parse_ts_2(self,html):
        pattern=re.compile('.*?(.*?).ts')
        self.ts_lists=re.findall(pattern,html)
        print('信息提取完成......\n准备下载...')
        self.pool()
    def pool(self):
        print('经计算需要下载%d个文件' % len(self.ts_lists))
        self.ts_url = self.url[:-10]
        if self.title not in os.listdir():
            os.makedirs(self.title)
        print('正在下载...所需时间较长,请耐心等待..')
        #开启多进程下载
        pool=Pool(16)
        pool.map(self.save_ts,[ts_list for ts_list in self.ts_lists])
        pool.close()
        pool.join()
        print('下载完成')
        self.ts_to_mp4()
    def ts_to_mp4(self):
        print('ts文件正在进行转录mp4......')
        str='copy /b '+self.title+'\*.ts '+self.title+'.mp4'
        os.system(str)
        filename=self.title+'.mp4'
        if os.path.isfile(filename):
            print('转换完成,祝你观影愉快')
            shutil.rmtree(self.title)


    def save_ts(self,ts_list):
        try:
            ts_urls = self.ts_url + '{}.ts'.format(ts_list)
            self.i += 1
            print('当前进度%d/%d'%(self.i,len(self.ts_lists)))
            urlretrieve(url=ts_urls, filename=self.title + '/{}.ts'.format(ts_list))
        except Exception:
            print('保存文件出现错误')


if __name__ == '__main__':
    #电影目标url:狄仁杰之四大天王
    url='https://v.qq.com/x/cover/r6ri9qkcu66dna8.html'
    #电影碟中谍5:神秘国度
    url1='https://v.qq.com/x/cover/5c58griiqftvq00.html'
    #电视剧斗破苍穹
    url2='https://v.qq.com/x/cover/lcpwn26degwm7t3/z0027injhcq.html'
    url3='https://v.qq.com/x/cover/33bfp8mmgakf0gi.html'
    video_down(url2)
视频缓存TS文件
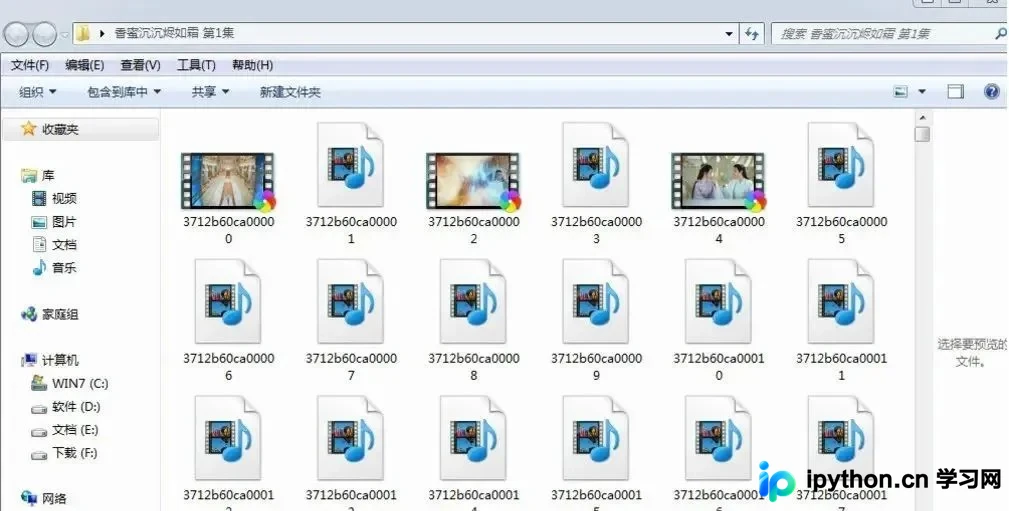
此处获取的是视频缓存的TS文件,每个文件仅包含几秒钟的播放内容。最终需要将这些分散的TS文件合并成一个MP4格式的视频,以便正常播放,默认采用高清下载标准。
注意,由于代码使用了多进程进行下载,进度条仅供参考,并未显示确切的总体进度。用户可以通过进入文件夹查看已下载的文件数量来了解实际进度,可以理解为每显示一次进度即代表成功下载了一个TS文件。
实现效果
以上就是Python实现抓取腾讯视频所有电影的示例代码的详细内容,更多关于Python抓取腾讯视频的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















