


只装Anaconda还是必须配PyCharm?数据科学开发环境搭建指南

不少人在刚接触 Python 数据科学时,常被安装流程搞糊涂:既下载了几百兆的 Anaconda 安装包,又被教程催着去装几个 G 的 PyCharm Professional 或 Community 版本。把两者都装上后,往往遇到终端命令找不到、Python 解释器路径错乱、Jupyter 里的包在 PyCharm 报错等一系列环境问题。实际上,二者根本不是二选一的并列关系,也不存在强行绑定的前后依赖。
一、概念解构:分清“环境管理者”与“代码编辑器”
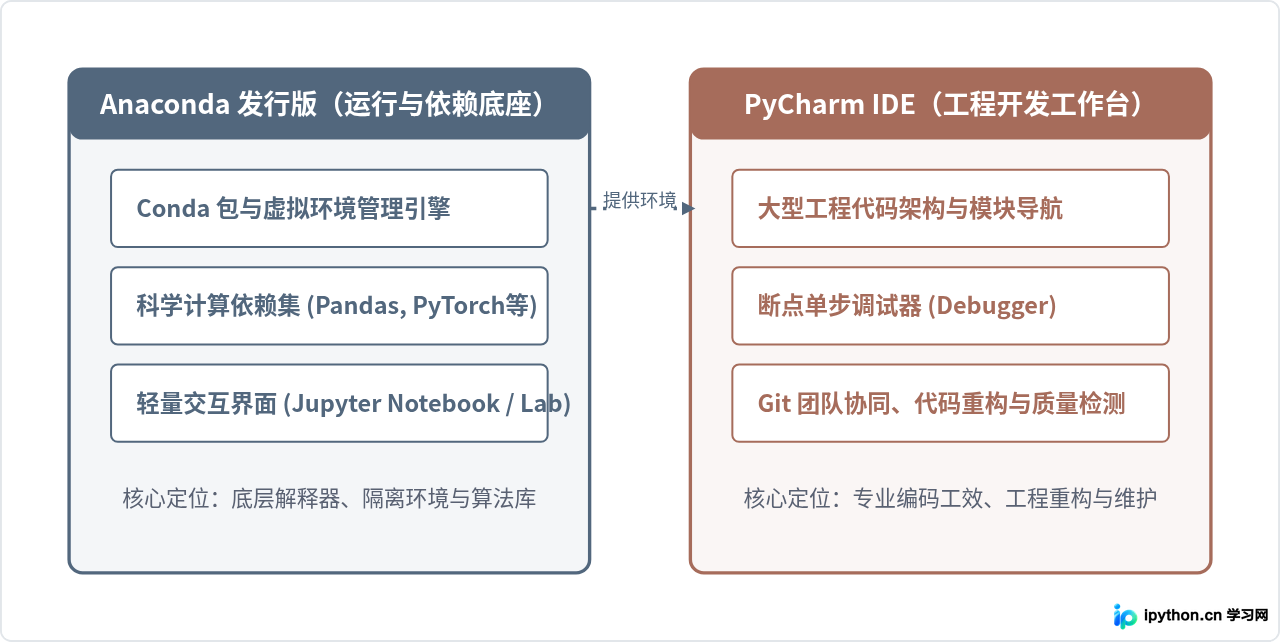
理解这个配置困境的关键,在于看清 Anaconda 与 PyCharm 分别处于软件体系的哪一层:
Anaconda 是一个针对科学计算的 Python 发行版。它不仅自带了标准的 Python 解释器,还预装了 NumPy、Pandas、Matplotlib 等数百个基础科学计算包,并附带了环境包管理工具 conda 以及交互式计算界面 Jupyter Notebook 与 Spyder。你可以把它看作一辆已经装满野营装备的越野车,拉开门就能开工。
PyCharm 则是一款纯粹的集成开发环境(IDE)。它本身默认不附带任何第三方的科学计算库,它的强项在于工程级辅助:全项目的语法静态检查、智能补全、可视化断点调试、Git 版本控制、重构函数以及单元测试框架。它是一张工业级的木工工作台,但台面上需要放入哪把锯子、哪个刨子(即 Python 解释器与依赖库),完全由你决定。
二、决策评估:你到底属于哪种工作流?
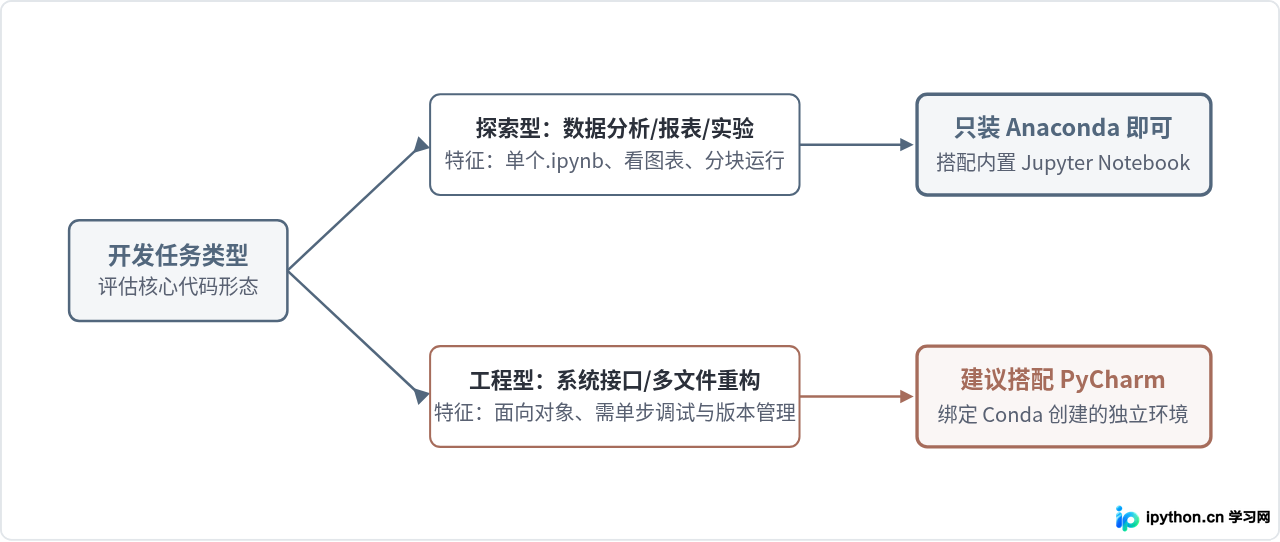
明确了两者属性,选择就变得非常客观:关键取决于你现阶段主要写什么形态的代码。
| 考量维度 | 方案 A:只安装 Anaconda | 方案 B:Anaconda + PyCharm 联动 |
|---|---|---|
| 典型开发形态 | 单个 .ipynb 记事本文件,分段执行探索 | 多个 .py 脚本、面向对象包、配置系统与接口 |
| 数据与图表反馈 | 表格与统计图即时在单元格下方渲染 | 通常通过弹窗或专门的 SciView 窗格查看 |
| 代码调试机制 | 依靠单元格逐段输出变量、print() 排查 | 工业级断点调试、堆栈帧查看、逐行步入步过 |
| 机器资源开销 | 低,浏览器启动快,内存占用较少 | 较高,项目索引初始化需要较多 CPU 与内存 |
| 适合目标人群 | 学术研究、数据探索、论文制图、初学者入门 | 企业算法部署、后端管道构建、大型项目协作 |
如果你处在以下两种状态之一,完全不需要着急去装 PyCharm:
第一,你需要随时查看清洗后的前五行数据(df.head())或绘制分布曲线。这种探索工作要求“所见即所得”,Jupyter Notebook 可以在保存变量内存的前提下反复改写局部代码,远比在 IDE 里频繁重新执行整个脚本要快。
第二,你正在学习基础语法或跟随机器学习课程完成作业。这时首要目标是掌握逻辑,配置 IDE 复杂的文件路径和项目视图反而会增加不必要的挫败感。
相反,当你需要把探索成熟的算法拆解为 model.py、dataset.py,并编写单元测试或对外提供 FastAPI 接口时,PyCharm 的工程能力就是不可替代的生产力工具。
三、实操流程:高效环境搭建与联动步骤
如果你确认当前需要工程化开发,正确的搭建逻辑是:先安装 Anaconda 创建受控的纯净环境,再安装 PyCharm,并将工程的解释器指向该 Conda 环境。切忌直接在 Anaconda 的 base 默认环境中堆砌所有项目包。
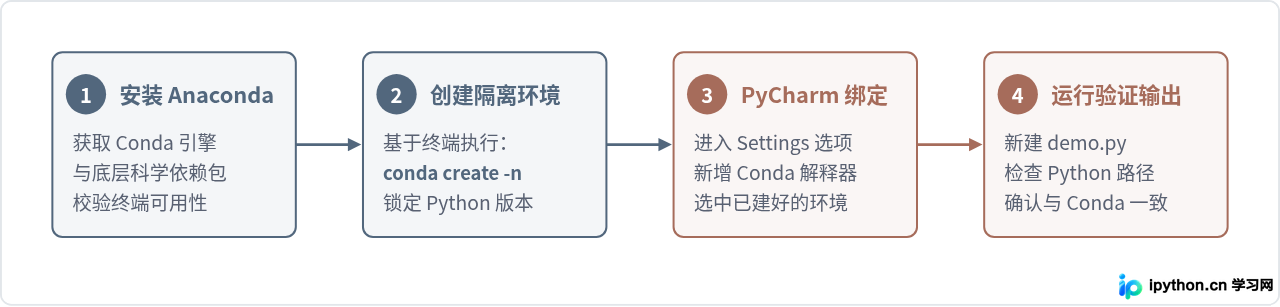
第 1 步:使用 Conda 建立独立的工程虚拟环境
打开系统终端(Windows 用户建议使用“Anaconda Prompt”,macOS/Linux 直接使用 Terminal),运行以下命令创建一个指定 Python 版本的独立环境:
# 创建一个名为 ds_project 的环境,指定 python 版本为 3.10
conda create -n ds_project python=3.10 -y

# 激活新创建的环境
conda activate ds_project

# 在当前隔离环境中安装本阶段所需的核心分析库
conda install numpy pandas matplotlib scikit-learn -y
验证当前环境处于激活状态且包安装正确:
# 检查环境列表,查看当前星号指向
conda info --envs

# 示例输出:
# # conda environments:
# #
# base                     C:\Users\Username\anaconda3
# ds_project            *  C:\Users\Username\anaconda3\envs\ds_project
第 2 步:在 PyCharm 中挂载现有的 Conda 环境
启动 PyCharm,在打开的项目中按以下顺序操作:
- 依次打开菜单栏:File -> Settings(macOS 为 PyCharm -> Preferences)。
- 在左侧导航树中展开 Project: [你的项目名],点击 Python Interpreter。
- 在右侧窗口上方点击 Add Interpreter 按钮,下拉选择 Add Local Interpreter...。
- 在弹出的对话框左侧选中 Conda Environment。
- 勾选 Use existing environment,在下拉菜单中找到刚才创建的 ds_project。如果下拉列表为空,点击右侧的“...”按钮,手动定位到 Anaconda 安装目录下的 envs/ds_project/python.exe(macOS 为 envs/ds_project/bin/python)。
- 点击 OK 保存,PyCharm 会自动扫描该环境内已安装的全部库文件。
第 3 步:编写验证脚本检验环境协同
在项目根目录新建一个文件 test_env.py,输入以下代码测试解释器与包绑定情况:
import sys
import pandas as pd

def check_runtime():
    print(f"当前 Python 解释器实际路径:\n{sys.executable}\n")
    print(f"Pandas 安装版本: {pd.__version__}")

if __name__ == "__main__":
    check_runtime()
在编辑器内右键选择 Run 'test_env',终端若显示包含 envs/ds_project 的路径及正确的 Pandas 版本号,即说明 PyCharm 已经完全借力于 Anaconda 的底层依赖。
四、关键细节与避坑指南
在实际使用中,有几个高频踩坑点需要注意:
1. 警惕 base 环境“臃肿污染”:很多初学者图省事,不管什么项目都直接装在 Anaconda 默认的 base 环境里。时间一长,依赖库版本冲突会导致 Jupyter 崩溃甚至 conda 命令报错。牢记原则:base 环境只保留基础工具,每一个具体课题或项目都单独新建虚拟环境。
2. 区分 pip 与 conda 混用边界:当某些小众包在 Conda 仓库找不到时,必须用 pip 安装。请务必在当前项目对应的虚拟环境已被激活(conda activate ds_project)的状态下执行 pip install,否则依赖包可能会安装到全局 Python 中,导致 PyCharm 里继续标红提示找不到模块。
3. 系统性能考量:PyCharm 启动时会建立详尽的项目索引,如果你的电脑内存小于 8GB,同时打开浏览器运行大量数据的 Jupyter Notebook 和 PyCharm 会造成明显卡顿。如果机器配置有限,且当前并不写深层调用结构,单装 Anaconda 配合 VS Code(轻量级插件模式)也是一个折中且实用的选项。
五、总结:按需协作的极简心法
回顾整个技术栈的搭配,你不需要把 Anaconda 和 PyCharm 看作非此即彼的对立面。它们之间是典型的“供求协同”:
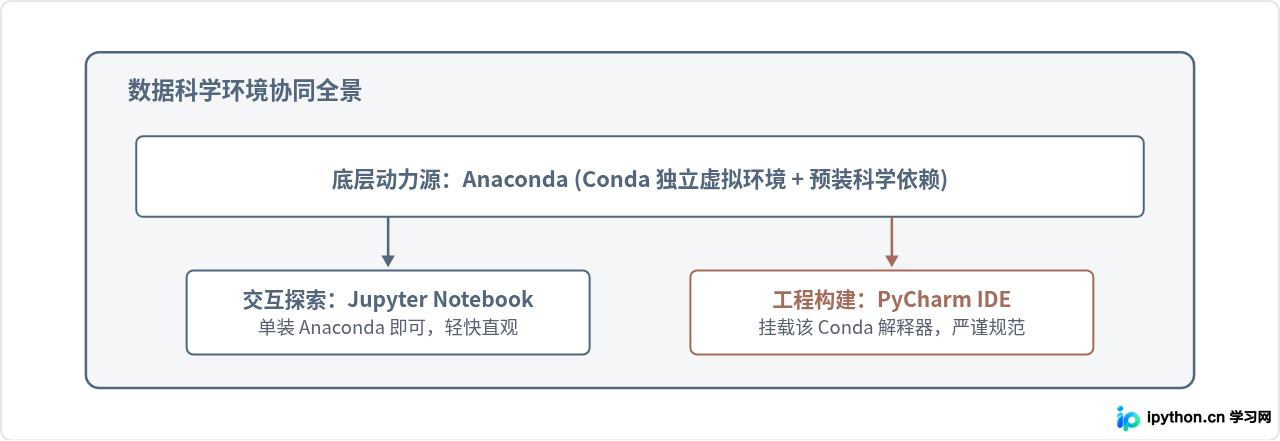
只要记住一句话:需要搞数据、写实验、看图表,只装 Anaconda 绰绰有余;需要拆分模块、做工程、提接口,才必须配上 PyCharm。根据自己的实际代码需求做加法,开发环境才能清爽高效,而不是在无休止的路径调试中耗费精力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















