


Python re.findall() 函数用法全解析与实战示例

发布时间:2026-10-15 |
2人浏览过
本文详细介绍Python中re模块的findall()函数用法。该函数用于在字符串中查找所有匹配正则表达式的子串,并返回包含所有匹配结果的列表。文章通过多个具体代码示例,演示了基础字符匹配、未找到结果的处理、复杂正则模式(如锚点、字符集、数字匹配及取反)的应用,以及结合requests库提取网页Title的实战场景。
re.findall() 函数基本定义与返回值
在Python编程语言中,开发者可以直接调用内建的re模块来实现正则表达式匹配功能。本文将重点解析Python中正则表达式模块的findall()函数的具体使用方法。
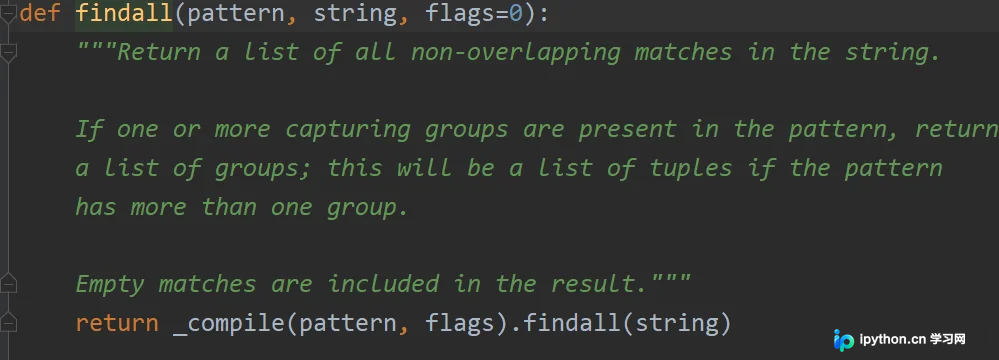
re.findall()函数的作用是返回一个列表,其中包含字符串中与给定模式pattern完全匹配的所有子串。其返回值类型为数组(列表)。
基础匹配与未匹配情况的处理示例
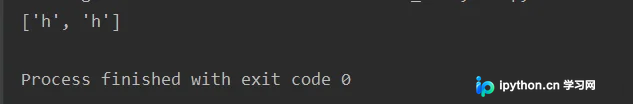
示例代码1:【打印所有的匹配项】
import re

s = "Long live the people's Republic of China"
ret = re.findall('h', s)

print(ret)
运行结果:
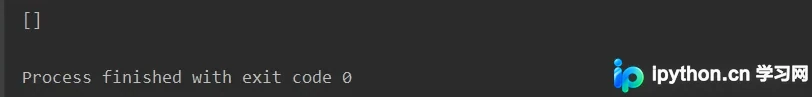
示例代码2:【如果未找到匹配项,返回空列表】
import re

s = "Long live the people's Republic of China"
ret = re.findall('USA', s)

print(ret)
运行结果:
复杂正则表达式匹配实战
示例代码:
import re

s = "https://blog.csdn.net/weixin_44799217"
ret = re.findall(r"^http", s)
print(ret)

ret2 = re.findall(r"[t,b,s]", s)  # 匹配括号中的其中一个字符
print(ret2)

ret3 = re.findall(r"\d\d\d", s)
print(ret3)

ret4 = re.findall(r"\d", s)
print(ret4)

ret5 = re.findall(r"[^\d]", s)  # 取非
print(ret5)

ret6 = re.findall(r"[^https://]", s)  # 取非
print(ret6)
运行结果:
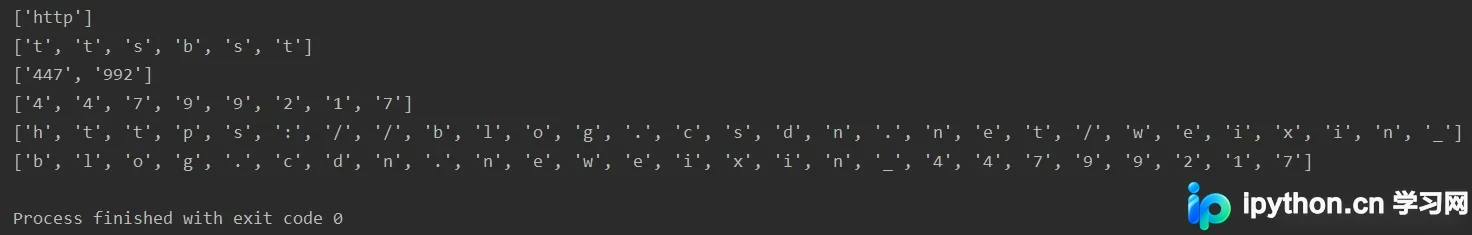
结合Requests库提取网页Title实战
获取网站中的title:
import requests
import re

url = 'https://pz.wendu.com/'

response = requests.get(url)
data = response.text
# print(data)
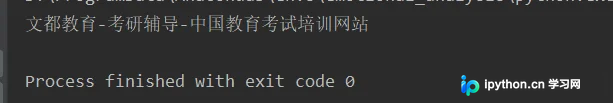
res = re.findall(r'<title>(.*?)</title>', data)[0]
print(res)
运行效果:
到此这篇关于Python中re.findall()用法详解的文章就介绍到这了,更多相关Python re.findall()用法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















