


Python中K-Means聚类算法原理与图片压缩实战

发布时间:2026-10-12 |
2人浏览过
本文深入解析K-Means聚类算法的核心原理,涵盖初始化簇中心、簇分配及中心移动三个关键步骤,并探讨如何通过减少颜色数量实现图片压缩。文章提供Python环境下的完整代码示例,帮助开发者理解并应用K-Means进行数据降维与图像优化。
在Python学习过程中,K-Means算法与图片压缩技术是常见的应用场景。本文旨在分享这两种技术的实现方法与底层原理,建议读者收藏以便后续查阅。
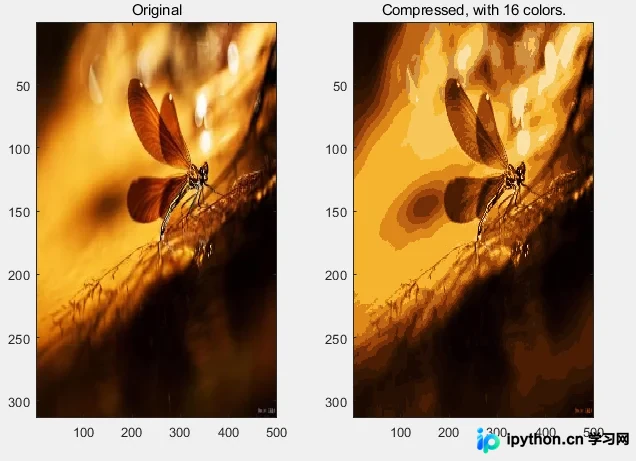
从直观角度来看,这种压缩方式的核心在于用较少的颜色替代原有的大量颜色,从而有效降低图片文件的大小。为了便于理解图片压缩,我们将先介绍K-Means算法的基础知识,最后附上实现图片压缩的核心代码。
K-Means算法的核心思想
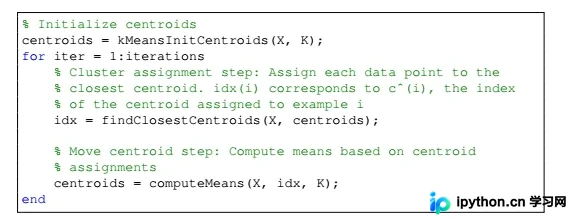
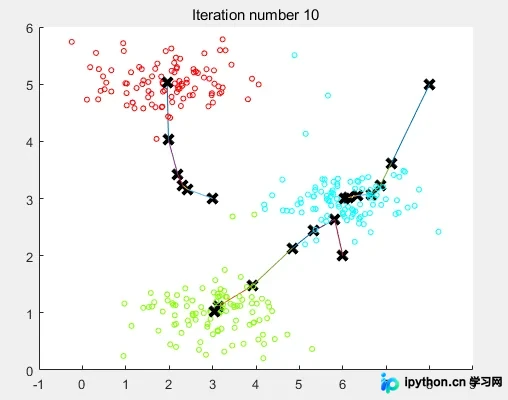
K-Means的核心算法主要包含三个步骤:初始化簇中心、簇分配以及簇中心移动。接下来将分部分详细讲解这三个环节。
初始化簇中心
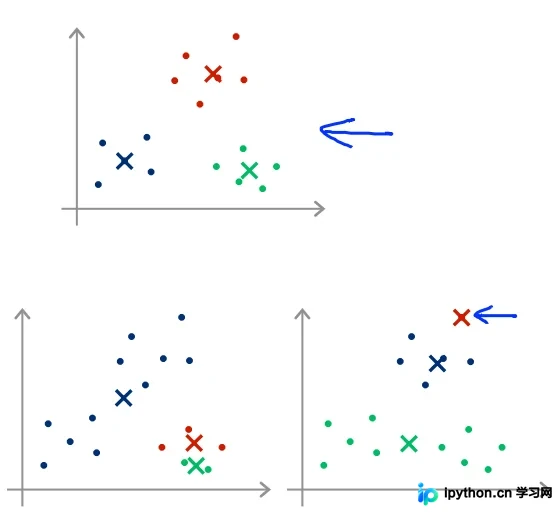
若随机选取簇中心,可能会陷入局部最优解。为打破这一局限,通常需要多次随机取值并计算,以找到更优的初始中心。
代价函数
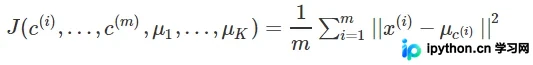
代码实现
J = zeros(100,1);
M = size(X,1);
min = inf;
for i = 1:100
%随机取k个样本点作为簇中心
randidx = randperm(M);
initial_centroids = X(randidx(1:K),:);
%将所得的中心点进行训练
[centroids0, idx] = runkMeans(X, initial_centroids,10);
for k = 1:M
J(i) = J(i) + sum((X(k,:) - centroids0(idx(M),:)).^2);
end
%取最小代价为样本中心点
if(min > J(i))
centroids =centroids0;
end
end
簇分配
将每个样本点分配到距离其最近的簇中心所属的簇中。
tmp = zeros(K,1);
for i = 1:size(X,1)
for j = 1:K
tmp(j) = sum((X(i,:) - centroids(j,:)).^2);
end
[mins,index]=min(tmp);
idx(i) = index;
end
簇中心移动
计算当前簇内所有样本点的均值,并将该均值作为下一个迭代周期的簇中心。
for i = 1:m
centroids(idx(i),:) = centroids(idx(i),:) + X(i,:);
end

for j = 1:K
centroids(j,:) = centroids(j,:)/sum(idx == j);
end
图片压缩
% 加载图片
A = double(imread('dragonfly.jpg'));
% 特征缩减
A = A / 255;
img_size = size(A);
X = reshape(A, img_size(1) * img_size(2), 3);
K = 16;
max_iters = 10;

%开始训练模型
initial_centroids = kMeansInitCentroids(X, K);
[centroids, idx] = runkMeans(X, initial_centroids, max_iters);

%开始压缩图片
idx = findClosestCentroids(X, centroids);
X_recovered = centroids(idx,:);
X_recovered = reshape(X_recovered, img_size(1), img_size(2), 3);
%输出所压缩的图片
subplot(1, 2, 2);
imagesc(X_recovered)
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















