


Python正则表达式re库核心方法详解与实战

本文系统梳理Python中re库的核心功能,深入解析元字符与预定义字符集的使用规则。重点对比match与search函数的匹配差异,详解sub与subn在字符串替换中的不同返回值,并介绍split分割逻辑。此外,通过具体代码示例演示命名捕获组的构建与应用,帮助开发者高效处理文本匹配、替换及提取任务。
正则表达式基础:元字符与预定义字符集
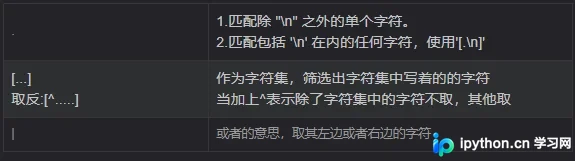
在正则表达式中,元字符是构成模式的基础元素,用于定义匹配规则。
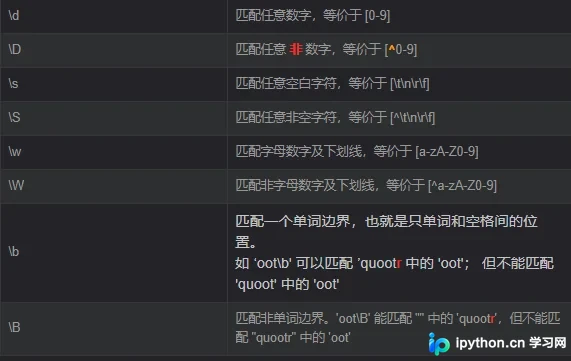
预定义字符集提供了常见的字符类别缩写,如\d、\w等,可简化模式编写。
在实际开发中,组合复杂的正则表达式通常是为了快速复用现成的模式,随后根据具体需求进行微调,从而生成符合特定场景的正则表达式。
import re

# 正则表达式中的一些使用的符号

# 匹配出现符合条件的 0 次的或者是 多次

str1 = 'qwertyuio1ui3oo467j398k'

#  关键词: *    下面的句子就是进行匹配 零次 或者是 多次(多个字符) 符合是数字的意思
pattern = re.compile(r'\d*')
res = re.findall(pattern, str1)
print(res)
""""
显示的结果:
['', '', '', '', '', '', '', '', '', '1', '', '', '3', '', '', '467', '', '398', '', '']
"""
# 关键词: +  匹配一次或者是多次的结果

pattern = re.compile(r'\d+')
res = re.findall(pattern, str1)
print(res)
"""
显示结果:
['1', '3', '467', '398']
"""

# 关键词: ?  匹配0次或者是1次的结果

pattern = re.compile(r'\d?')
res = re.findall(pattern, str1)
print(res)
"""
['', '', '', '', '', '', '', '', '', '1',
'', '', '3', '', '', '4', '6', '7', '',
'3', '9', '8', '', '']
"""

# {m}精确匹配m次  (比如写进去的3,那么他就是匹配到是3个数字字符串的所有小字符串)
pattern = re.compile(r'\d{3}')
res = re.findall(pattern, str1)
print(res)
# 结果:['467', '398']

# {m, n} 最少匹配m次,最多匹配n次
# 记住在{}里面是不能随便加上空格的?
pattern = re.compile(r'\d{1,3}')
res = re.findall(pattern, str1)
print(res)
# 结果:['1', '3', '467', '398']
match与search函数的匹配差异
re库中的match()函数仅检测目标字符串是否在起始位置匹配,若0位置未匹配成功则返回None;而search()函数会扫描整个字符串查找第一个匹配项,只要存在匹配即返回匹配对象。
以下为具体代码实现与解释。
import re
m = re.match('lsp','hhttlsp')
if m is not None:
print(m.group())
else:
print('noneFine')
运行结果显示:
noneFine
n = re.search('lsp','hhttlsp')
if n is not None:
print(n.group())
else:
print(noneFine')
运行结果显示:
lsp
import re
n = re.search('lsp','hhttlsp')
if n:
    print(n.group())
else:
    print('noneFine')
# 显示结果:
# lsp
m = re.match('lsp','hhttlsp')
if m:
    print(m.group())
else:
    print('noneFine')
# 显示结果:
# noneFine
字符串替换:sub与subn详解
Python的re库提供了sub()和subn()两个函数用于实现搜索与替换功能。两者功能相似,均将字符串中符合正则表达式的部分替换为指定内容。替换目标通常为字符串,也可以是返回替换字符串的函数。subn()与sub()的主要区别在于,subn()额外返回一个表示替换次数的整数,并以包含替换后字符串和替换总数的二元组形式返回结果。
# 可以使用sub()方法来进行查询和替换,sub方法的格式为:
# sub(replacement, string[, count=0])
# replacement是被替换成的文本
# string是需要被替换的文本
# count是一个可选参数,指最大被替换的数量

# 下面进行将所有的数字给进行替换掉
pattern = re.compile(r'\d')
res = re.sub(pattern, '替换掉的数字  ',str1)
print(res)
# 下文结果,为了方便大家看到换了多少个数字,我使用了换行将字符串给换行看出有几次换了数字
"""
qwertyuio替换掉的数字
ui替换掉的数字
oo替换掉的数字
替换掉的数字
替换掉的数字
j替换掉的数字
替换掉的数字
替换掉的数字  k
"""
# 加上显示修改了多少次
res = re.subn(pattern, '替换掉的数字 ',str1)
print(res)
"""
结果:
('qwertyuio替换掉的数字
ui替换掉的数字
oo替换掉的数字
替换掉的数字
替换掉的数字
j替换掉的数字
替换掉的数字
替换掉的数字
k', 8)
"""字符串分割:split方法参数说明
re.split(pattern, string, maxsplit=0, flags=0)函数在匹配成功时返回列表,否则返回原字符串列表。
- 第1个参数:正则表达式。
- 第2个参数:待匹配查找的原始字符串。
- 第3个参数:可选参数,指定最大拆分次数,默认为0表示全部分割。
- 第4个参数:可选参数,用于控制正则表达式的匹配标志,如是否区分大小写或多行匹配等。
特别注意:此方法并非完全匹配,仅判断字符串开始位置是否匹配。若pattern结束后仍有剩余字符,匹配仍视为成功。若需完全匹配,应在表达式末尾添加边界匹配符'$'。
str2 = '自然语言处理123机器学习456深度学习'
pattern = re.compile(r'\d+')
res = re.split(pattern, str2)
print(res)
# 结果:
# ['自然语言处理', '机器学习', '深度学习']高级特性:命名捕获组应用
Python的re模块率先支持命名捕获组和命名后向引用,语法为(?P<name>group),可将匹配结果捕获到名为“name”的后向引用中。
str2 = '自然语言处理123机器学习456深度学习'
pattern = re.compile(r'(?P<dota>\d+)(?P<lsp>\D+)')
m = re.search(pattern, str2)
print(m.group('lsp'))
# 结果为:
# 机器学习str2 = '自然语言处理123机器学习456深度学习'
pattern = re.compile(r'(?P<dota>\d+)(?P<lsp>\D+)')
m = re.search(pattern, str2)
print(m.group('dota'))
# 结果为:
# 123以下通过一个小示例演示号码筛选过程。
# 筛选号码
str3 = 'number 132-3209-*******'
pattern = re.compile(r'(\d\d\d-\d\d)')
res = re.search(pattern, str3)
print(res.group())
# 显示结果:
# 132-32完整代码如下。
# -*- coding:utf-8 -*-
# @Author : DaFuChen
# @File : demo1.py
# @software: PyCharm
import re
# 正则表达式中的一些使用的符号
# 匹配出现符合条件的 0 次的或者是 多次
str1 = 'qwertyuio1ui3oo467j398k'
# 关键词: * 下面的句子就是进行匹配 零次 或者是 多次(多个字符) 符合是数字的意思
pattern = re.compile(r'\d*')
res = re.findall(pattern, str1)
print(res)
""""
显示的结果:
['', '', '', '', '', '', '', '', '', '1', '', '', '3', '', '', '467', '', '398', '', '']
"""
# 关键词: + 匹配一次或者是多次的结果
pattern = re.compile(r'\d+')
res = re.findall(pattern, str1)
print(res)
"""
显示结果:
['1', '3', '467', '398']
"""
# 关键词: ? 匹配0次或者是1次的结果
pattern = re.compile(r'\d?')
res = re.findall(pattern, str1)
print(res)
"""
['', '', '', '', '', '', '', '', '', '1',
'', '', '3', '', '', '4', '6', '7', '',
'3', '9', '8', '', '']
"""
# {m}精确匹配m次 (比如写进去的3,那么他就是匹配到是3个数字字符串的所有小字符串)
pattern = re.compile(r'\d{3}')
res = re.findall(pattern, str1)
print(res)
# 结果:['467', '398']
# {m, n} 最少匹配m次,最多匹配n次
# 记住在{}里面是不能随便加上空格的?
pattern = re.compile(r'\d{1,3}')
res = re.findall(pattern, str1)
print(res)
# 结果:['1', '3', '467', '398']
import re
n = re.search('lsp','hhttlsp')
if n:
print(n.group())
else:
print('noneFine')
# 显示结果:
# lsp
m = re.match('lsp','hhttlsp')
if m:
print(m.group())
else:
print('noneFine')
# 显示结果:
# noneFine
# 可以使用sub()方法来进行查询和替换,sub方法的格式为:
# sub(replacement, string[, count=0])
# replacement是被替换成的文本
# string是需要被替换的文本
# count是一个可选参数,指最大被替换的数量
# 下面进行将所有的数字给进行替换掉
pattern = re.compile(r'\d')
res = re.sub(pattern, '替换掉的数字 ',str1)
print(res)
# 下文结果,为了方便大家看到换了多少个数字,我使用了换行将字符串给换行看出有几次换了数字
"""
qwertyuio替换掉的数字
ui替换掉的数字
oo替换掉的数字
替换掉的数字
替换掉的数字
j替换掉的数字
替换掉的数字
替换掉的数字 k
"""
# 加上显示修改了多少次
res = re.subn(pattern, '替换掉的数字  ',str1)
print(res)
"""
结果:
('qwertyuio替换掉的数字
 ui替换掉的数字
 oo替换掉的数字
  替换掉的数字
   替换掉的数字
   j替换掉的数字
   替换掉的数字
    替换掉的数字
    k', 8)
"""
str2 = '自然语言处理123机器学习456深度学习'
pattern = re.compile(r'\d+')
res = re.split(pattern, str2)
print(res)
# 结果:
# ['自然语言处理', '机器学习', '深度学习']
str2 = '自然语言处理123机器学习456深度学习'
pattern = re.compile(r'(?P<dota>\d+)(?P<lsp>\D+)')
m = re.search(pattern, str2)
print(m.group('dota'))
# 结果为:
# 123
# 筛选号码
str3 = 'number  132-3209-*******'
pattern = re.compile(r'(\d\d\d-\d\d)')
res = re.search(pattern, str3)
print(res.group())
# 显示结果:
# 132-32至此,关于Python正则表达式中re库常用方法的总结介绍完毕。如需了解更多Python re库相关内容,请搜索本站历史文章或继续浏览后续文章,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















