


C语言标准库qsort函数用法详解与底层原理

在C语言开发中,针对不同类型数据执行通用排序是一个常见需求。`qsort`函数作为stdlib库提供的通用快速排序接口,能够高效处理整型、浮点型乃至自定义结构体等多种数据结构。本文将拆解其API规范,提供从基础到进阶的代码案例,并揭示其通用的底层实现机制。
qsort API规范与参数解析
`qsort` 函数定义于 <stdlib.h> 头文件中,旨在为开发者提供一套不依赖具体数据类型的排序工具。其标准声明如下:
void qsort(void *base, size_t num, size_t width, int (*compare)(const void *, const void *));要正确调用该函数,需准确理解各参数的含义与作用:
void* base(首地址):指向待排序数组的第一个元素。由于类型被隐式转换为void*,因此它可以兼容任何数据类型的数组指针。size_t num(元素个数):指定数组中包含的元素总数,用于界定排序的范围。size_t width(步长/元素大小):单个元素所占的内存字节数。通常可通过sizeof(arr[0])获取,这是 `qsort` 实现内存搬运和跳跃的关键依据。int (*compare)(...)(比较函数指针):这是一个回调函数。它接收两个指向元素的const void*指针,返回一个整数以决定顺序。返回负值表示前者排在后者之前,正值反之,零则相等。
第1步:实现基本数据类型排序
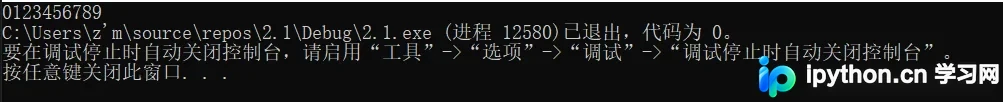
对于原生数值类型,编写一个简单的比较函数即可直接使用 qsort。以下示例演示了对整形数组进行从小到大的排序。
实现逻辑:强制转换传入的指针至目标类型,解引用后进行数值比对。
#include<stdio.h>
#include<stdlib.h>

// 比较函数:升序排列
int cmp_int(const void* e1, const void* e2)
{
	return (*(int*)e1) - (*(int*)e2);
}

void test_sort()
{
	int arr[] = { 1,4,2,6,5,3,7,9,0,8 };
	// 计算数组长度
	int sz = sizeof(arr) / sizeof(arr[0]);

	// 调用 qsort 执行排序
	qsort(arr, sz, sizeof(arr[0]), cmp_int);

	// 验证结果
	for (int i = 0; i < sz; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

int main()
{
	test_sort();
	return 0;
}
第2步:实现结构体的多维排序
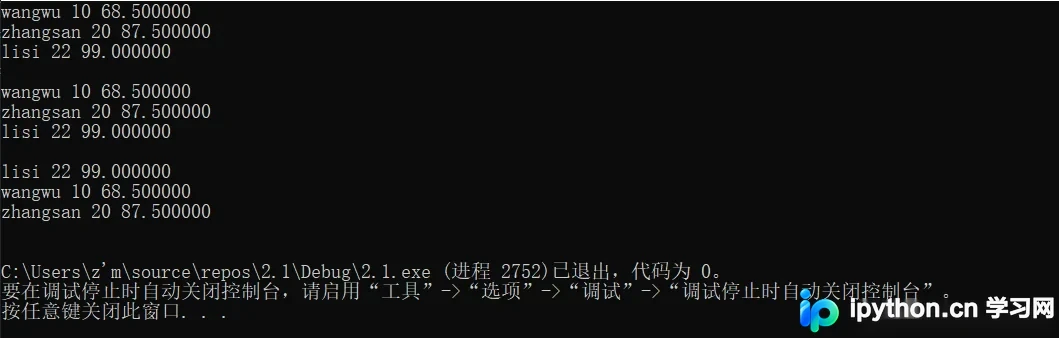
在实际项目中,更多情况需要对包含多种字段的结构体进行复杂条件的排序。此时需要编写对应的回调函数,并通过不同的比较策略实现“按成绩”、“按年龄”或“按姓名”排序。
注意:字符串比较必须使用 strcmp,且涉及浮点数比较时不建议直接相减,此处为了演示简便采用常规方法,实际生产环境中需注意精度问题。
#include<stdio.h>
#include<stdlib.h>
#include<string.h>

struct Stu {
	char name[20];
	int age;
	float score;
};

// 按照成绩排序(从小到大)
int cmp_stu_by_score(const void* e1, const void* e2) {
	if (((struct Stu*)e1)->score > ((struct Stu*)e2)->score)
		return 1;
	else if (((struct Stu*)e1)->score < ((struct Stu*)e2)->score)
		return -1;
	else
		return 0;
}

// 按照年龄排序(从小到大)
int cmp_stu_by_age(const void* e1, const void* e2) {
	return ((struct Stu*)e1)->age - ((struct Stu*)e2)->age;
}

// 按照姓名排序(字典序)
int cmp_stu_by_name(const void* e1, const void* e2) {
	return strcmp(((struct Stu*)e1)->name, ((struct Stu*)e2)->name);
}

void print_stu(struct Stu arr[], int sz) {
	for (int i = 0; i < sz; i++)
		printf("%-10s %d %f\n", arr[i].name, arr[i].age, arr[i].score);
}

void test_struct_sort() {
	struct Stu arr[] = {
		{"zhangsan", 20, 87.5f},
		{"lisi", 22, 99.0f},
		{"wangwu", 10, 68.5f}
	};
	int sz = sizeof(arr) / sizeof(arr[0]);

	printf("--- Original ---\n");
	print_stu(arr, sz);

	printf("--- By Score ---\n");
	qsort(arr, sz, sizeof(arr[0]), cmp_stu_by_score);
	print_stu(arr, sz);

	printf("--- By Age ---\n");
	qsort(arr, sz, sizeof(arr[0]), cmp_stu_by_age);
	print_stu(arr, sz);

	printf("--- By Name ---\n");
	qsort(arr, sz, sizeof(arr[0]), cmp_stu_by_name);
	print_stu(arr, sz);
}

int main()
{
	test_struct_sort();
	return 0;
}
底层原理分析:如何从零实现通用排序
qsort 的核心优势在于“通用性”,这得益于它对内存操作的处理方式。相比于只能处理特定类型(如仅能处理 int)的传统算法(例如经典的冒泡排序),qsort 通过对字节的原子级操作实现了跨类型的复用。
差异1:通用化的比较逻辑
普通冒泡排序内部硬编码了比较运算符 >,而通用排序将比较动作抽象化:if (cmp(...) > 0)。这种设计使得算法不再关心数据的具体内容,只关注比较函数的反馈结果。
差异2:基于字节宽度的内存交换
当确定需要交换两个元素时,通用排序无法直接强转指针进行变量赋值(因为不知道变量多大)。这里通过传入步长 width,以字节(char)为单位逐字节搬运数据,从而安全地交换任意大小的内存块。
// 泛型元素交换函数
void Swap(char* buf1, char* buf2, int width)
{
	int i = 0;
	for (i = 0; i < width; i++)
	{
		char tmp = *buf1;
		*buf1 = *buf2;
		*buf2 = tmp;
		buf1++;
		buf2++;
	}
}

// 使用函数指针实现的冒泡排序版本
void bubble_sort_generic(void* base, int sz, int width, int(*cmp)(const void* e1, const void* e2))
{
	for (int i = 0; i < sz - 1; i++)
	{
		for (int j = 0; j < sz - 1 - i; j++)
		{
			// 利用指针偏移定位当前相邻元素:(char*)base + j*width
			// 传入比较函数,若返回值大于0说明前大后小,需要交换
			if (cmp((char*)base + j * width, (char*)base + (j + 1) * width) > 0)
			{
				Swap((char*)base + j * width, (char*)base + (j + 1) * width, width);
			}
		}
	}
}
上述实现清晰展示了如何通过 char* 指针运算配合 width 来实现对未知类型数据的统一处理。这就是 C 语言标准库在处理泛型编程时的经典思路。
以上就是C语言使用qsort函数进行快速排序与通用排序实现的详细内容,更多关于C语言算法与标准库操作的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















