


Python正则表达式re.search()函数完整指南:参数、标志位与实战解析

本文深入解析Python中正则表达式模块re的search()函数。详细讲解其匹配机制、可选参数flags(如re.I忽略大小写、re.S包含换行符等)的具体含义,并通过多个代码示例演示如何提取字符串、处理分组匹配及使用命名分组。结合HTML解析实战,对比search与findall的区别,帮助开发者掌握高效字符串匹配技巧。
re.search()函数基础与参数说明
re.search()函数用于扫描整个字符串,寻找第一个符合正则表达式的匹配位置。一旦找到成功匹配,即返回一个匹配对象;若全程未找到匹配项,则返回None。
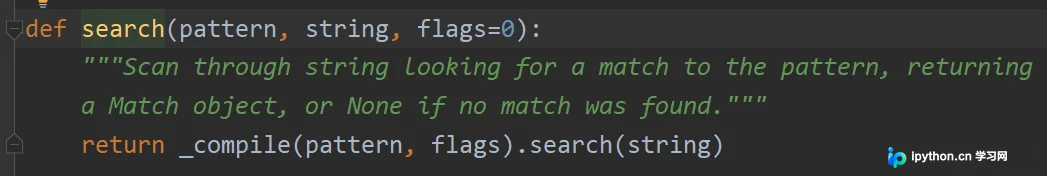
pattern:定义匹配规则的正则表达式字符串。
string:需要被匹配的目标字符串。
flags:可选参数,用于指定匹配模式。例如,若需忽略字符大小写,可通过设置相应的标志位来实现。
flags参数用于控制匹配行为,常见选项包括:
- re.I(或re.IGNORECASE):忽略大小写匹配。
- re.L(或re.LOCALE):使\w、\W、\b、\B、\s、\S等特殊字符集依赖于当前区域设置(locale)。
- re.M(或re.MULTILINE):启用多行模式,此时^和$符号将匹配每一行的开头和结尾,而非整个字符串的开头和结尾。
- re.S(或re.DOTALL):使点号(.)可以匹配包括换行符在内的所有字符,默认情况下点号不匹配换行符。
- re.U(或re.UNICODE):使\w、\W、\b、\B、\d、\D、\s、\S等字符集依赖于Unicode字符属性数据库,适用于处理Unicode字符串。
- re.X(或re.VERBOSE):增加正则表达式的可读性,允许在表达式中包含空格和#号后的注释(除非在字符类中或转义)。
常见匹配标志位flags详解
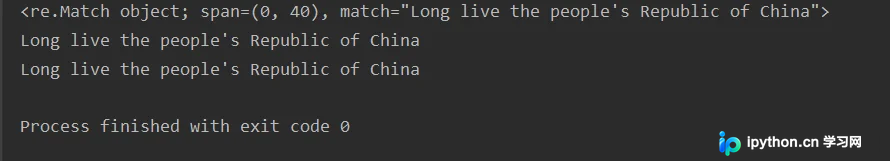
示例代码:【检查字符串是否以 "Long" 开头并以 "China" 结尾】
import re

s = "Long live the people's Republic of China"
ret = re.search("^Long.*China$", s)

print(ret)
print(ret.group())
print(ret[0])
运行结果:
re.search()实战示例与分组提取
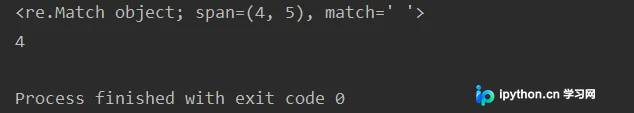
示例代码:【在字符串中搜索第一个空白字符】
import re

s = "Long live the people's Republic of China"
ret = re.search("\s", s)

print(ret)
print(ret.start())
运行结果:
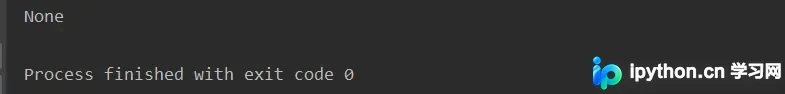
示例代码:【如果search未匹配到,返回None】
import re

s = "Long live the people's Republic of China"
ret = re.search("USA", s)

print(ret)
运行结果:
示例代码:【忽略大小写】
import re

s = "Long live the people's Republic of China"
# ret1 = re.search('long', s)  这行代码直接报错
ret1 = re.search('l', s)
print(ret1)
print(ret1.span())
print(ret1.string)
print(ret1.group())

print("*" * 50)

ret2 = re.search('long', s, re.I)
print(ret2)
print(ret2.span())
print(ret2.string)
print(ret2.group())
运行结果:
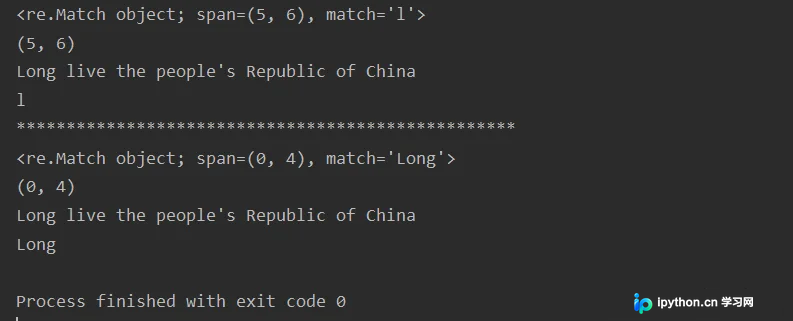
示例代码:【group()的使用】
import re

s = 'abc123def456ghi789'
ret_compile = re.compile("([a-z]*)([0-9]*)([a-z]*)")
print(ret_compile)

ret = ret_compile.search(s)
print(ret)
print(ret.group())
print(ret.group(0))  # group()和group(0) 一样匹配的是整体
print(ret.group(1))  # 匹配第1个小括号的内容
print(ret.group(2))  # 匹配第2个小括号的内容
print(ret.group(3))  # 匹配第3个小括号的内容
运行效果:
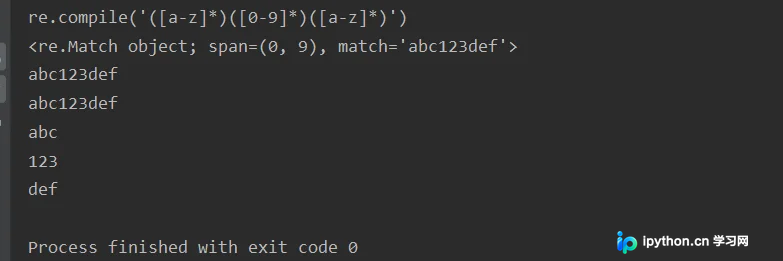
示例代码:【group()分组的使用】
import re

s = 'abc123def456ghi789'
ret_compile = re.compile("(?P<num1>[a-z]*)(?P<num2>[0-9]*)(?P<num3>[a-z]*)")
print(ret_compile)

ret = ret_compile.search(s)
print(ret)
print(ret.group())
print(ret.group(0))  # group()和group(0) 一样匹配的是整体
print(ret.group(1))  # 匹配第1个小括号的内容
print(ret.group(2))  # 匹配第2个小括号的内容
print(ret.group(3))  # 匹配第3个小括号的内容

print("*" * 100)

print(ret.group())
print(ret.group("num1"))  # 这里效果等同于group(1)
print(ret.group("num2"))  # 这里效果等同于group(3)
print(ret.group("num3"))  # 这里效果等同于group(3)
运行效果:
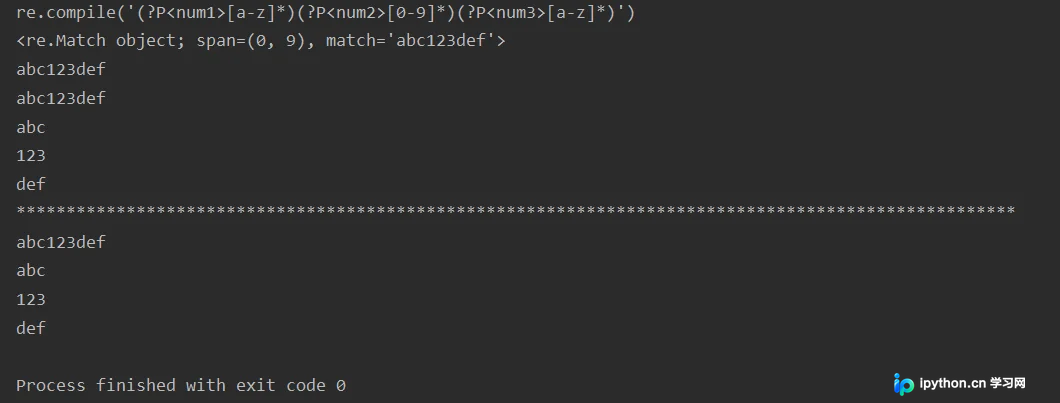
总结:为匹配方便,能用search就不用match,match方法限定匹配时,头部必须是一致的
HTML字符串匹配实战演练
匹配演练:最后我们做些匹配演练,实战下
import re

html='''<div id="songs-list">
    <h2 class="title">经典老歌</h2>
    <p class="introduction">
        经典老歌列表
    </p>
    <ul id ="list" class="list-group">
        <li data-view="2">一路上有你</li>
        <li data-view="7">
            <a href="/2.mp3" singer="任贤齐">沧海一声笑</a>
        </li>
        <li data-view="4" class="active">
            <a href="/3.mp3" singer="齐秦">往事随风</a>
        </li>
        <li data-view="6"><a href="/4.mp3" singer="beyond">光辉岁月</a></li>
        <li data-view="5"><a href="/5.mp3" singer="陈惠琳">记事本</a></li>
        <li data-view="5">
            <a href="/6.mp3" singer="邓丽君"><i class="fa fa-user"></i>但愿人长久</a>
        </li>
    </ul>
</div>
'''
上面是html代码,要求匹配出 第3个li标签中的齐秦 往事随风 ,代码如下:
result = re.search('<li.*?active.*?singer="(.*?)">(.*?)</a>',html,re.S)#re.S确保.能匹配到换行符
if result:
    print(result.group(1),result.group(2))
结果:
齐秦 往事随风
我们还要求匹配出第二个li标签中的内容 任贤齐 沧海一声笑
result = re.search('<li.*?singer="(.*?)">(.*?)</a>',html,re.S)
if result:
    print(result.group(1),result.group(2))
结果:
任贤齐 沧海一声笑
如果匹配时候不需要匹配换行符,那么参数中就没必要带re.S,比如匹配第4个和第5个li标签中的歌手和歌名。但是re.search也仅仅是返回一个符合匹配的结果。如果我们要返回符合匹配的所有结果,要用到re.findall。这一节的re.search就说到这里。
总结
到此这篇关于Python正则表达式re.search()用法详解的文章就介绍到这了,更多相关Python re.search()用法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















