


Python2中CSV文件中文乱码的成因与解决方案

本文详细解析Python2中写入CSV文件出现中文乱码的根本原因,即Python内部Unicode与Windows系统GBK编码的差异。提供了两种解决方案:手动进行decode和encode转换,以及推荐使用codecs模块指定文件编码。通过具体代码示例,展示了如何正确写入单行和多行中文数据,确保中文在Excel中正常显示。
前言
Python2在处理中文编码时存在显著缺陷,遇到中文报错时通常需要先添加u前缀,随后进行各种encode和decode操作。当list、tuple或dict中包含中文时,打印输出往往显示为Unicode编码,这一问题难以直接解决。建议对中文编码处理感到困扰的用户尽快迁移至Python3,Python2的使用需谨慎对待。
CSV中文乱码
1. 使用open打开CSV文件,并通过writer写入包含中文的数据时
writer用于写入单行,writers用于写入多行
# coding:utf-8
import csv

f = open("xieru.csv", 'wb')
writer = csv.writer(f)

# 需要写入的信息
data = ["客户名称", "行业类型", "客户联系人", "职位", "联系方式", "邮箱","地址"]

writer.writerow(data)       # 写入单行
# writer.writerows(datas)    # 写入多行

f.close()
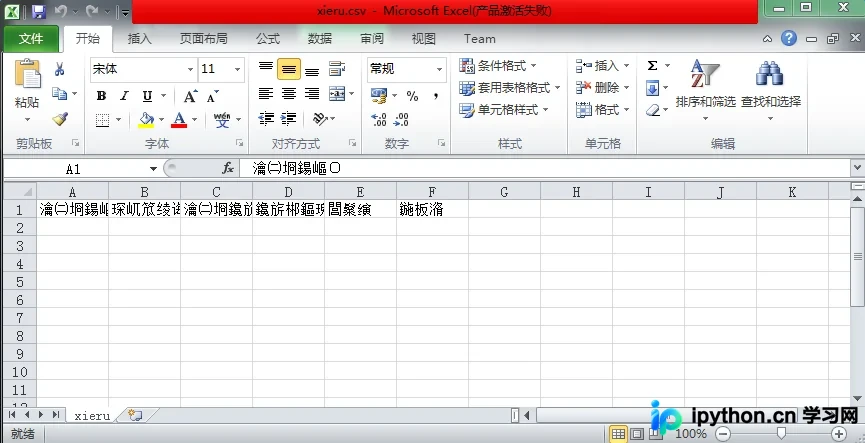
2. 打开生成的CSV文件,发现写入的中文显示为乱码
编码与解码
1. 中文乱码问题一直是Python2的痛点,此处先厘清乱码产生的原因:
- Python2内部代码主要涉及str和unicode两种编码类型
- 然而,当文件写入Windows系统时,Windows系统默认使用gb2312编码
因此导致了乱码问题的出现
2. 解决方法:先将Python中的中文字符串decode为utf-8,再encode为gbk编码
data.decode('utf-8').encode('gbk')3. 如果是读取CSV文件,则执行相反的操作:
data.decode('gbk').encode('utf-8')解决方案
1. 方案一:对字符串进行编码转换(此方法较为繁琐,不推荐)
# coding:utf-8
import csv

f = open("xieru1.csv", 'wb')
writer = csv.writer(f)

# 需要写入的信息
data = ["客户名称", "行业类型", "客户联系人", "职位", "联系方式", "邮箱","地址"]

a = []
for i in data:
    a.append(i.decode("utf-8").encode("gbk"))

writer.writerow(a)           # 写入单行
# writer.writerows(datas)    # 写入多行

f.close()
2. 方法二:使用codecs提供的open方法指定打开文件的语言编码,该方法会在读取时自动转换为内部unicode(推荐)
# coding:utf-8
import csv, codecs

import sys
reload(sys)
sys.setdefaultencoding('utf8')

f = codecs.open("xx.csv", 'wb', "gbk")
writer = csv.writer(f)
writer.writerow(["客户名称", "行业类型", "客户联系人", "职位", "联系方式", "邮箱","地址"])

# 多组数据存放list列表里面
datas = [
    ["客户名称", "行业类型", "客户联系人", "职位", "联系方式", "邮箱","地址"],
    ["客户名称", "行业类型", "客户联系人", "职位", "联系方式", "邮箱","地址"],
    ["客户名称", "行业类型", "客户联系人", "职位", "联系方式", "邮箱","地址"],
       ]

writer.writerows(datas)
f.close()
Python写入CSV文件时的乱码问题
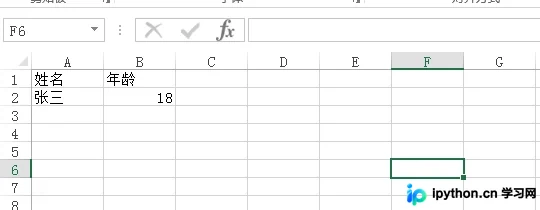
今日在使用Python的csv库将数据写入CSV文件时,遇到了中文乱码问题。解决方法是在写入文件前,先指定utf-8编码,具体操作如下:
import csv
import codecs
if __name__ == "__main__":
    file_name = "data.csv"
    with open(file_name, "wb") as f:
        f.write(codecs.BOM_UTF8)
        csv_write = csv.writer(f)
        csv_write.writerows([["姓名", "年龄"], ["张三", 18]])
生成的CSV文件正确显示了中文内容。
至此,关于Python写入CSV文件时乱码问题的介绍到此结束。更多相关Python写入CSV文件乱码的内容,请搜索本站以前的文章或继续浏览下面的相关文章。希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















