


Python写入Access .mdb出现中文乱码怎么办

使用 Python 向老版本的 Access .mdb 数据库写入中文内容时,经常会出现数据变成问号(???)、生僻字串或乱码符号的现象。造成这一问题的核心原因在于:Python 3 默认在内存中使用标准的 Unicode(UTF-8)字符串,而 Windows 环境下的 Microsoft Access 经典 .mdb 文件(Access 97-2003 格式)在底层由 Windows Jet 引擎驱动,其文本字段默认依赖系统的 ANSI 代码页(中文 Windows 下通常为 GBK / CP936)。如果通过 ODBC 连接时未能正确指定连接编解码协议,或者驱动层在传输双字节宽字符时截断或误匹配了编码表,中文乱码就会随之产生。解决此问题无需更换数据库引擎,只需明确数据链路中各节点的字符集对应关系,并在 pyodbc 连接层与数据输入层配置正确的编码规则即可彻底解决。
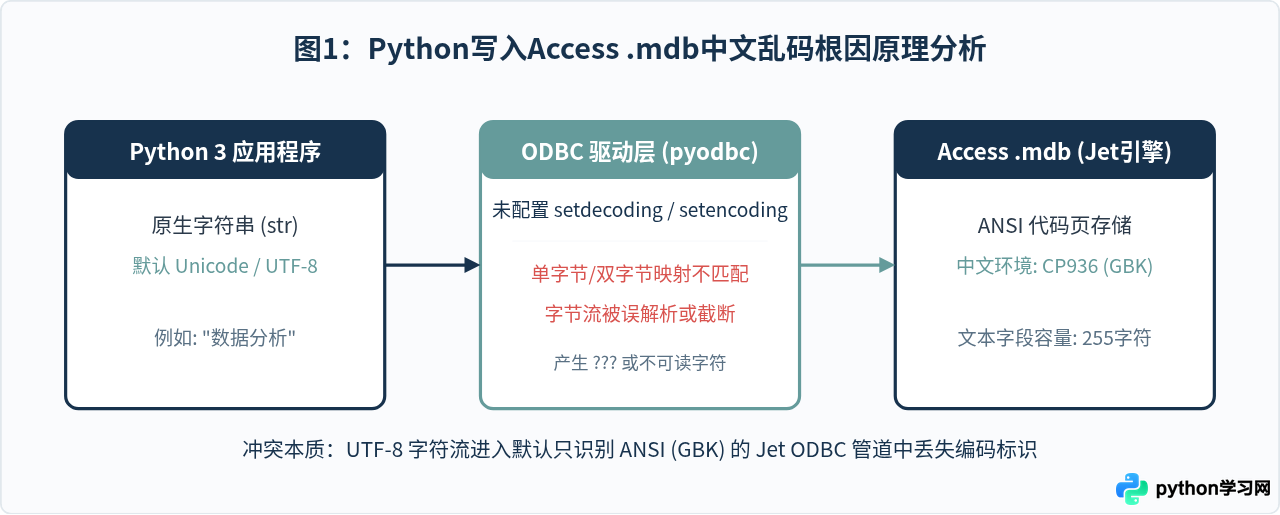
一、排查乱码的具体表现与检查路径
在着手编写修复代码前,需要先明确乱码的具体表现形式。不同的表现通常对应不同的链路节点缺失:
- 全变成问号(如
???):这说明 UTF-8 字符串在进入 ODBC 驱动层转换为 ANSI 时发生了字符映射丢失,驱动或数据库不支持多字节字符转换,直接退化为默认替代字符?。 - 生僻汉字与乱码符号相间(如
Îı¾或²âÊÔ):典型的是将原本按照 GBK 编码存储的双字节数据错误当成 ISO-8859-1 或 Windows-1252 解码;或者是 UTF-8 字节流被当成 GBK 显示。 - 插入直接报错(如
String data, right truncated):由于 UTF-8 编码的一个汉字通常占用 3 个字节,而 Access.mdb的文本字段(Text)有长度上限(最大 255 字节),若驱动将 3 字节 UTF-8 原样当单字节传参,极易导致字段长度溢出截断。
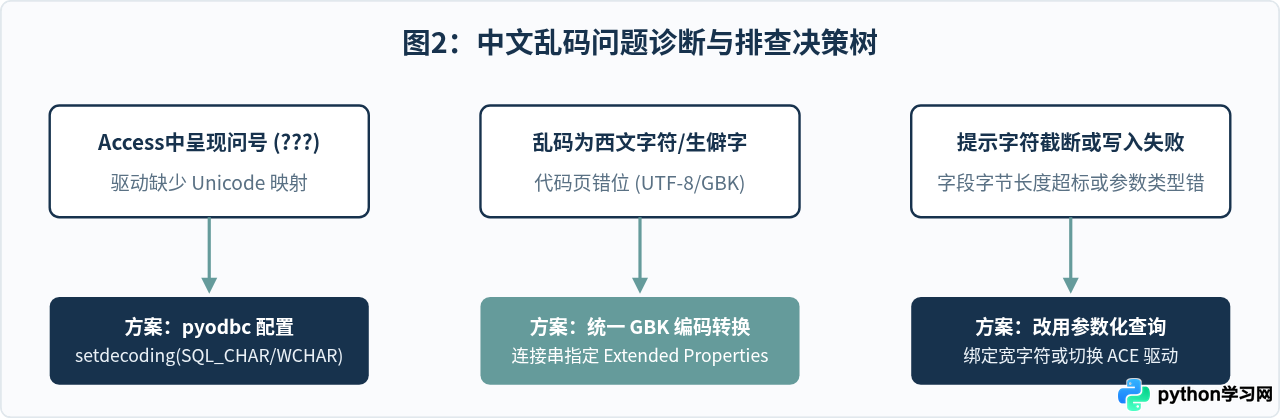
二、核心解决方案:配置 pyodbc 字符编解码规则
在 Python 中连接 .mdb 最常用的驱动库是 pyodbc。Python 3 中 pyodbc 引入了对不同 SQL 数据类型的显式编码声明接口。只要在建立连接后,通过 setdecoding 和 setencoding 正确告知底层驱动如何在 Unicode 和系统的 ANSI(GBK)之间转换,即可完全避免乱码。
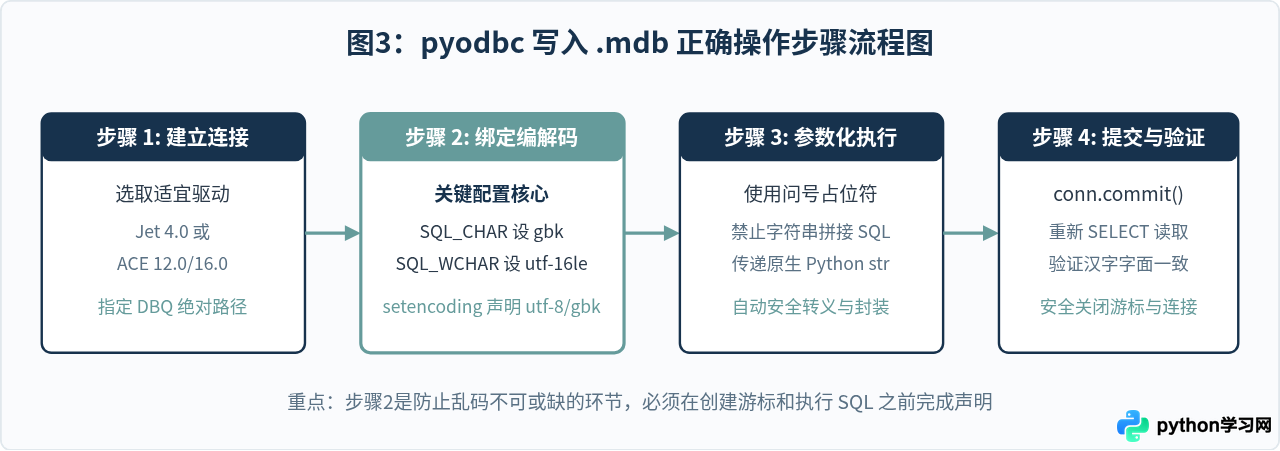
完整代码示例
以下代码展示了针对 Windows 环境下 Access .mdb 文件进行中文安全写入与读取验证的完整实现:
import os
import pyodbc

# 1. 准备 .mdb 数据库文件路径(使用绝对路径)
db_path = os.path.abspath("test_database.mdb")

# 2. 构造连接字符串
# 优先选用 ACE 驱动(支持更多现代特性),若无则使用 Microsoft Access Driver (*.mdb)
conn_str = (
    r"DRIVER={Microsoft Access Driver (*.mdb, *.accdb)};"
    rf"DBQ={db_path};"
)

# 兼容仅安装了旧版 Jet 驱动的环境
try:
    conn = pyodbc.connect(conn_str)
except pyodbc.Error:
    conn_str = (
        r"DRIVER={Microsoft Access Driver (*.mdb)};"
        rf"DBQ={db_path};"
    )
    conn = pyodbc.connect(conn_str)

# 3. 关键步骤:设置连接字符编解码规则
# Access 的单字节/ANSI 字段使用 GBK/CP936 编码
conn.setdecoding(pyodbc.SQL_CHAR, encoding='gbk')
conn.setdecoding(pyodbc.SQL_WCHAR, encoding='utf-16le')

# 向数据库写入文本参数时的编码配置
conn.setencoding(encoding='gbk')

cursor = conn.cursor()

# 4. 创建测试表(如果尚未存在)
cursor.execute("""
    IF NOT EXISTS (SELECT * FROM MSysObjects WHERE Name = 'Staff' AND Type = 1)
    BEGIN
        CREATE TABLE Staff (
            ID AUTOINCREMENT PRIMARY KEY,
            Name TEXT(50),
            Department TEXT(100),
            Remark MEMO
        )
    END
""")
conn.commit()

# 5. 采用参数化查询写入中文数据(切忌直接拼接 SQL 字符串)
insert_sql = "INSERT INTO Staff (Name, Department, Remark) VALUES (?, ?, ?)"
data_row = ("张三", "技术研发部", "负责系统架构与中文编码处理")

cursor.execute(insert_sql, data_row)
conn.commit()

# 6. 读取验证写入结果
cursor.execute("SELECT ID, Name, Department, Remark FROM Staff WHERE Name = ?", ("张三",))
row = cursor.fetchone()
if row:
    print(f"验证成功: ID={row[0]}, 姓名={row[1]}, 部门={row[2]}, 备注={row[3]}")

# 7. 释放资源
cursor.close()
conn.close()conn.setdecoding(pyodbc.SQL_CHAR, encoding='gbk'):告诉pyodbc,数据库返回的标准CHAR/TEXT类型的 ANSI 字节流应按照系统的gbk解码为 Python 的字符串。conn.setdecoding(pyodbc.SQL_WCHAR, encoding='utf-16le'):Windows ODBC 内部的宽字符类型通常采用UTF-16LE存储,显式绑定可防止多字节宽字符解析错乱。conn.setencoding(encoding='gbk'):在将 Python 字符串作为参数传递给底层驱动时,显式转换为gbk字节流,杜绝驱动因无法处理 UTF-8 而将其替换为问号。
三、常见原因与进阶排查方案
1. 必须使用参数化查询,避免拼接 SQL
很多初学者喜欢直接使用字符串格式化构建 SQL 语句,例如:cursor.execute(f"INSERT INTO Staff (Name) VALUES ('{name}')")。这种写法在面对 .mdb 驱动时极易出问题:
- 拼接的 SQL 字符串会被当做整条查询命令由驱动统一解释。如果驱动接收到的整个命令缓冲区存在字符集识别歧义,中文字面量很容易在语法解析阶段就被截断或替换。
- 使用
cursor.execute("INSERT ... VALUES (?)", (name,))占位符方式,pyodbc会走 ODBC 参数绑定接口(SQLBindParameter),能够精确利用上文中通过setencoding设置的字符编码规则,保障每一个汉字安全入库。
2. 驱动版本差异:Jet 4.0 驱动 vs ACE 引擎驱动
Windows 上操作 .mdb 有两套主要的驱动:旧版 32 位的 Microsoft Jet 4.0 驱动(Microsoft Access Driver (*.mdb)),以及随 Office/Access Database Engine 发布的 Microsoft ACE 驱动(Microsoft Access Driver (*.mdb, *.accdb))。两者的差异如下:
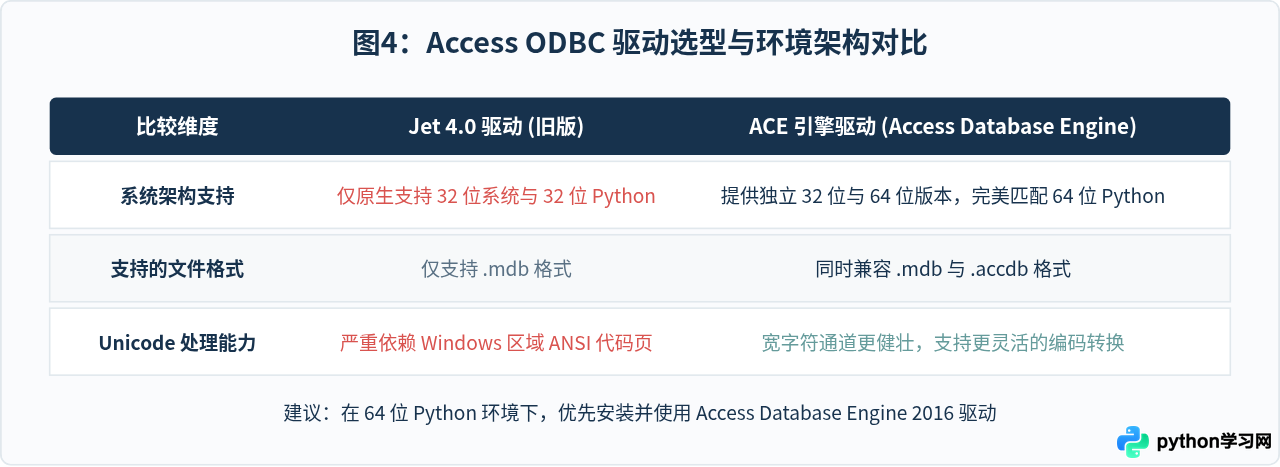
3. Windows 系统区域设置与非 Unicode 程序语言
如果将 Python 程序部署到英文版 Windows Server 或 Docker 容器中,可能会发现即便设置了 gbk 依然乱码。这是因为 Windows 底层默认的 ANSI 代码页是 Windows-1252(西欧语言),缺少对中文字符集的映射支持:
- 系统设置检查:进入 Windows “控制面板” -> “时钟和区域” -> “区域” -> “管理” 选项卡,查看“非 Unicode 程序的语言”。如果不是“中文(简体,中国)”,底层 ANSI 代码页就不会是 CP936。
- 针对容器或英文系统的对策:如果系统无法更改区域语言,可以在 Python 连接字符串中显式指定编码属性,或者强制使用全宽字符转换:
# 在连接字符串中显式附加字符属性
conn_str = (
    r"DRIVER={Microsoft Access Driver (*.mdb, *.accdb)};"
    rf"DBQ={db_path};"
    r"Extended Properties='text;HDR=Yes;FMT=Delimited;CharacterSet=GB2312';"
)
四、总结与快速排查清单
当 Python 写入 Access .mdb 遭遇中文乱码时,按照以下清单逐条核对,即可在几分钟内解决问题:
- 检查参数化传递:杜绝使用
f-string或%拼接 SQL,统一使用cursor.execute(sql, (val1, val2))语法。 - 配置连接编解码:在
conn = pyodbc.connect(...)之后立即加入conn.setdecoding(pyodbc.SQL_CHAR, encoding='gbk')与conn.setencoding(encoding='gbk')。 - 核对 Python 位数与驱动匹配:64 位的 Python 解释器必须搭配 64 位的 Access ODBC 驱动(Microsoft Access Database Engine 2010/2016),切勿使用 32 位与 64 位混用的不兼容驱动。
- 确认字段长度与类型:中文字符在 Access
TEXT字段中虽然只计为一个字符,但若中间链路驱动以 UTF-8 字节计算长度,可能触发 255 字节上限导致截断;长文本建议使用MEMO(备注)字段存储。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















