


利用Pandas统计DataFrame中逗号分隔列的元素频次

发布时间:2026-10-12 |
3人浏览过
本文介绍如何使用Pandas处理包含逗号分隔数字的列,并通过字典映射将数字转换为对应类别,进而统计每行中各类别出现的频次。核心步骤包括读取数据、构建映射关系、解析字符串并计数,最终输出包含统计结果的DataFrame。
当前需要解决的具体问题如下:
假设我们拥有一个包含多列的数据表格。
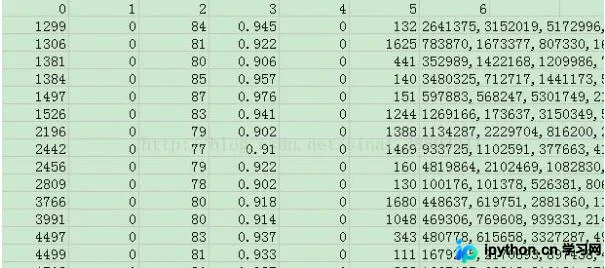
该表格的第7列(索引为6)包含大量由逗号分隔的数字,且这些数字存在特定的对应关系:
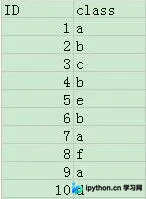
我们的目标是统计第7列中每个数字对应的类别出现次数,即统计每一行中类别a和类别b分别出现了多少次。
针对上述需求,具体的解决思路与代码如下:
#!/bin/python
#-*-coding:UTF-8-*-
import pandas as pd
import numpy as np
dfidspec = pd.read_table("one.txt")#这个是对应关系的文件
dfmgs = pd.read_table("two.txt",header = None)#这个是我们数据的表
def getlistnum(li):#这个函数就是要对列表的每个元素进行计数
  set1 = set(li)
  dict1 = {}
  for item in set1:
    dict1.update({item:li.count(item)})
  return dict1
bigdict = dict(zip(dfidspec['ID'],dfidspec['class']))#获得一个关系的字典
dfmgs['indeo'] = 'a'#在读取的数据框新建一个字符列
for i in range(len(dfmgs.index)):#对每一行进行操作
  spp = [bigdict[int(j)] for j in dfmgs.iloc[i, 6].split(',')]#对于第7列的格子中的每个数进行字典取值
  sppnum = getlistnum(spp)
  dfmgs.iloc[i, 7] = str(sppnum)
dfmgs.to_csv("three.txt",sep = '\t',index = False)
执行该代码后,即可获得预期的统计结果:
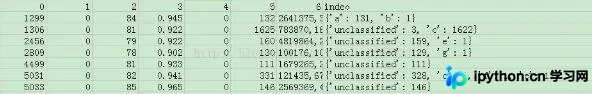
以上关于使用Pandas数据框统计特定列数据对应个数的方法分享完毕,希望能为读者提供有价值的参考,同时也欢迎大家继续支持本站获取更多技术内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















