



在 Linux 服务器上做 JavaScript 日志记录,真正麻烦的往往不是输出一行信息,而是上线后还能不能靠这些日志快速定位问题。很多项目早期只依赖 console.log,等到服务增多、流量变大,才发现日志既不统一,也很难检索。
这篇文章把常见做法整理成 10 条可直接落地的实践,分别覆盖日志格式、级别、切分、轮转、聚合、安全、性能和团队规范。看完之后,你可以据此判断现有项目的日志体系缺了哪一环,也能更清楚哪些配置应该尽早固化到模板和部署流程里。
先把日志写对:结构化、分级、带时间
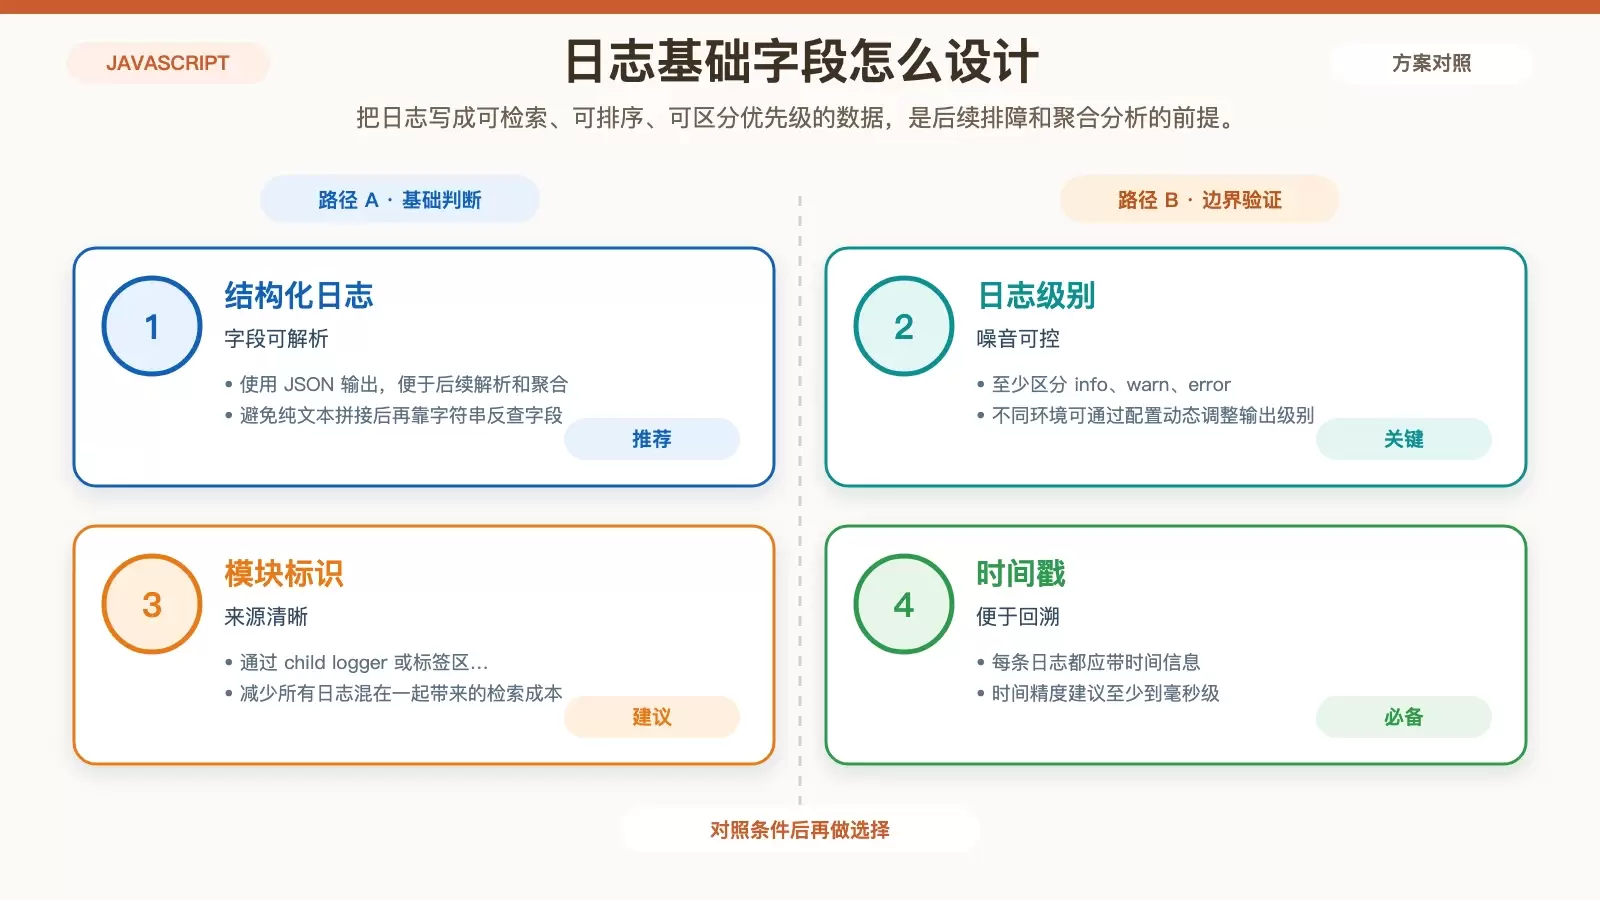
使用结构化日志,优先选择 JSON
纯文本拼接看起来省事,但一旦需要检索、聚合、统计字段,维护成本会迅速上升。更稳妥的做法是直接输出结构化 JSON,让日志平台或脚本后续按字段解析。
const log = require('pino')();
log.info({ message: 'User logged in', userId: '12345' });这种写法的好处是明确:message、userId 之类的字段可以直接用于过滤和聚合,不需要再从字符串里反向拆解。
按场景管理日志级别
日志太少,出问题时没有线索;日志太多,真正重要的内容又会被噪音淹没。通常至少要区分 info、warn、error,并且根据运行环境动态调整输出级别。
const log = require('pino')({ level: 'info' });开发、测试、生产环境对日志密度的需求不同,级别配置最好通过环境变量统一控制,而不是写死在业务代码里。
确保每条日志都带精确时间戳
没有时间信息的日志,基本无法用于排障。尤其在并发请求、任务调度或跨服务调用场景里,时间戳决定了你能不能还原故障发生顺序。
const log = require('pino')({ level: 'info' });
log.info({ timestamp: new Date().toISOString(), message: 'User logged in' });
实践上,建议至少记录到毫秒级,方便和网关、数据库、监控系统的时间线对齐。
日志怎么存才不乱:轮转、分割与集中化
用 logrotate 控制日志体积
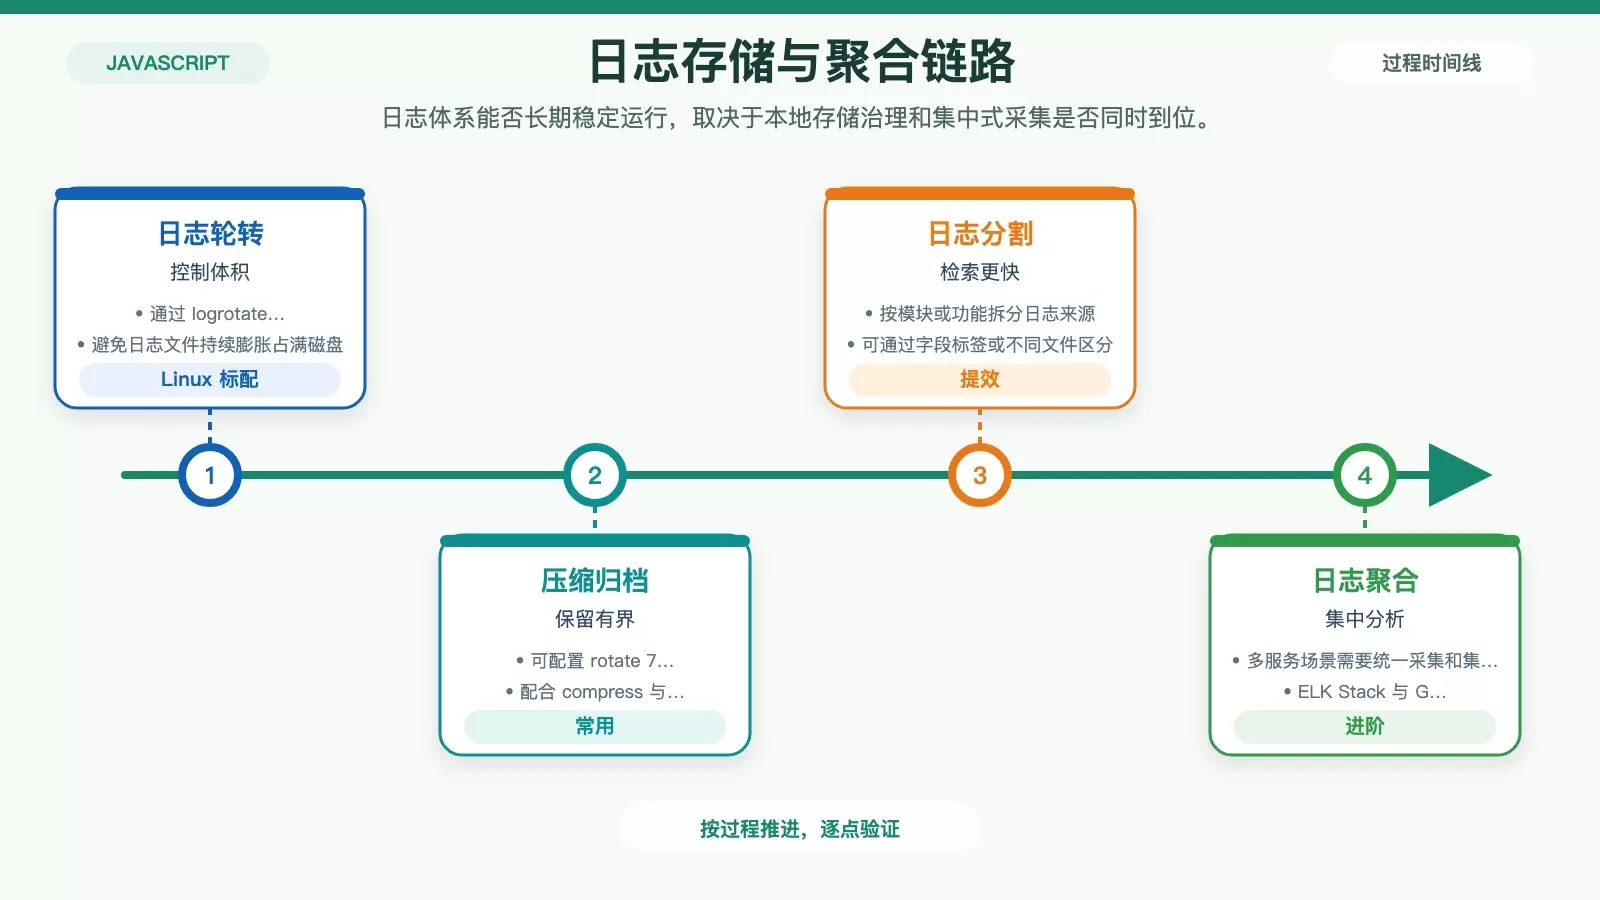
日志文件如果不做治理,磁盘很容易被持续增长的输出占满。Linux 环境里,logrotate 仍然是最常见也最实用的方案,适合处理按天轮转、保留份数和压缩归档这类需求。
/var/log/myapp/*.log {
daily
rotate 7
compress
delaycompress
missingok
notifempty
create 0640 root adm
}这段配置里,daily 表示按天轮转,rotate 7 表示保留 7 份,compress 和 delaycompress 用于压缩历史日志,能明显减少磁盘占用。
按模块或功能拆分日志
把所有内容都写进同一个文件,排查时会非常低效。更合适的做法是按模块、业务域或功能标签区分日志来源,至少让检索范围先缩小一层。
const log = require('pino')({ level: 'info' });
const userLog = log.child({ module: 'user' });
userLog.info('User logged in');
child logger 这种方式很适合 Node.js 应用:既保留统一配置,又能给不同模块自动补充上下文字段。
服务一多,就该接入日志聚合平台
单机环境下直接看文件还勉强可用,但一旦进入多实例、微服务或容器部署,分散日志就会迅速失控。这个阶段需要引入集中式日志平台。
原文提到的两类成熟方案分别是 ELK Stack(Elasticsearch, Logstash, Kibana)和 Graylog。它们的共同价值在于:
- 把多台机器、多套服务的日志集中检索;
- 按字段筛选和统计,减少人工翻找;
- 通过可视化面板快速识别异常趋势。
如果团队已经在用容器或云原生日志采集链路,也可以围绕这些平台做统一收口,关键不是选哪一款,而是不要长期停留在“上服务器手动翻文件”的阶段。
线上项目最容易忽视的两件事:安全和性能
敏感信息必须先过滤再输出
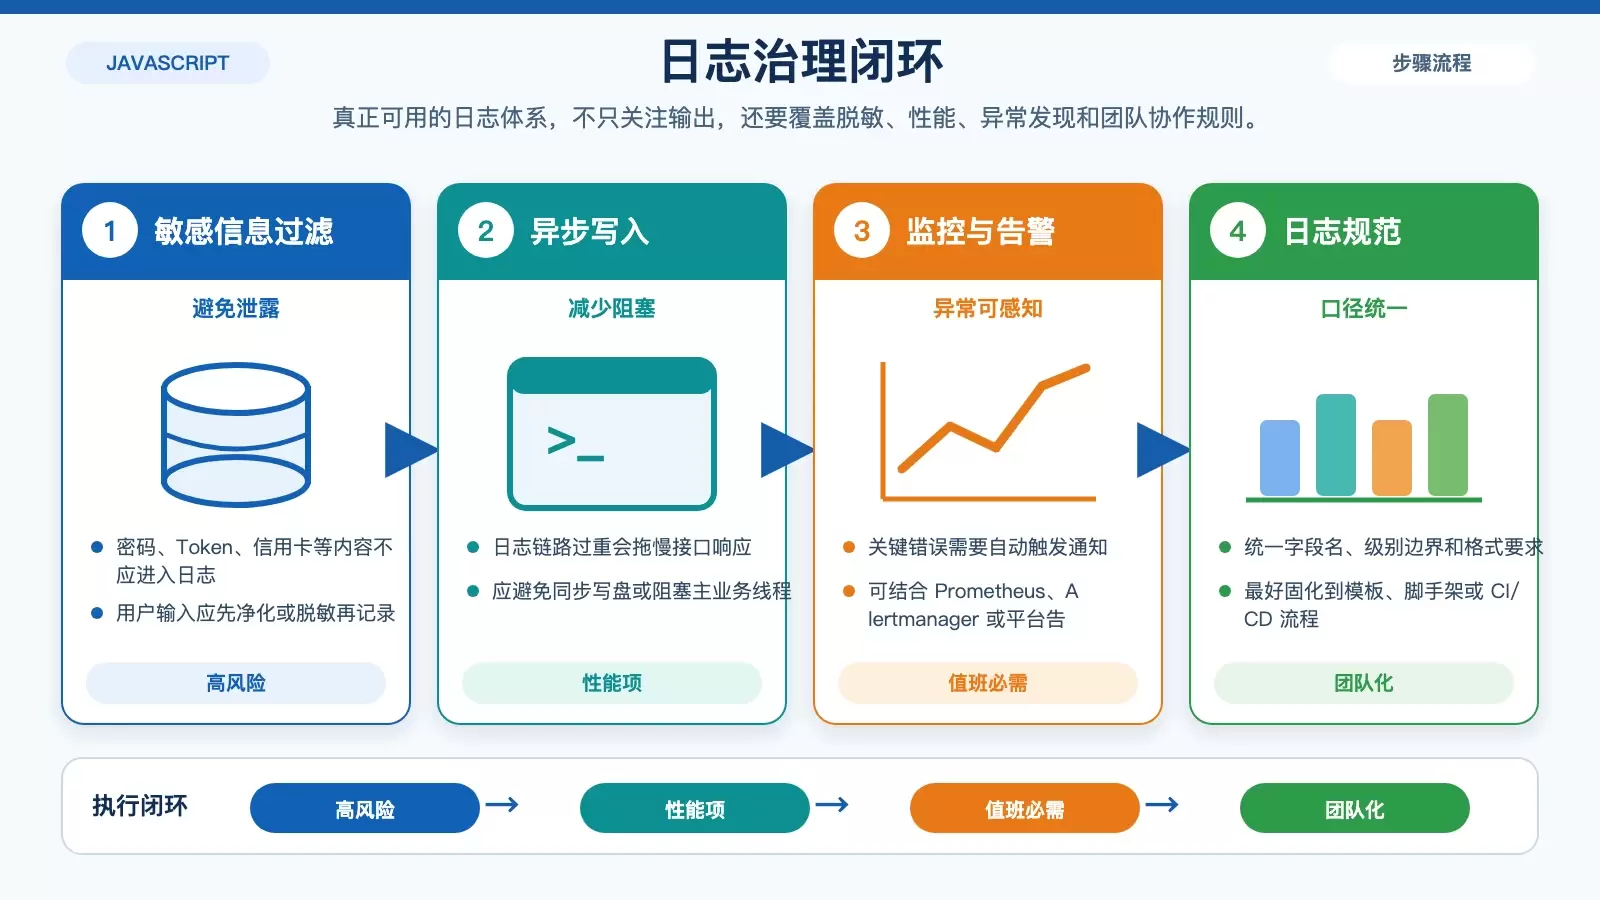
日志里最危险的不是报错,而是把不该出现的数据写了进去。密码、信用卡号、Token、身份凭证一旦进入日志,不仅增加泄露风险,也会让日志平台本身变成高风险资产。
const log = require('pino')();
const sanitize = require('sanitize-html');
const userInput = sanitize(req.body.input);
log.info({ userInput }, 'User input received');
这里示例强调的是“先净化,再记录”的习惯。实际项目里,除了用户输入,还应对认证信息、支付字段、Cookie、请求头等内容设定明确的脱敏规则。
避免日志写入阻塞主流程
如果日志写入本身很重,就会反过来拖慢接口响应。对于高并发服务,这类性能问题往往不是一下子暴露,而是在峰值时被放大。
const log = require('pino')();
log.info('User logged in', { async: true });
原文提到,像 Pino 这类库本身就偏向高性能输出。实践重点是确认日志链路不会因为同步写盘、格式化过重或网络传输阻塞业务线程。
别把日志停留在“写出来”:监控、告警和团队规范
关键错误要接入监控和告警
日志的价值不只是事后排查,还包括在问题刚出现时及时触发通知。对于核心错误、异常峰值、特定关键字或状态码激增,应该尽量建立自动告警。
const log = require('pino')();
log.error({ message: 'Critical error occurred' }, 'Error handling');
可以结合 Prometheus、Alertmanager,或者直接使用日志平台自带的告警规则。重点是把“有人看日志”升级为“系统先发现异常,再通知人处理”。
把日志规范写成团队共识
同一个团队里,如果每个人都按自己的习惯写日志,最后会出现字段名不统一、级别使用混乱、上下文缺失等问题。规范化是让日志真正可用的最后一步。
这份规范至少应该明确以下内容:
- 统一的日志格式,例如是否固定使用 JSON;
- 各级别的使用边界,例如什么情况记
warn、什么情况记error; - 公共字段含义,例如请求 ID、用户 ID、模块名、时间戳;
- 敏感信息过滤和脱敏要求。
当这些规则进入项目模板、脚手架甚至 CI/CD 检查流程后,日志质量才不会完全依赖个人自觉。
结语:好日志体系的目标,是让排障更快而不是输出更多
回头看这 10 条实践,核心其实只有一件事:让日志从“随手打印的信息”变成“能用于运营和排障的系统化数据”。结构化输出解决可读性和可检索性,轮转与聚合解决存储和查找问题,安全、性能与规范则决定这套体系能不能长期稳定运行。
如果你的 JavaScript 项目还停留在 console.log 为主的阶段,最值得优先补齐的通常是三件事:结构化 JSON、清晰的日志级别,以及 Linux 下的轮转与集中化方案。把这些基础打好,后续再接入告警和团队规范,整体维护成本会低很多。















