


Python数据库数值精度设置过高会导致哪些性能问题

在 Python 后端开发与数据库建模过程中,为了避免金额或计量数据的浮点精度丢失,不少工程师习惯在定义字段时“留足余量”,甚至直接声明类似 DECIMAL(65, 30) 或无界 NUMERIC 的列类型。然而,过高的数值精度绝不仅仅是浪费几个字节的磁盘空间,它会形成一条穿透数据库底层存储、网络传输协议、Python 驱动反序列化以及应用运行时计算的全链路性能衰减链路,导致查询吞吐骤降并引发严重的内存与 CPU 负载异常。
一、全链路性能损耗传导机制
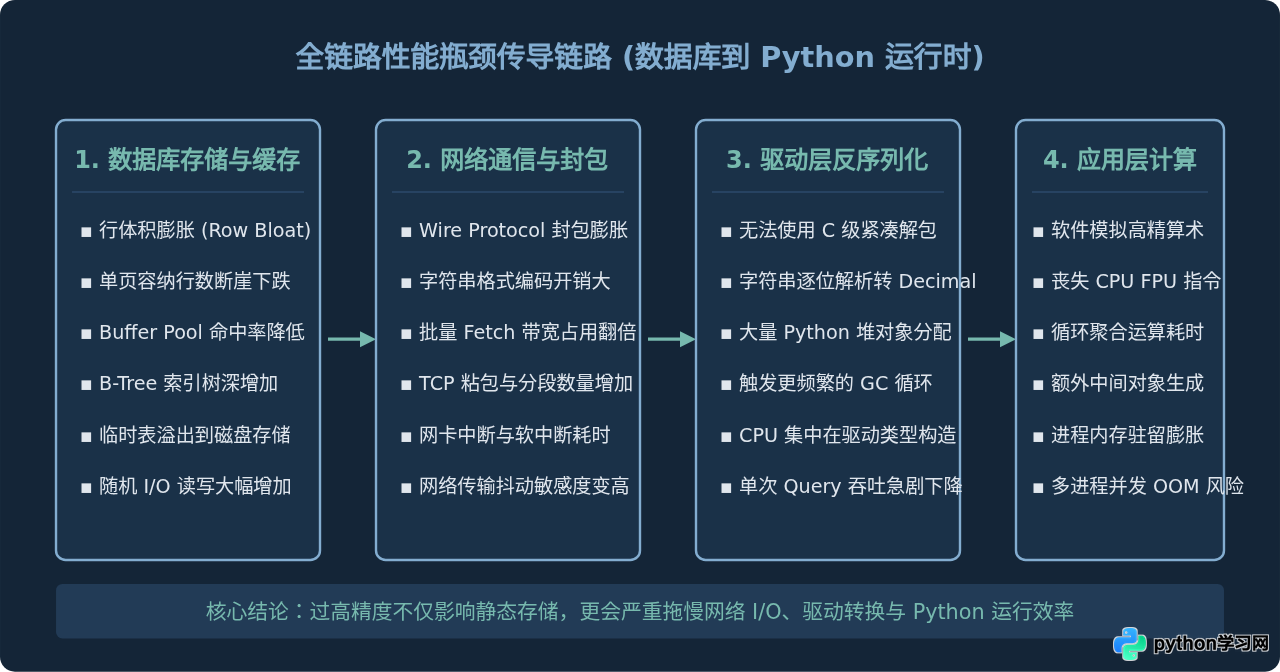
设想一个典型的业务场景:某交易记账系统使用 PostgreSQL/MySQL 作为数据存储,Python 服务使用 SQLAlchemy 配合 psycopg2 或 PyMySQL 提供 API。开发者将原本仅需精确到分(两位小数)的账户余额字段定义为了 DECIMAL(38, 18)。随着数据量突破千万级别并伴随高并发读写,数据库的主频利用率和 API 接口的 P99 延迟均出现了非线性恶化。
这种恶化是层层传导的:在数据库层,冗余精度撑大了数据行体积与索引树高度;在网络层,驱动往往采用文本或大块格式传输高精度数字;在 Python 层面,驱动程序必须针对每行记录动态分配并实例化开销昂贵的 decimal.Decimal 堆对象,并在 CPU 中以软件模拟的方式执行高精度算术。下图完整展示了高精度数值在整个链路中的瓶颈扩散过程:
二、具体性能问题深度剖析
1. 数据库存储膨胀与 Buffer Pool 命中率崩塌
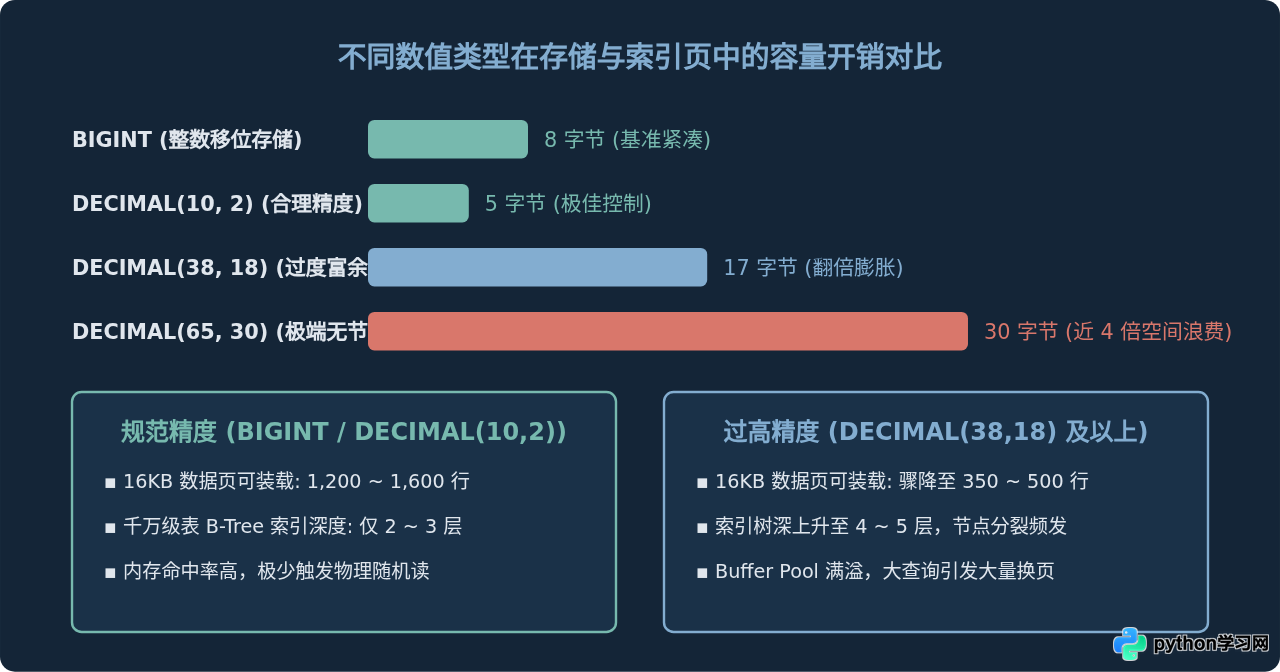
在关系型数据库底层,定点数不是简单的固定 4 字节或 8 字节结构,而是根据声明的精度动态分配存储空间的。以 MySQL InnoDB 为例,它使用每 9 位十进制数字占用 4 个字节的压缩规则:
DECIMAL(10, 2):整数部分 8 位(占用 4 字节),小数部分 2 位(占用 1 字节),共占用 5 字节。DECIMAL(38, 18):整数部分 20 位(占用 9 字节),小数部分 18 位(占用 8 字节),共占用 17 字节。DECIMAL(65, 30):最大精度下占用达到 30 字节。
在 PostgreSQL 中,NUMERIC 带有动态 varlena 头部,过大的精度同样会造成数十字节的存储浪费。当单行存在 4~8 个数值字段时,每行记录就会多出 100~200 字节的无用填充数据。在标准 16KB 的数据页中,单页能够容纳的数据行数直接缩减了 50% 以上。这就导致 B-Tree 索引高度加深、数据页分裂加剧,最关键的是使得数据库的 innodb_buffer_pool(或 PostgreSQL 的 shared_buffers)有效缓存行数大幅下降,大量查询不得不频繁回退至磁盘物理 I/O。
2. 查询优化器失效与排序临时表灾难
在执行 ORDER BY、GROUP BY、DISTINCT 或复杂 JOIN 时,数据库引擎内部需要分配临时内存结构(如 MySQL 的 sort_buffer 与 TempTable 内存引擎)。数据库优化器会根据列定义的最大可能字节数来预估并分配行宽:
-- 当使用高精度字段进行分组与排序时:
SELECT account_id, SUM(balance), AVG(frozen_amount)
FROM user_ledgers
GROUP BY account_id
ORDER BY SUM(balance) DESC;
如果每个定点字段声明的都是 DECIMAL(65, 30),优化器在为排序缓存预估单行大小时,会按最大 30 字节加定长对齐来分配,导致 sort_buffer_size 迅速被填满,进而触发外部归并排序(把数据写入磁盘临时文件进行多路归并)。原本可以在内存中几毫秒完成的聚合查询,耗时会飙升至几百毫秒甚至数秒,磁盘写操作和 IOPS 也会随之飙升。
3. Python 驱动层反序列化成为 CPU 黑洞
这是在 Python 技术栈中往往最容易被忽视的瓶颈。对于 BIGINT 或 FLOAT,数据库驱动(如 asyncpg、psycopg2、mysqlclient 的 C 扩展)直接通过底层的标准 C 指令即可快速将其解包为 Python 的 int 或 float。但是,定点数在底层线协议(Wire Protocol)中通常以字符串或者特殊大整数数组的形式传输。
Python 标准库中的 decimal.Decimal 是一个具有符号、数字元组、指数和上下文状态的复杂对象。驱动在将数据库响应转换为 Python 对象的过程中:
- 驱动必须在 C 扩展层对超长的字符串/字节数组进行边界检查与有效性校验;
- 通过 Python C-API 调用
PyObject_CallFunction动态实例化Decimal; - 高精度数字产生大量的 Python 堆内存分配(Heap Allocation),造成 Python 进程内存碎片化,并在查询结束后触发大规模的垃圾回收(GC),使得整个事件循环或主线程出现明显的微卡顿。
4. Python 运行时算术运算性能断崖
Python 处理原生浮点数(float)使用的是底层 CPU 硬件层面的 64 位双精度浮点寄存器(IEEE 754 标准),现代 CPU 可以在单个时钟周期内执行数条浮点指令。而 decimal.Decimal 即使经过 Python 3 默认的 _decimal(基于 libmpdec 的 C 扩展)加速,依然属于软件模拟的任意精度算法。
我们来看一组具体的 Python 算术基准对比代码:
import time
from decimal import Decimal

TOTAL_ROUNDS = 1_000_000

# 场景 1: 原生硬件加速 float
f_a, f_b = 12345.67, 89.01
start = time.perf_counter()
for _ in range(TOTAL_ROUNDS):
    _ = f_a * f_b
t_float = time.perf_counter() - start

# 场景 2: 常用整数以分存储 (BIGINT 模式)
i_a, i_b = 1234567, 8901
start = time.perf_counter()
for _ in range(TOTAL_ROUNDS):
    _ = (i_a * i_b) // 100
t_int = time.perf_counter() - start

# 场景 3: 合理精度 Decimal(10, 2)
d_a, d_b = Decimal("12345.67"), Decimal("89.01")
start = time.perf_counter()
for _ in range(TOTAL_ROUNDS):
    _ = d_a * d_b
t_dec_std = time.perf_counter() - start

# 场景 4: 过度精度 Decimal(65, 30)
d_high_a = Decimal("12345.670000000000000000000000000000")
d_high_b = Decimal("89.010000000000000000000000000000")
start = time.perf_counter()
for _ in range(TOTAL_ROUNDS):
    _ = d_high_a * d_high_b
t_dec_high = time.perf_counter() - start

# 示例输出数据说明 (环境为 Python 3.11 x86_64 / arm64 Linux 示例运行):
# float: ~0.021s (硬件级吞吐)
# int scaled: ~0.038s (整数高效计算)
# Decimal(10, 2): ~0.095s (约为 float 的 4~5 倍耗时)
# Decimal(65, 30): ~0.245s (约为 float 的 10~12 倍耗时)
如果批量从数据库拉取 10,000 条数据并在内存中进行报表统计、加权均值或税率分摊计算,高精度 Decimal 产生的 CPU 累计耗时将比常规整数移位方案高出一个数量级,这在 CPU 密集型的任务中往往会迅速占满整个 Worker 进程。
三、精度治理四步排查与优化实操
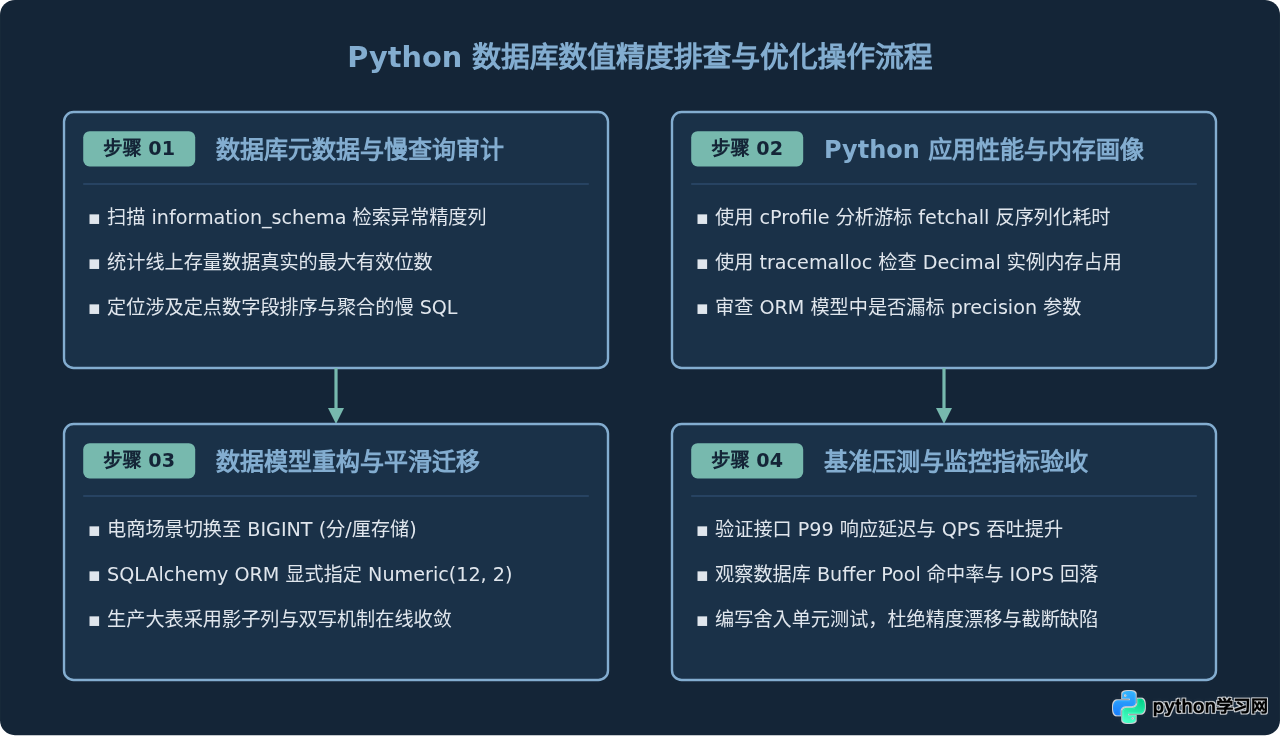
解决精度过高的问题需要遵循一套严谨的工程步骤。不能未经评估直接在线上执行 ALTER TABLE,否则容易导致大表锁死、写入阻塞或精度截断异常。建议按照以下四步流程稳步推进:
第一步:运行 SQL 扫描不合理精度列
在数据库端,优先通过 information_schema 快速排查整个库中存在过高精度的列(例如总位数大于 18 或小数位大于 6 的字段):
-- MySQL 快速排查超高定点数列
SELECT
    TABLE_SCHEMA,
    TABLE_NAME,
    COLUMN_NAME,
    DATA_TYPE,
    NUMERIC_PRECISION,
    NUMERIC_SCALE
FROM INFORMATION_SCHEMA.COLUMNS
WHERE DATA_TYPE IN ('decimal', 'numeric')
  AND (NUMERIC_PRECISION > 18 OR NUMERIC_SCALE > 6)
  AND TABLE_SCHEMA NOT IN ('mysql', 'information_schema', 'performance_schema', 'sys');
第二步:排查 Python ORM 映射定义
在 SQLAlchemy 等常见 ORM 中,如果定义 Column(Numeric) 时没有指定 precision 与 scale,某些数据库方言会默认使用支持的最大精度(如 PostgreSQL 会直接退化为无界 NUMERIC,MySQL 可能会使用 DECIMAL(10, 0) 或 DECIMAL(65, 30) 产生差异行为)。必须显式约束:
from sqlalchemy import Column, Integer, Numeric, BigInteger
from sqlalchemy.orm import declarative_base

Base = declarative_base()

# 【不推荐写法】:未明确精度,引发数据库无界或过高精度,反序列化成本高
class BadAccount(Base):
    __tablename__ = "bad_accounts"
    id = Column(Integer, primary_key=True)
    balance = Column(Numeric)  # 容易产生 DECIMAL(65, 30) 或无界 NUMERIC

# 【推荐写法 1】:显式指定业务所需的真实精度(例如最大千亿级金额,精确到分)
class OptimizedAccount(Base):
    __tablename__ = "optimized_accounts"
    id = Column(Integer, primary_key=True)
    balance = Column(Numeric(precision=14, scale=2), nullable=False)

# 【推荐写法 2】:最高效的金额方案——以分/厘为单位,采用 BIGINT 整数存储
class HighPerformanceAccount(Base):
    __tablename__ = "hp_accounts"
    id = Column(Integer, primary_key=True)
    # 以分为单位,9,223,372,036,854,775,807 分足以支撑全球级计费业务
    balance_in_cents = Column(BigInteger, nullable=False, default=0)
第三步:线上大表平滑迁移避免锁表
对于存量过千万的表,切忌直接执行 ALTER TABLE tbl MODIFY balance DECIMAL(14,2);,这会引发长时间的行级排他锁或全表重建,甚至阻塞主从同步复制。标准生产重构步骤为:
- 在目标表中增加新格式的影子列(例如
balance_v2 BIGINT或balance_v2 DECIMAL(14,2)); - 在 Python 业务层上线双写逻辑:所有新写入和更新同时写
balance和balance_v2; - 编写带限速的后台批量脚本,按主键分段将历史数据转换回填至影子列;
- 校验两列数据一致性,确认误差为 0;
- 将 Python 读取逻辑切换至新列,验证业务无误后下发 DDL 异步删除旧列。
四、业务数值选型决策与总结
数值精度的选择绝不是“越高越保险”,而是系统资源利用与业务业务保真度之间的工程权衡。下表与总结矩阵给出了常见核心业务场景的推荐规范:
| 业务场景 | 推荐数据库类型 | Python 对应类型 | 单值存储 | 核心优势与选型理由 |
|---|---|---|---|---|
| 常规电商订单 / 账户余额 | BIGINT (以分或厘为单位) |
int |
8 字节 | 硬件原生整数运算,零序列化开销,杜绝任何浮点截断或舍入争议。 |
| 标准商业财务 / 报表对账 | DECIMAL(14, 2) ~ (16, 4) |
Decimal |
6~8 字节 | 严格满足法定财务会计标准,存储紧凑,单页行密度高。 |
| 外汇汇率 / 基金净值 / 风控系数 | DECIMAL(18, 6) ~ (20, 8) |
Decimal (指定上下文精度) |
9~10 字节 | 保留多位小数确保连乘时不失真,严格规避无界 NUMERIC。 |
| 科学测量 / 地理坐标 / 传感器时序 | DOUBLE PRECISION / FLOAT |
float / numpy.float64 |
8 字节 | 完全利用 CPU FPU / SIMD 向量化指令集,计算吞吐最高可提升 50 倍。 |
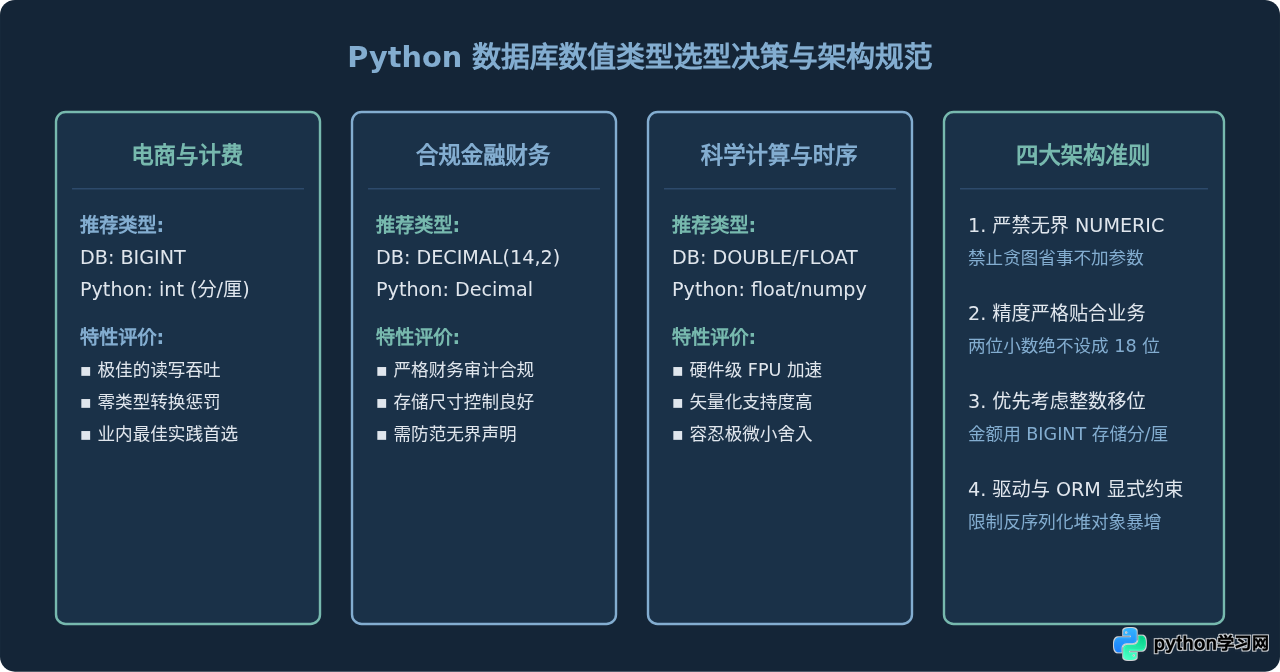
架构提示:在微服务与高并发系统中,性能优化往往来自细节的克制。审视数据字典中那些随手写下的 DECIMAL(38, 18),将其收敛为明确的 DECIMAL(14, 2) 或 BIGINT,不仅能立即降低数据库 Buffer Pool 压力与网络带宽,更能在 Python 侧消除大量因 Decimal 反序列化与软件模拟计算所浪费的宝贵 CPU 周期。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















