


Python从数据库读取高精度Decimal后比较失败的原因与解决
深入解析Python从数据库读取高精度Decimal数据后比较失败的底层原因,涵盖驱动类型降级、float与Decimal混用隐患、全局上下文精度截断及Scale对齐问题,并提供全流程排查与工程修复方案。
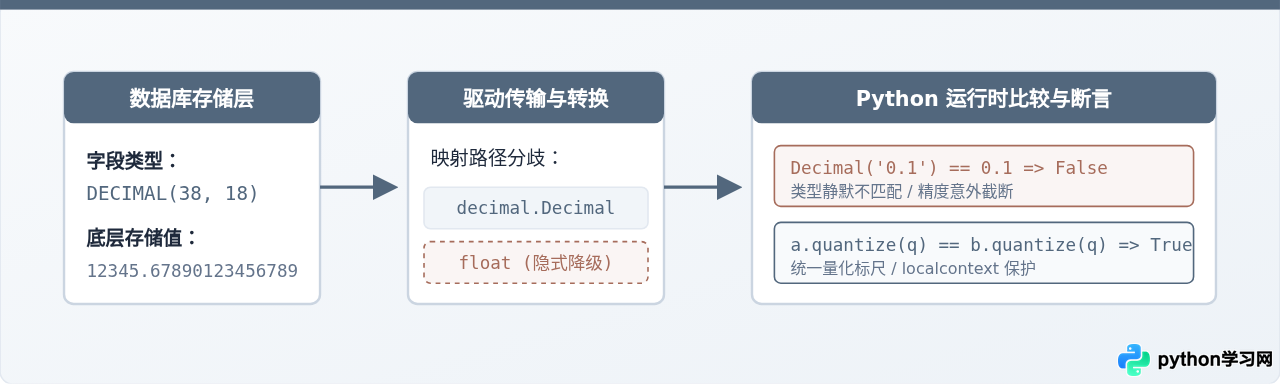
DECIMAL 或 NUMERIC 字段后,在 Python 中进行相等性或大小比较失败,通常并非数据库数据出错,而是由三大技术断层引起的:驱动层将特定查询(如聚合或原生查询)隐式反序列化为 float 导致精度丢失与类型不匹配;Python 中 Decimal 与 float 进行 == 比较时静默返回 False;或者 Python 全局 decimal.getcontext().prec 精度上限截断了超长小数位。解决这一问题的标准路径是锁定数据库驱动的类型转换映射、隔离局部高精度上下文,并使用统一的 quantize() 规范化比较。
一、具体表现:那些“看似相同”却比对失败的典型现场
在涉及金融对账、加密货币交易、精密科学计量等系统中,数据库表结构通常将金额或物理量定义为 DECIMAL(36, 18) 或 NUMERIC(20, 8)。开发者在 Python 服务中查询该字段并进行业务校验时,往往会遭遇令人困惑的比较失败。
最常见的第一类现场是静默断言失败。程序没有抛出任何异常,但相等判断始终不通过:
# 从数据库读取出的 balance,以及本地计算的 expected_balance
db_balance = get_user_balance_from_db(user_id=1001)
expected_balance = 1250.50

# 预期为 True,实际运行结果为 False
if db_balance == expected_balance:
    approve_transaction()
else:
    # 逻辑永远跌入此分支,导致业务流程异常中断
    reject_transaction(reason="余额校验不匹配")
第二类现场是类型比较错误(TypeError)。当进行大小判定(<、<=、>、>=)时,程序直接崩溃抛出 TypeError: '<' not supported between instances of 'decimal.Decimal' and 'float'。
第三类现场则更加隐蔽:两个数值通过 print() 打印在控制台看起来一模一样,但比较结果依旧是 False,或者经由中间计算(如加减基准数)后,精度末位出现微小偏移导致校验失败。这直接反映出数据在流转过程中的类型转换和上下文处理存在盲区。
二、深度剖析:导致比较失败的三大根源机制
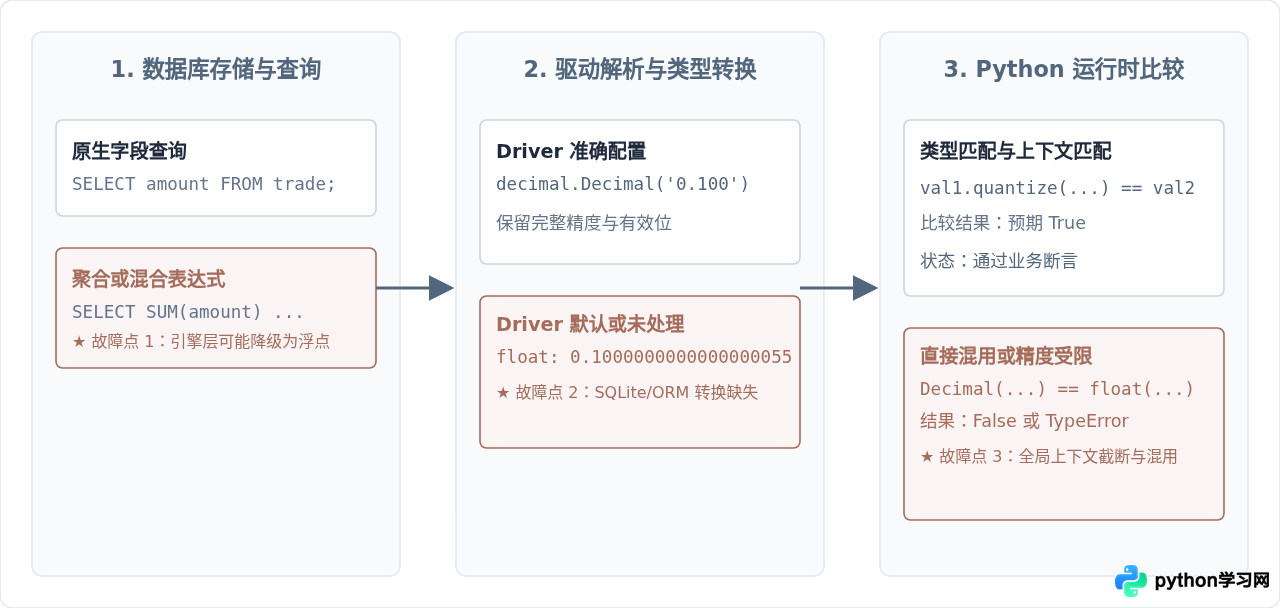
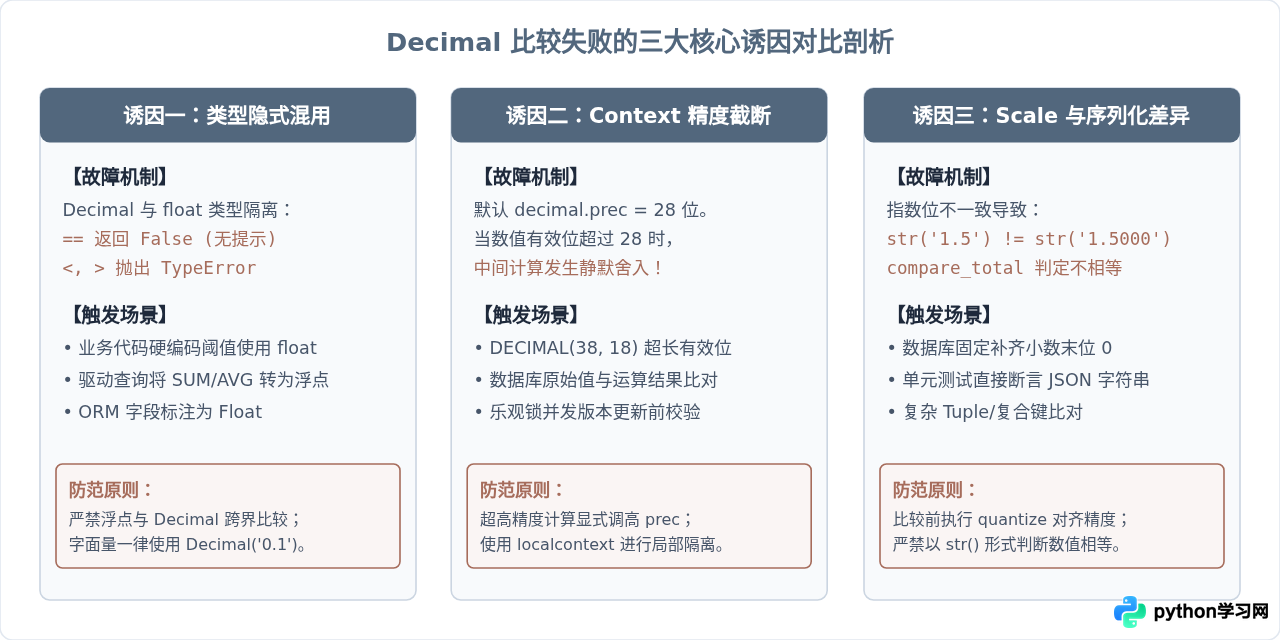
1. 类型断层:Decimal 与 float 的不对称比较模型
在 Python 的类型系统设计中,decimal.Decimal 属于精确数值类型,而 float 是基于 IEEE 754 标准的双精度二进制浮点类型。为了避免由于二进制浮点表示误差而破坏精确计算,Python 明确禁止了 Decimal 与 float 之间的隐式算术运算和相对大小比较。
特别需要关注的是等于比较(==)的行为:Python 规定,不同类型的对象在没有显式类型兼容实现时,默认返回 False。因此,即使数值在数学逻辑上完全等同,两者的比较也会直接落败:
from decimal import Decimal

val_dec = Decimal('0.1')
val_flt = 0.1

print(val_dec == val_flt)  # 输出:False!不会报错,但判断永远不成立
# print(val_dec < val_flt) # 直接抛出 TypeError
2. 驱动层转换异化:SQL 查询语句与 ORM 映射的隐式降级
不同的数据库引擎和 Python 驱动在处理高精度数值时有着不同的策略:
- MySQL 与 PyMySQL / mysqlclient: 当直接读取
DECIMAL字段时,驱动会将其反序列化为Decimal实例。然而,一旦 SQL 包含某些特定的聚合函数(例如在特定模式下的AVG()或数学运算表达式),MySQL 服务端会将结果协议字段标记为NEWDECIMAL或DOUBLE。如果驱动将其识别为浮点列,返回给 Python 的对象就会突变为float。 - SQLite: 原生并不包含专用的高精度 Decimal 存储类,通常存储为
TEXT或REAL。如果使用标准库sqlite3且未注册自定义的适配器(Adapter)与转换器(Converter),读取出的数据可能是未经包装的float,或者在插入时就已经被二进制浮点污染。 - SQLAlchemy 模型定义偏差: 如果数据库表字段是
DECIMAL(20, 8),但模型类中错误定义为Column(Float),SQLAlchemy 会在会话拉取数据时主动将其转换为float。
3. Python 全局 Decimal 上下文精度(Context Precision)截断
许多开发者误以为 Python 的 Decimal 是“无限精度”的。实际上,Decimal 的计算严格受制于上下文(Context)。Python 默认的全局精度是 28 位有效数字:
import decimal
print(decimal.getcontext().prec)  # 默认输出:28
当数据库中存储了超过 28 位有效数字的超高精度字段(例如 DECIMAL(38, 18) 填满时,或者科学计量中的 30 位有效值),如果从数据库读取出的原始 Decimal 在 Python 中参与了任何运算(哪怕是加上一个 Decimal(0)):
from decimal import Decimal, getcontext

# 假设数据库存储了一个 32 位有效数字的数值
raw_db_val = Decimal('12345678901234567890.123456789012')  # 32 位有效数字

# 进行看似不改变数值的运算
calculated_val = raw_db_val + Decimal('0')

# 此时全局 prec 为 28,发生隐式精度截断!
print(raw_db_val == calculated_val)  # 输出:False!
print(f"原始值:{raw_db_val}")
print(f"截断值:{calculated_val}")
截断后的数值末位被舍入,此时若将计算结果与重新从数据库读取的原始值做比对(例如在乐观锁控制或一致性校验中),比较便会必然失败。
4. 尺度(Scale / Exponent)与哈希映射陷阱
在数值数学意义上,Decimal('1.5') == Decimal('1.5000') 会返回 True,因为数值相等。但是在以下场景中,末尾补零会导致灾难性故障:
- 字典键(Dict Key)与集合(Set)查找:
Decimal('1.5')与Decimal('1.5000')的哈希值在 Python 中虽然相同,但如果与元组、复杂结构包装或转为 JSON 键比对,字符串化的'1.5'与'1.5000'将完全无法匹配。 - 完全比较方法(
compare_total): 许多高可靠库使用val1.compare_total(val2)进行严格校验,该方法不仅比较数值大小,还会校验指数位(Exponent)与符号位。此时Decimal('1.5').compare_total(Decimal('1.5000'))返回非零值(判定为不相同)。
三、系统排查与逐步解决四步法
遇到比较不符合预期时,切忌盲目使用 float() 强转。强制转换会立即抹杀数据库高精度字段的意义,使金融数据丢失最小分度值。应按照以下四个标准步骤系统排查与修复:
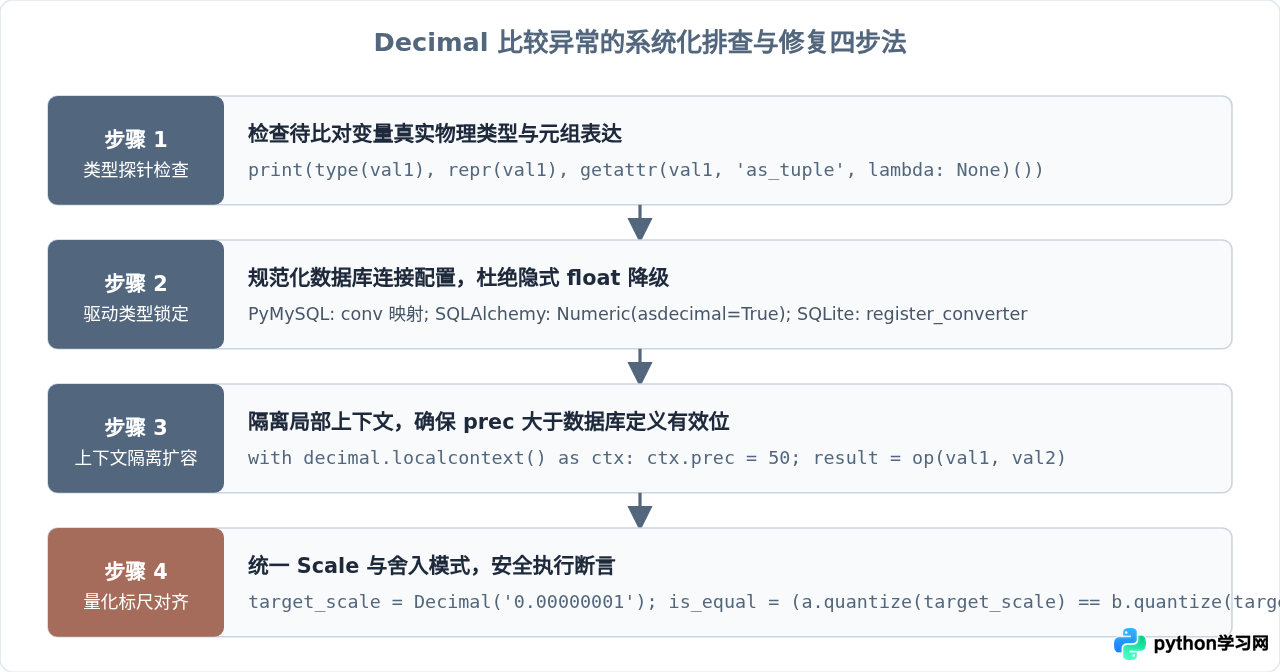
第 1 步:使用类型探针,打印真实内部形态
在比较语句之前,不要单纯使用 print(val),因为 str(val) 会抹平许多关键细节。必须使用 repr() 和 as_tuple() 审查两个变量的类型与指数结构:
def debug_decimal_probe(name: str, val):
    print(f"[{name}] 类型: {type(val)}")
    print(f"[{name}] repr: {repr(val)}")
    if hasattr(val, 'as_tuple'):
        print(f"[{name}] tuple: {val.as_tuple()}")

# 运行探针
debug_decimal_probe("DB数据", db_val)
debug_decimal_probe("目标数据", target_val)
如果发现其中一个的类型是 <class 'float'>,或者两者的 as_tuple().exponent 存在差异,即可立即定位根本原因。
第 2 步:纠正驱动与 ORM 配置
确保数据库驱动在反序列化时严格返回 decimal.Decimal:
- SQLAlchemy: 明确声明
Numeric(precision=36, scale=18, asdecimal=True)。asdecimal=True是 SQLAlchemy 的默认行为,但在动态反射或混用原生 SQL 时务必显式指定。 - PyMySQL: 确保未自定义将
FIELD_TYPE.NEWDECIMAL转换为float的转换表。如果使用字典游标或特定包装库,检查连接参数中的conv映射。 - SQLite: 如果使用标准库,需要注册数据类型转换器:
import sqlite3
from decimal import Decimal

# 注册 Decimal 适配器与转换器
sqlite3.register_adapter(Decimal, lambda d: str(d))
sqlite3.register_converter("DECIMAL", lambda s: Decimal(s.decode('utf-8')))

# 连接时开启类型侦测
conn = sqlite3.connect(":memory:", detect_types=sqlite3.PARSE_DECLTYPES)
第 3 步:扩充与隔离局部 Context 精度
针对超高精度计算,不要直接修改全局上下文,以避免影响当前进程中的其他通用模块。使用 decimal.localcontext() 创建安全隔离的执行环境:
import decimal
from decimal import Decimal, localcontext

# 假设需要处理有效数字多达 40 位的金融衍生品或代币数据
with localcontext() as ctx:
    # 将局部精度提升到 60 位有效数字,完全覆盖数据库定义
    ctx.prec = 60
    # 设置符合金融行业惯例的舍入模式(如四舍六入五成双 ROUND_HALF_EVEN)
    ctx.rounding = decimal.ROUND_HALF_EVEN

    # 在受控上下文中进行运算与校验
    total_amount = db_amount_1 + db_amount_2
    assert total_amount == expected_amount
第 4 步:使用 quantize() 建立统一的比较基准
当需要比对两个 Decimal,但两者可能由于数据库字段定义的 scale(小数位数)不同而无法直接严格匹配时,应当使用 quantize() 规范化精度:
from decimal import Decimal, ROUND_HALF_UP

# 定义统一的比较标尺(例如保留 8 位小数)
SCALE_8 = Decimal('0.00000001')

def safe_decimal_equal(d1: Decimal, d2: Decimal, precision_marker: Decimal = SCALE_8) -> bool:
    """确保在相同的 scale 与舍入规则下进行相等性判定"""
    if not isinstance(d1, Decimal) or not isinstance(d2, Decimal):
        raise TypeError(f"比较对象必须全部为 Decimal, 实际收到: {type(d1)} 与 {type(d2)}")

    norm_d1 = d1.quantize(precision_marker, rounding=ROUND_HALF_UP)
    norm_d2 = d2.quantize(precision_marker, rounding=ROUND_HALF_UP)
    return norm_d1 == norm_d2
abs(d1 - d2) < 1e-6 这种浮点工程近似法来比较 Decimal!因为 1e-6 本身是一个 float,该运算会立即触发 TypeError。如果确实需要允许微小容差,容差值本身也必须声明为 Decimal('0.000001')。
四、生产级完整代码示例与验证
以下示例展示了一个完整的场景:从数据库读取高精度数据、拦截潜在的类型隐患、配置独立上下文,并完成鲁棒的高精度比对。
import decimal
from decimal import Decimal, localcontext, ROUND_HALF_EVEN

class PrecisionMismatchError(Exception):
    """数值或类型校验失败异常"""
    pass

def verify_account_settlement(db_record: dict, expected_total: Decimal) -> bool:
    """
    对账校验函数
    :param db_record: 模拟从数据库驱动返回的字典行
    :param expected_total: 业务预期的 Decimal 汇总值
    """
    raw_amount = db_record.get("settlement_amount")

    # 步骤 1:防御式类型校验,拦截驱动隐式降级
    if isinstance(raw_amount, float):
        raise PrecisionMismatchError(
            f"数据类型污染警告:数据库字段以 float 形式返回 ({raw_amount}),"
            f"请检查 ORM 模型定义或 SQL 聚合函数包装!"
        )

    if not isinstance(raw_amount, Decimal):
        # 允许从安全的 str 转换为 Decimal
        try:
            clean_amount = Decimal(str(raw_amount))
        except (decimal.InvalidOperation, TypeError):
            raise PrecisionMismatchError(f"无法将字段值 {raw_amount} 安全解析为 Decimal")
    else:
        clean_amount = raw_amount

    # 步骤 2:在隔离的高精度上下文内执行比对
    # 设定精度为 50 位,远超常见数据库 DECIMAL(38, 18) 限制
    with localcontext() as ctx:
        ctx.prec = 50
        ctx.rounding = ROUND_HALF_EVEN

        # 步骤 3:定义量化标尺,对齐小数位(以 8 位小数为例)
        scale_marker = Decimal('0.00000001')
        normalized_db = clean_amount.quantize(scale_marker)
        normalized_exp = expected_total.quantize(scale_marker)

        # 步骤 4:严格断言
        is_matched = (normalized_db == normalized_exp)
        if not is_matched:
            print(f"[对账失败] 数据库量化值: {normalized_db.to_eng_string()} != 预期值: {normalized_exp.to_eng_string()}")
            return False

    return True

# --- 单元验证测试 ---
if __name__ == "__main__":
    # 模拟场景 A:正常高精度 Decimal 匹配
    record_ok = {"settlement_amount": Decimal("1000000.123456780000")}
    target_ok = Decimal("1000000.12345678")
    assert verify_account_settlement(record_ok, target_ok) is True
    print("场景 A 验证通过:尺度不同的相同数值经规范化后成功匹配。")

    # 模拟场景 B:驱动降级为 float 的拦截
    record_corrupted = {"settlement_amount": 1000000.12345678}
    try:
        verify_account_settlement(record_corrupted, target_ok)
    except PrecisionMismatchError as e:
        print(f"场景 B 验证通过:成功拦截不安全的 float 隐式比对 -> {e}")
五、常见避坑与工程规范总结
要在团队中彻底消除高精度 Decimal 比较失败的隐患,建议将以下规则作为工程编码规范落实到代码审查(Code Review)中。
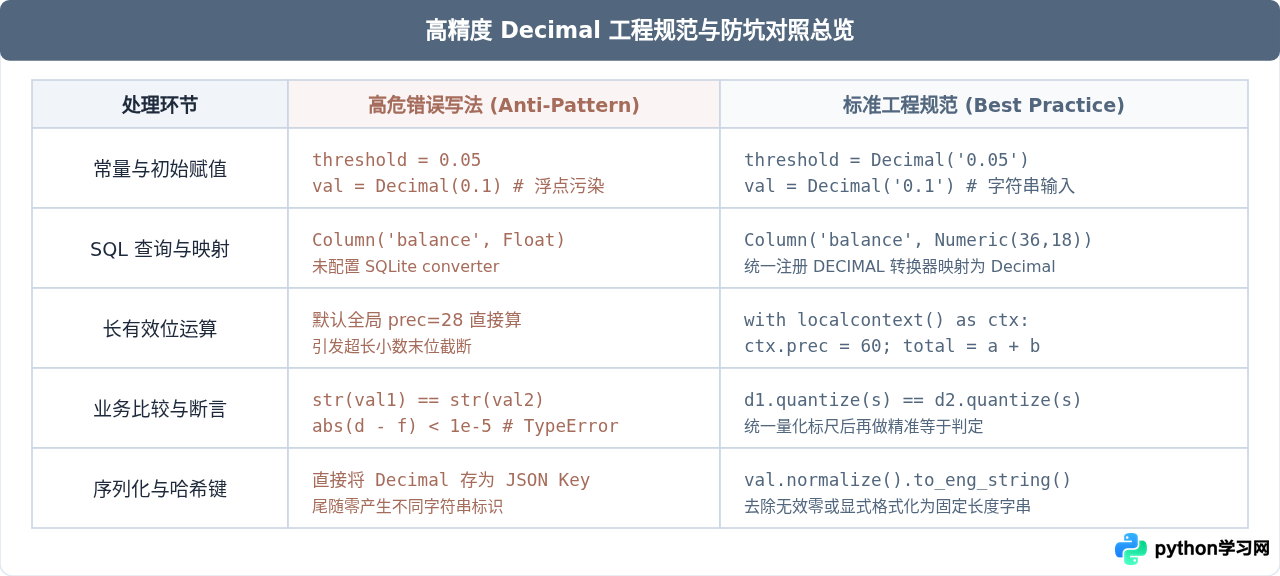
通过遵循上述规范,能够彻底消除由底层类型衰减、上下文截断和尺度分歧引发的难以复现的诡异 bug,为高可靠后端系统筑牢数据一致性的技术基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















