


Python基础语法速查:变量、循环与函数入门详解
本篇Python基础语法速查指南聚焦变量命名与内存引用、for/while循环控制流以及函数定义与参数解包三大核心支柱,提供详实的代码示例、原理图解与避坑速查表。
运行环境要求:Python 3.8+ 标准解释器环境
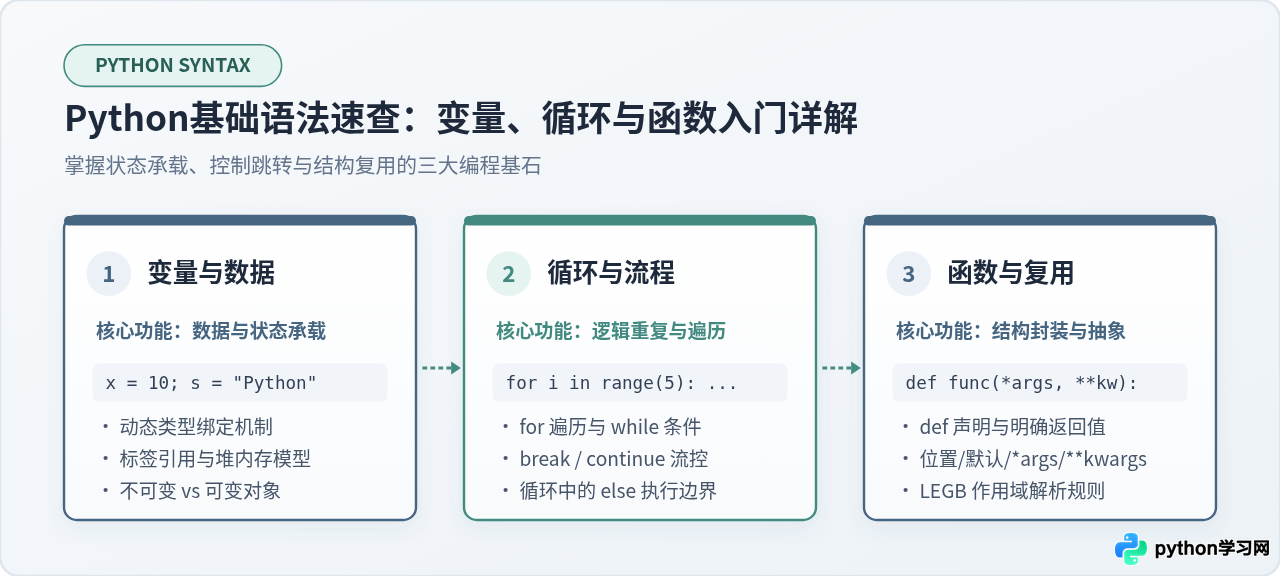
一、变量与核心数据类型速查
在 Python 中,定义变量无需事先声明类型,变量的创建发生在第一次给它赋值的时刻。标识符由英文字母、数字和下划线组成,不能以数字开头,且严格区分大小写。
# 基础赋值操作
user_id = 1001              # int 整型
pi_value = 3.14159           # float 浮点型
app_name = "DataCollector"   # str 字符串
is_active = True             # bool 布尔值

# 批量赋值与解构交换
count, threshold = 0, 50     # 多变量同时赋值
count, threshold = threshold, count  # 快速交换变量值(无需中间变量)
1.1 核心数据结构特性速查
Python 内置了四种最高频使用的组合数据结构,其性质与使用边界如下:
| 数据结构 | 声明语法 | 是否可变 | 是否有序 | 典型适用场景 |
|---|---|---|---|---|
| 列表 (list) | [1, 2, "a"] |
可变 | 有序 | 顺序数据流、需要动态增删的排序列 |
| 元组 (tuple) | (1, 2, "a") |
不可变 | 有序 | 只读常量集、函数多返回值、字典安全键 |
| 字典 (dict) | {"key": "val"} |
可变 | 有序 (3.7+) | 键值对映射、结构化配置、快速哈希查找 |
| 集合 (set) | {1, 2, 3} |
可变 | 无序 | 成员关系去重、数学交集/并集运算 |
1.2 变量本质:“标签引用”而非“盒子容器”
许多初学者容易将变量误解为装数据的“盒子”,但在 Python 的底层实现中,变量仅仅是贴在内存对象上的名字标签。变量名保存在当前的命名空间中,它记录的是目标对象在堆内存中的内存地址引用。
区分不可变对象(int、float、str、tuple)与可变对象(list、dict、set)是理解变量赋值行为的关键:
- 对于不可变对象,当对其进行修改计算时(例如
a = a + 1),解释器会在内存中分配一个新的对象并让变量指向新对象,原有对象不受影响。 - 对于可变对象,多个变量指向同一个对象时(例如
list_b = list_a),通过其中任一变量修改对象内部内容(如append()),其他变量访问到的内容会同步改变。
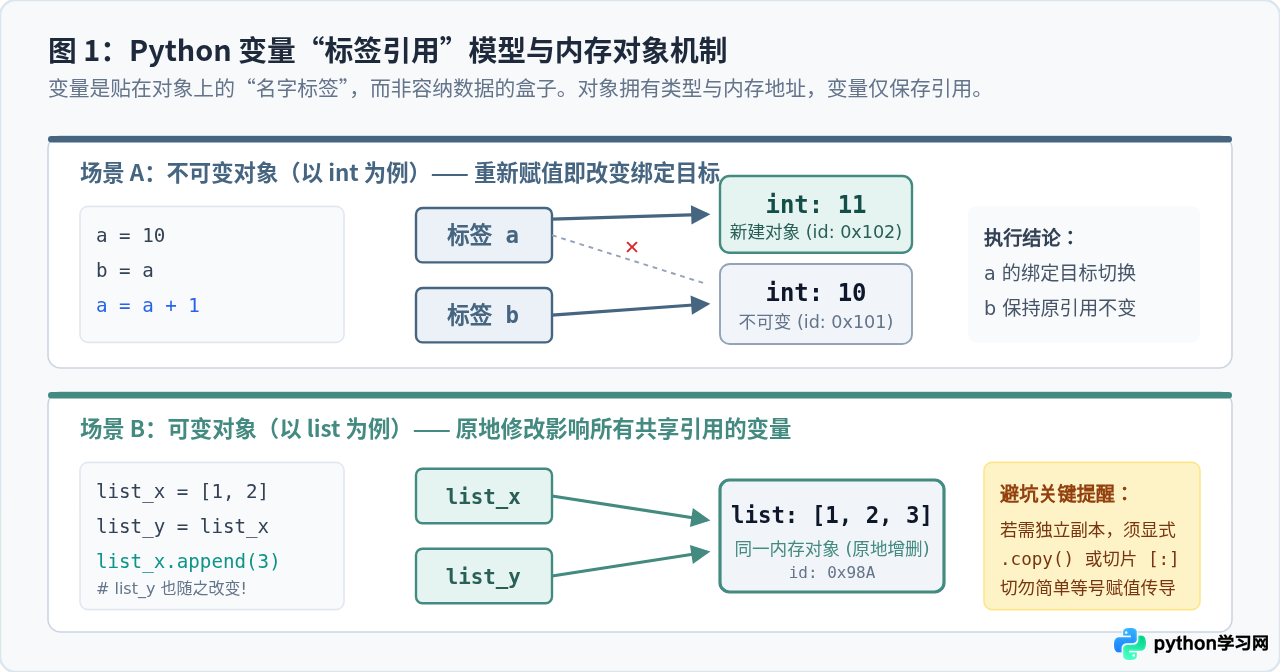
list_b = list_a。应当使用显式拷贝语法:list_b = list_a.copy() 或切片 list_b = list_a[:]。如果列表中嵌套了子列表,需使用 copy.deepcopy() 进行深拷贝。
二、循环结构与控制流详解
循环负责按条件反复执行指定代码块。Python 主要提供了 for ... in 迭代循环与 while 条件循环两种形式。
2.1 for 循环与迭代器生态
Python 的 for 循环本质上是一个迭代器驱动模型,它逐一从可迭代容器(列表、元组、字符串、字典、生成器等)中获取元素,直至容器耗尽。
fruits = ["苹果", "香蕉", "樱桃"]

# 1. 直接遍历元素
for fruit in fruits:
    print(f"当前水果: {fruit}")

# 2. range() 数值区间生成:range(起始值, 结束值(不含), 步长)
for i in range(1, 6, 2):
    print(f"步长计数: {i}")  # 输出 1, 3, 5

# 3. enumerate() 同时获取索引与元素(强烈推荐,避免 range(len(...)) 陋习)
for idx, fruit in enumerate(fruits, start=1):
    print(f"第 {idx} 项是 {fruit}")

# 4. zip() 组合并行遍历多个序列
prices = [8.5, 4.0, 25.0]
for name, price in zip(fruits, prices):
print(f"{name}: ¥{price}")当前水果: 香蕉
当前水果: 樱桃
步长计数: 1
步长计数: 3
步长计数: 5
第 1 项是 苹果
第 2 项是 香蕉
第 3 项是 樱桃
苹果: ¥8.5
香蕉: ¥4.0
樱桃: ¥25.0
2.2 while 条件循环与死循环规避
while 循环在指定的布尔表达式为 True 时持续运行。编写 while 循环必须确保循环体内存在能够改变判断条件的语句,否则将陷入死循环,耗尽 CPU 资源。
# 标准计数循环
retries = 3
while retries > 0:
    print(f"正在尝试连接服务器,剩余次数: {retries}")
    retries -= 1  # 状态递减更新,确保跳出循环
print("尝试结束")
2.3 流程打断与分支控制:break、continue 与 else
循环内部可通过关键字进行精细控制:
break:立即终止整个循环,跳出循环体执行后续代码。continue:立即跳过本次循环剩余语句,直接开始下一次循环判定。else子句:挂接在循环末尾。只有在循环自然迭代完毕(未被 break 中断)时才执行。该语法常用于元素搜索场景,无需额外设置布尔标记旗标。
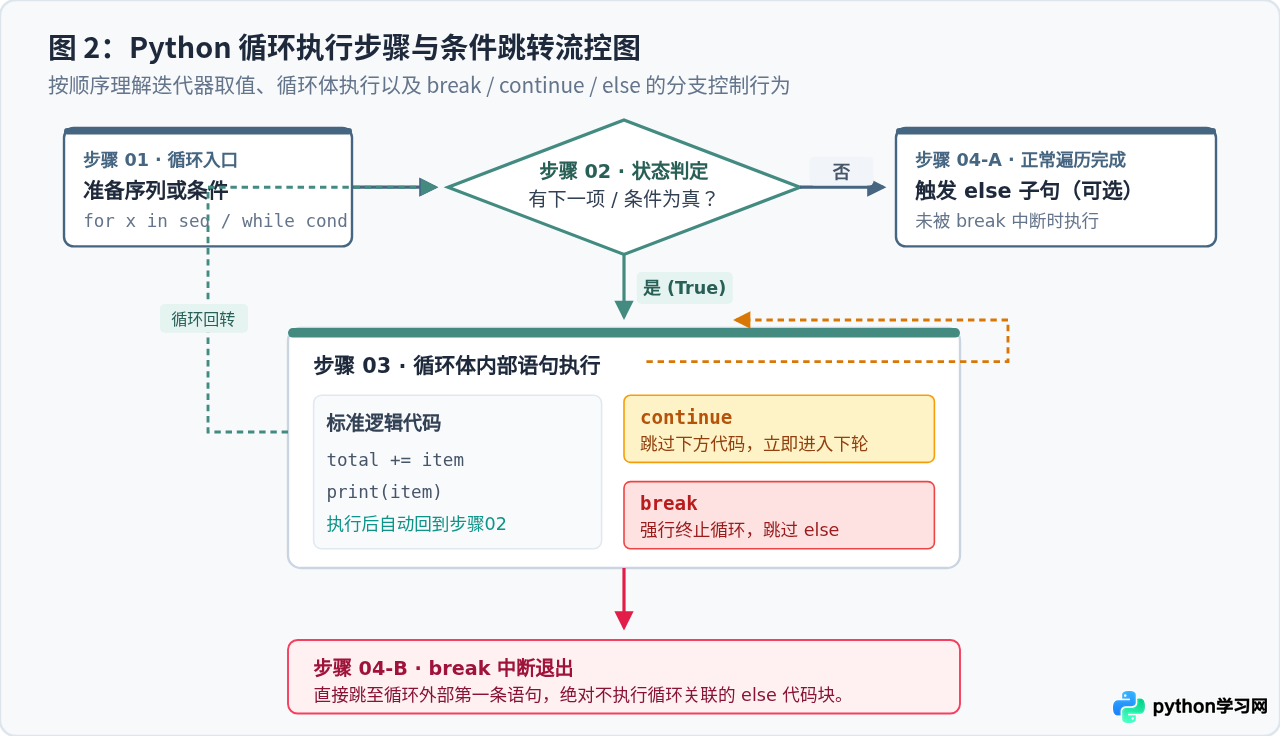
# 演示:for...else 查找素数/目标项
target = 7
numbers = [2, 4, 6, 8, 10]

for n in numbers:
    if n == target:
        print(f"找到目标数字: {target}")
        break
else:
    # 循环完整遍历未触发 break 时执行
print(f"遍历完成,列表中不存在 {target}")三、函数的定义、参数与作用域
函数是将独立功能的代码块组织在一起的命名单元。使用关键字 def 定义函数,通过括号 () 接收输入参数,使用 return 语句将处理结果传回调用方。
def calculate_rectangle_area(width: float, height: float) -> float:
    """计算矩形面积(包含类型提示与标准文档字符串)"""
    if width <= 0 or height <= 0:
        return 0.0  # 参数不合法时提前返回防御
    return width * height

result = calculate_rectangle_area(5.0, 3.0)
print(f"矩形面积为: {result}") # 示例输出:矩形面积为: 15.0return 语句,或者仅写了裸的 return,Python 会隐式返回内置单例 None。
3.1 四类函数参数模式解析
Python 提供了灵活的参数接收机制,在函数声明时必须严格遵守如下书写顺序:位置参数 > 默认值参数 > 可变位置参数 (*args) > 可变关键字参数 (**kwargs)。
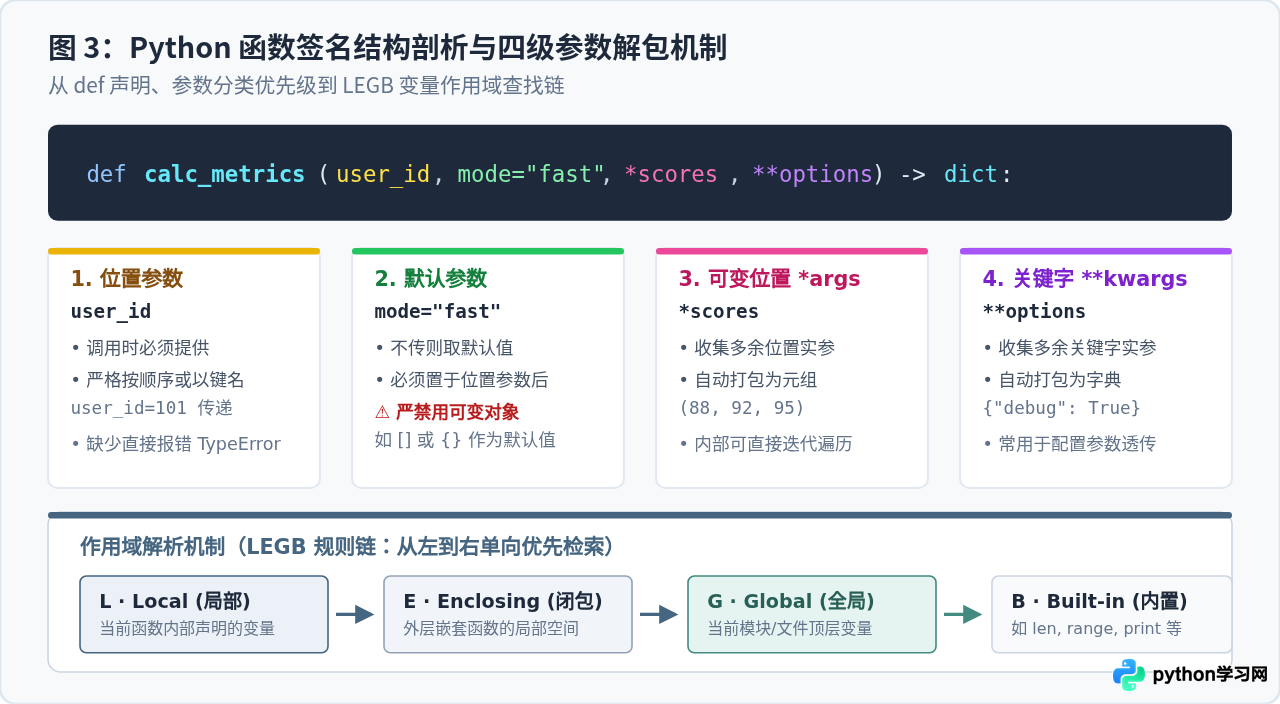
def register_student(name, age=18, *hobbies, **contact_info):
    print(f"学生姓名: {name}, 年龄: {age}")
    print(f"兴趣爱好 (tuple 打包): {hobbies}")
    print(f"联系方式 (dict 打包): {contact_info}")

# 综合传参调用
register_student(
    "李华", 20,
    "篮球", "阅读", "编程",
    email="lihua@example.com", phone="13800000000"
)兴趣爱好 (tuple 打包): ('篮球', '阅读', '编程')
联系方式 (dict 打包): {'email': 'lihua@example.com', 'phone': '13800000000'}
Python 函数的默认参数在模块加载定义时仅被求值初始化一次。如果使用
def append_item(val, container=[]),后续所有调用将共享同一个列表实例。正确做法是使用 None 作为占位哨兵:
def append_item(val, container=None):
    if container is None:
        container = []
    container.append(val)
    return container
3.2 变量作用域与 LEGB 解析规则
当在函数内部访问一个变量名时,Python 解释器按照固定优先级单向逐层向上检索变量:
- L (Local) 局部作用域:函数内部赋值定义的变量。
- E (Enclosing) 嵌套闭包作用域:外层包含函数的局部空间(常见于闭包或装饰器)。
- G (Global) 全局作用域:当前 Python 模块文件顶层定义的变量。
- B (Built-in) 内置作用域:Python 内置命名空间(如
len、range、ValueError)。
若要在函数内部重新给全局变量赋值,必须显式声明 global variable_name;若要在闭包内部修改外层局部变量,需声明 nonlocal variable_name。但在生产实践中,应尽量避免过度依赖全局变量,优先通过参数传递和函数返回值维持纯粹的数据流动。
四、综合应用实战与高频速查
下面通过一段完整的小型数据处理任务,演示如何协同组合变量定义、列表与字典迭代以及函数封装:
# 数据清洗与统计计算实战
def process_sales_records(raw_data, min_amount=0.0):
    """
    清洗并统计有效销售订单
    :param raw_data: 原始订单列表
    :param min_amount: 最小过滤金额阈值
    :return: 统计指标字典
    """
    valid_orders = []
    total_sales = 0.0

    for item in raw_data:
        # 数据解包与校验
        order_id = item.get("id")
        amount = item.get("amount", 0.0)

        # 过滤非正向异常金额或低于阈值的订单
        if amount < min_amount:
            continue

        valid_orders.append(order_id)
        total_sales += amount

    # 计算均值并返回结构化结果
    order_count = len(valid_orders)
    avg_sales = (total_sales / order_count) if order_count > 0 else 0.0

    return {
        "total_amount": round(total_sales, 2),
        "valid_count": order_count,
        "average_amount": round(avg_sales, 2),
        "order_ids": valid_orders
    }

# 模拟原始输入数据
orders_dataset = [
    {"id": "A101", "amount": 120.5},
    {"id": "A102", "amount": -15.0},  # 脏数据
    {"id": "A103", "amount": 340.0},
    {"id": "A104", "amount": 45.0}
]

stats = process_sales_records(orders_dataset, min_amount=50.0)
print("统计清洗结果:", stats)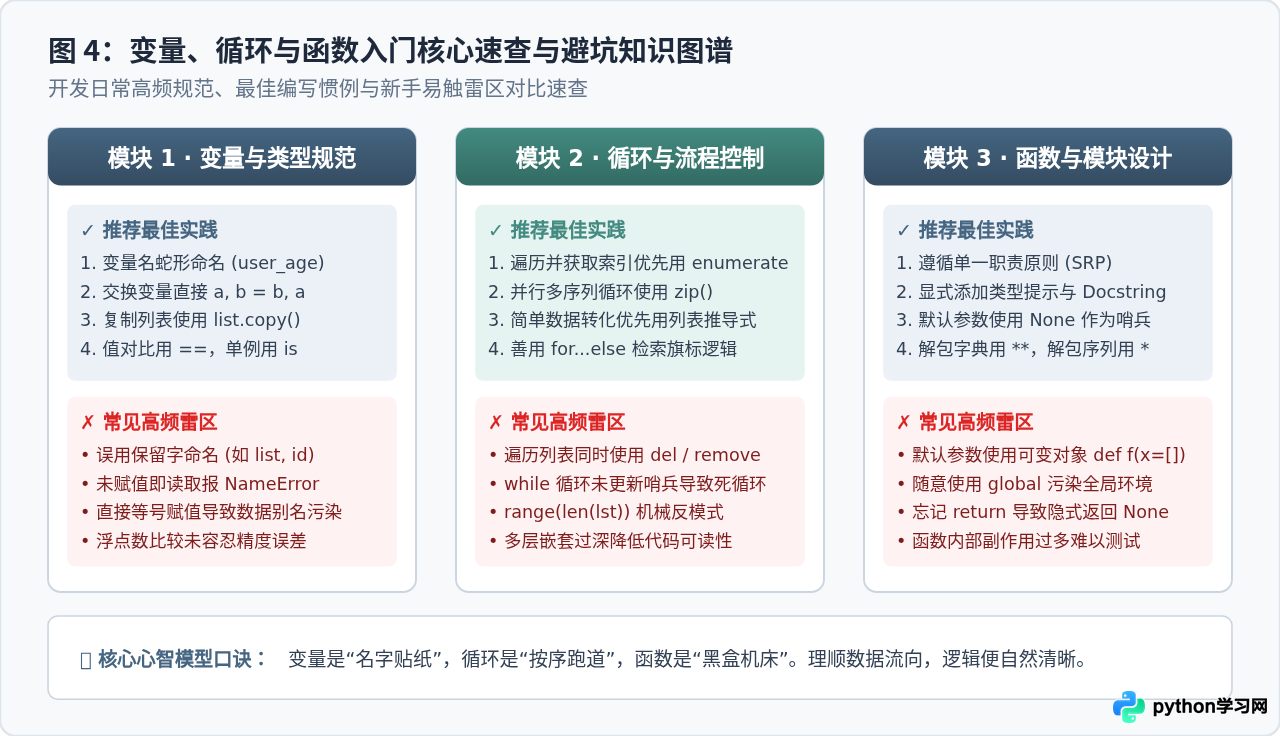
4.1 入门高频语法速查表
| 需求场景 | 标准推荐语法 | 注意事项与说明 |
|---|---|---|
| 解构与变量交换 | a, b = b, a |
右侧先打包为元组,再解包赋给左侧,原生线程安全且高效 |
| 安全读取字典键 | d.get("key", default_val) |
直接下标 d["key"] 遇到不存在键会报 KeyError |
| 循环同时取索引 | for i, v in enumerate(seq): |
消除维护外部计数器或使用 range(len(...)) 的繁琐 |
| 多列表合并遍历 | for a, b in zip(list1, list2): |
遍历长度以较短的列表为准;若需补全可用 itertools.zip_longest |
| 过滤列表推导式 | [x*2 for x in nums if x > 0] |
替代简短的 map/filter,更加 Pythonic,但不宜嵌套超过两层 |
| 收集不确定参数 | def f(*args, **kwargs): |
args 是元组,kwargs 是字典,常用于包装器与委托 |
| 实参解包传递 | func(*my_tuple, **my_dict) |
将已有序列和字典直接解开并映射为函数的形参传入 |
掌握变量的引用本质、循环的跳出分支以及函数的参数规范,便已具备编写稳健 Python 程序的基础底座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















