


AI翻译眼镜怎么实现实时同声传译?技术原理详解

在跨国会议或异国旅行的场景中,语言障碍往往是最直接的痛点。传统做法是掏出手机打开翻译App,但这意味着对话节奏被打断,眼神交流被迫中断,甚至因为轮流举着手机而显得尴尬。AI翻译眼镜的出现,试图将这种“打断式”的交流还原为自然的面对面沟通。它不再是一个需要主动操作的工具,而更像是一层隐形的语言滤镜。
然而,这种“无感”体验背后,并非简单的硬件堆砌,而是一场关于速度、精度与算力的精密博弈。很多人好奇,眼镜如何在对方话音未落时就显示出译文?这不仅仅是把翻译软件塞进镜腿里那么简单。真正的核心在于语音识别、机器翻译与AR显示三者之间毫秒级的协同工作,以及如何在有限的功耗和体积下解决噪音干扰与延迟问题。
声音的捕获与清洗:从嘈杂环境提取人声
一切始于声音的收集。与普通耳机不同,AI翻译眼镜需要在开放环境中工作,这意味着它必须面对风声、背景人声和交通噪音的干扰。如果前端采集的声音不纯净,后续的翻译就是“垃圾进,垃圾出”。
大多数主流AI翻译眼镜采用了阵列麦克风设计,通常分布在镜腿两侧或前端。这种布局利用了波束成形技术(Beamforming),通过多个麦克风接收声音的时间差,算法可以判断声源的方向,从而增强正前方说话人的声音,抑制侧面和后方的噪音。在这种场景下,即使站在喧闹的街头,眼镜也能相对清晰地锁定对话者的语音。
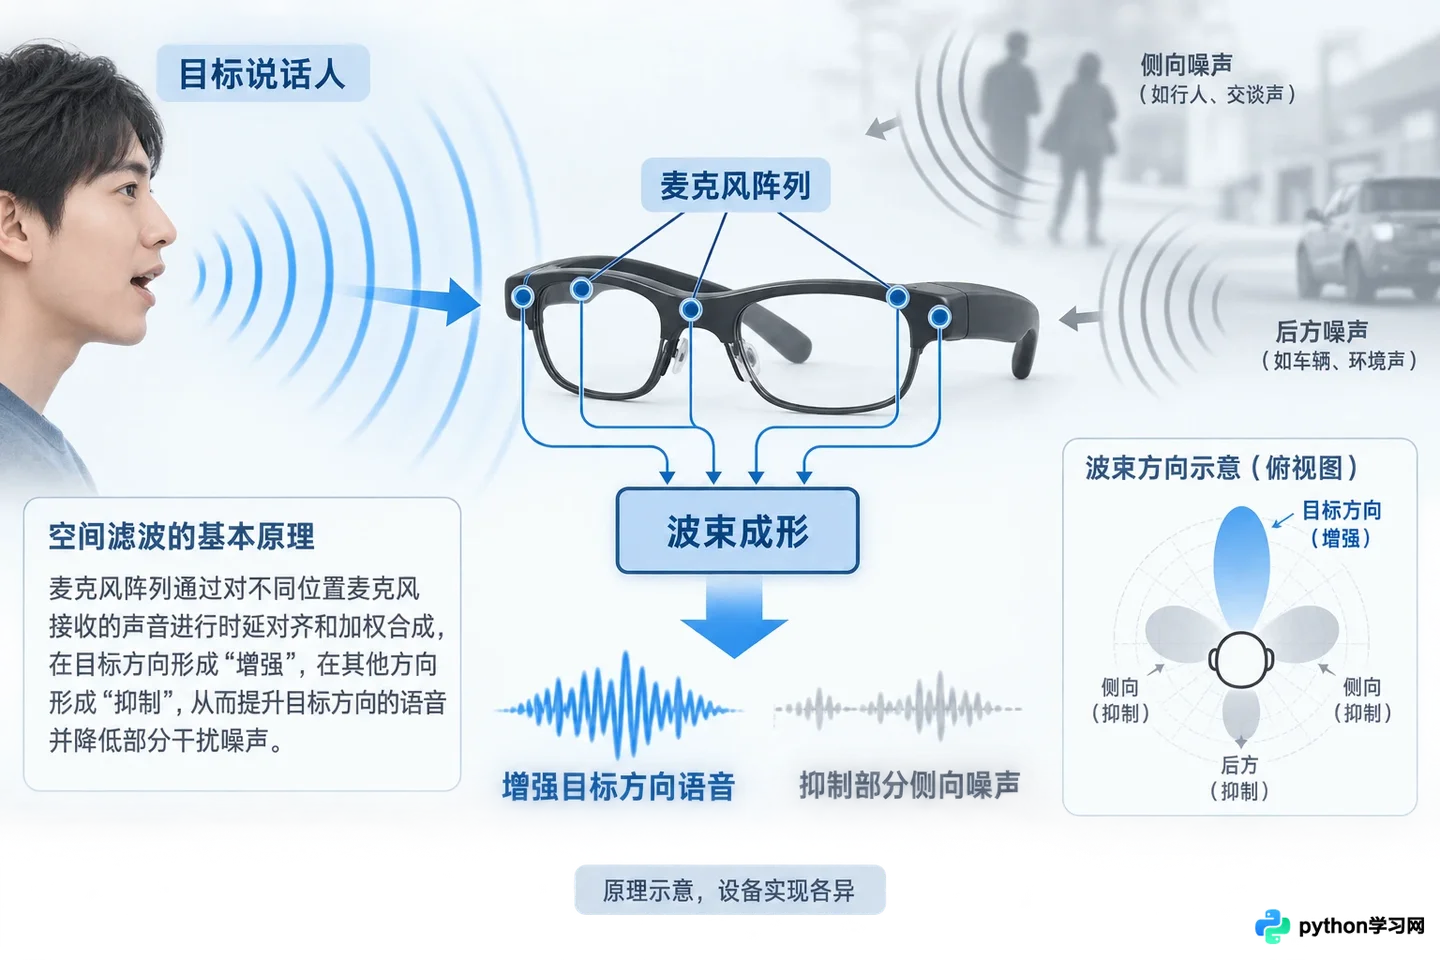
麦克风阵列通过波束成形技术锁定声源方向
但仅靠硬件还不够。采集到的音频信号会立即进入本地预处理阶段,进行降噪和回声消除。这一步至关重要,因为它决定了上传到云端的音频质量。值得注意的是,为了降低延迟,部分高频计算如语音活动检测(VAD)会在本地芯片完成,只有确认为有效语音片段的数据才会被打包发送。这种“端云协同”的策略,既节省了带宽,又避免了将无效静音上传造成的等待时间。
云端的大脑:ASR与NMT的流水线作业
当清晰的音频数据离开眼镜,旅程才真正开始。目前绝大多数AI翻译眼镜依赖云端算力,因为高精度的自动语音识别(ASR)和神经机器翻译(NMT)模型庞大,难以完全植入轻量化的眼镜终端。
这个过程是一条紧密衔接的流水线。首先,ASR引擎将音频流实时转写为文本。现代ASR系统不仅识别字词,还能结合上下文语境修正同音异义词。例如,区分“权利”与“权力”,往往依赖于前后句的逻辑关联。
紧接着,转写好的文本被送入NMT引擎。与传统基于短语的翻译不同,神经机器翻译基于深度学习模型,能够理解整句话的语义结构,从而生成更自然、符合目标语言习惯译文。对于中英互译这种成熟语种,这一过程通常在几百毫秒内完成;但对于小语种或复杂句式,耗时可能会增加。
这里存在一个技术权衡:是追求极致的低延迟,还是追求更高的翻译准确度? 目前的解决方案通常是“流式传输”。ASR不需要等整句话说完才开始工作,而是随着语音流的输入,逐词或逐短语地输出中间结果。翻译引擎也随之动态调整译文。这就是为什么你在眼镜上看到的字幕有时会先出现前半句,随后后半句补充完整,甚至偶尔会出现文字微调的现象。
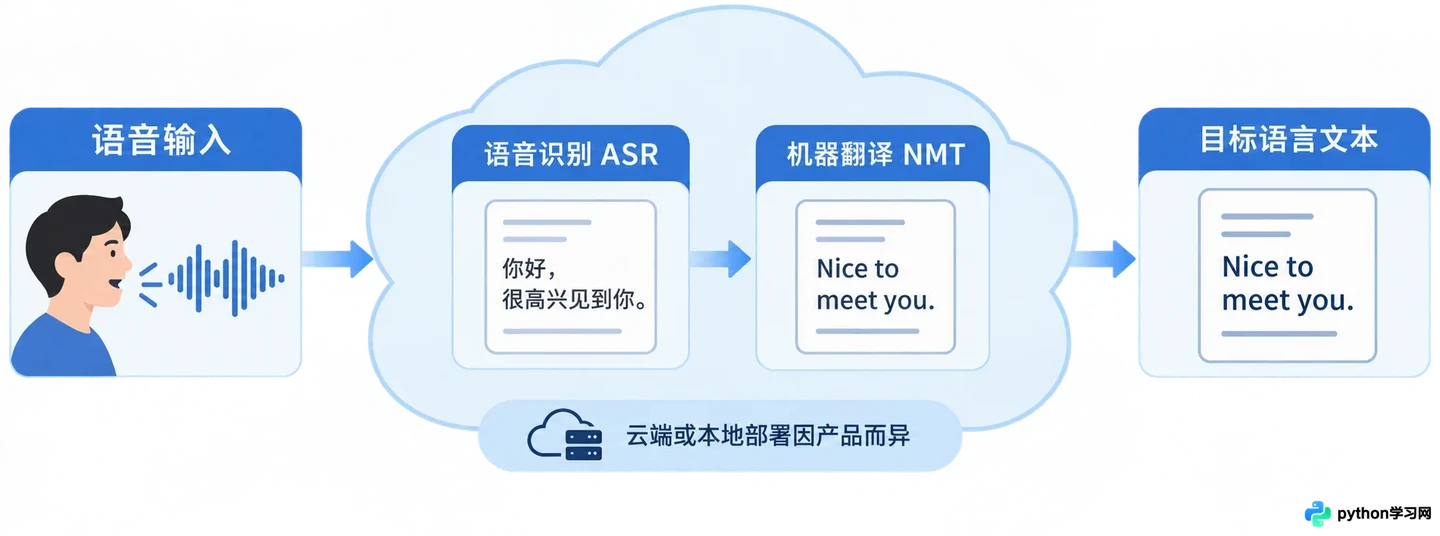
音频数据在云端经过ASR转写与NMT翻译的流水线处理
视觉的呈现:AR显示与交互设计的平衡
翻译好的文本最终需要回到用户的视野中。这就涉及到了增强现实(AR)显示技术。与VR头显不同,翻译眼镜要求显示模块极其轻薄,且不能遮挡正常视线。
目前主流的方案包括光波导(Optical Waveguide)和Birdbath光学方案。光波导技术通过纳米级光栅将微型投影仪发出的光线耦合进镜片,再传导至人眼。其优势在于镜片可以做得像普通近视镜片一样薄,透光率高,用户在看到字幕的同时,依然能清晰看到对方的面部表情和周围环境。这对于维持社交礼仪至关重要——你是在看着对方说话,而不是盯着屏幕。
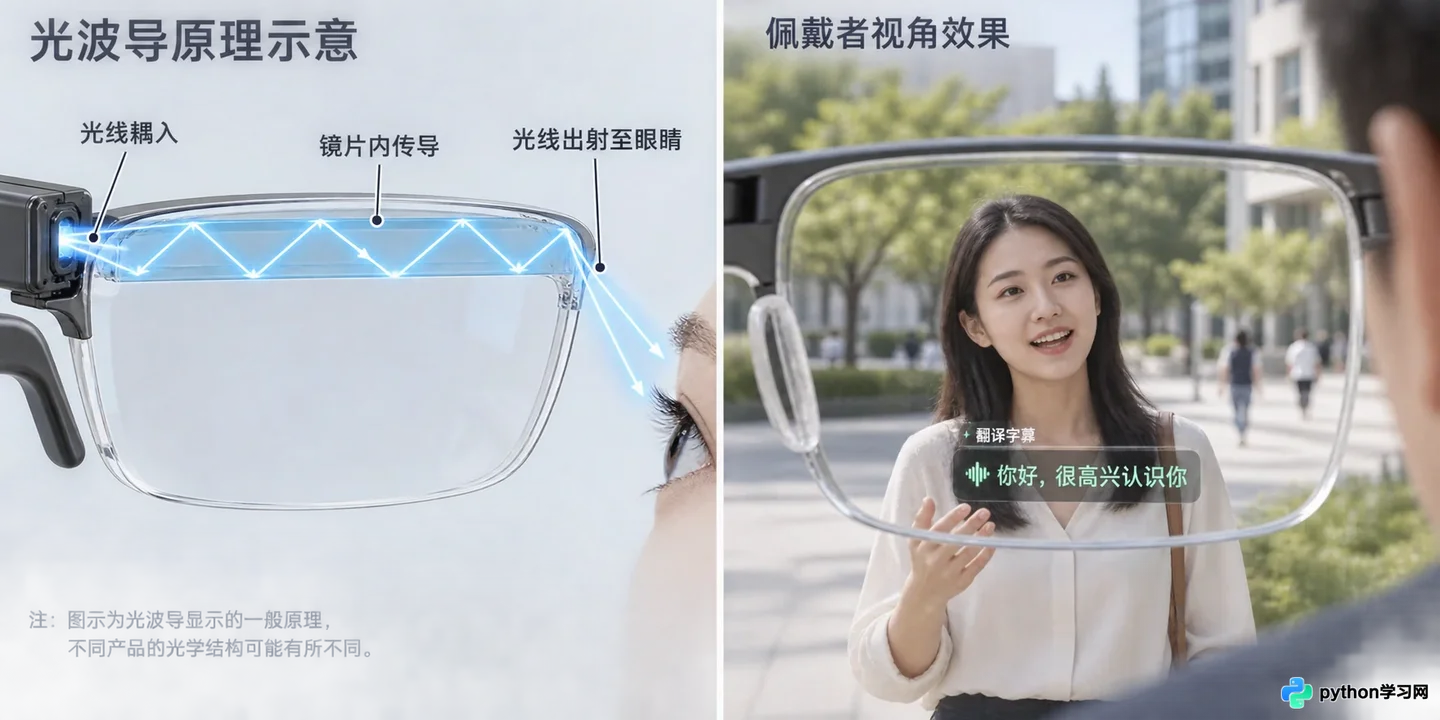
光波导技术将字幕投射至镜片,保持视线通透
在交互设计上,字幕的呈现位置和时机大有讲究。为了避免干扰视线,字幕通常出现在视野的下半部分或边缘。更重要的是,系统需要具备智能的刷新机制。如果对方语速过快,字幕滚动速度超过人眼阅读极限,体验就会崩塌。因此,优秀的算法会对译文进行摘要或分段处理,确保关键信息优先展示,而非机械地逐字堆砌。
此外,隐私保护也是显示环节的重要考量。部分高端型号采用了“定向显示”技术,只有佩戴者从特定角度才能看到字幕,旁人看来镜片只是微微反光。这解决了在公共场合翻译敏感内容时的尴尬。
技术的边界:延迟、离线与场景局限
尽管原理看似完美,但AI翻译眼镜在实际应用中仍有明显的边界。首先是延迟问题。虽然端到端延迟已压缩至1-2秒左右,但在快节奏的辩论或幽默对话中,这1秒的滞后仍可能导致笑点错过或插话失误。目前的技術尚无法做到真正的“同声”零延迟,更多是“近实时”的辅助。
其次是网络依赖。由于核心算力在云端,一旦处于弱网或无网环境,大部分眼镜的功能将大幅受限。虽然部分厂商开始尝试将轻量级模型部署在本地芯片以实现离线基础翻译,但其准确率和支持语种远不及云端版本。这使得它在飞机上或偏远地区的使用价值大打折扣。
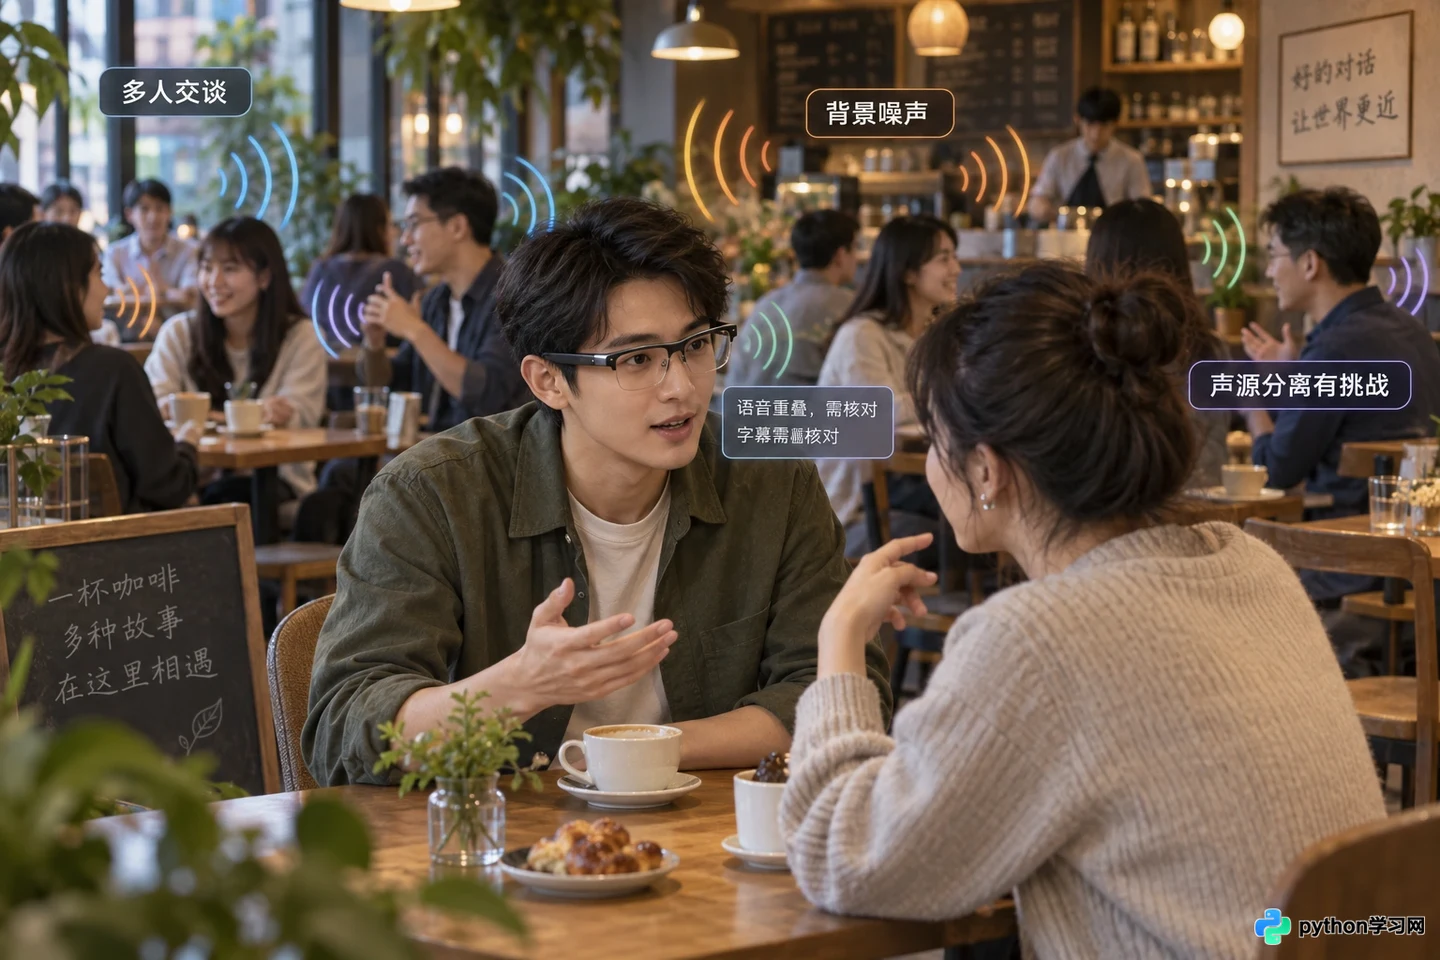
多人与噪音环境对声源分离提出挑战
最后是场景适应性。在多人同时说话的会议场景中,声源分离技术仍面临挑战。眼镜很难精准判断哪一句话是对你说的,哪一句是旁人的闲聊,可能导致字幕混乱。此外,对于带有强烈口音、俚语或文化隐喻的表达,机器翻译往往只能传达字面意思,丢失深层含义。
AI翻译眼镜并非万能的语言解药,它更像是为特定场景打造的效率工具。它最适合一对一的深度交流、旅游问路或商务洽谈,而在高噪音、多人群聊或高度依赖文化语境的场合,它仍需人类智慧的介入。理解这些技术原理与边界,能帮助我们更理性地看待这项技术:它不是要取代语言学习,而是为了在跨语言沟通中,保留那份珍贵的眼神交流与人性温度。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















