


Python实现简易语音命令识别:基于特征提取与DTW算法

本文介绍如何使用Python在百行代码内实现简易语音命令识别系统。核心流程包括将音频分段进行傅里叶变换提取特征向量,并采用动态时间归整(DTW)算法计算不同发音长度下的最小匹配代价。通过欧氏距离衡量特征差异,实现了对“芝麻开门”等命令词的鲁棒性识别,适用于本地化语音控制场景的入门学习。
前言与项目背景
前言
若希望深入理解核心特征计算的原理,建议先参考作者此前关于听歌识曲的文章,相关链接为:https://www.jb51.net/article/97305.htm
本文旨在构建一个简单的命令词识别程序,其算法核心包含两部分:一是音频特征的提取,二是利用DTW(动态时间归整)算法进行匹配。需注意的是,此类代码并不具备商业化应用的价值,但作为技术实践和娱乐探索仍具有不错的学习意义。
设计思路与挑战分析
设计思路
即便是小型项目,明确思路也是开发的前提。音频识别本身存在较大难度,其中特征提取的复杂性在之前的听歌识曲文章中已有体现。而语音识别的难度更高,原因在于音乐信号相对固定,而人类语音具有多变性。例如,“芝麻开门”这一指令,不同用户可能发音各异,且录音时机不一:有人可能在录音开始瞬间立即发声,也有人可能拖延至录音结束前才说出。这种时间轴上的不确定性增加了识别难度。
算法核心:特征提取与DTW匹配
算法流程:
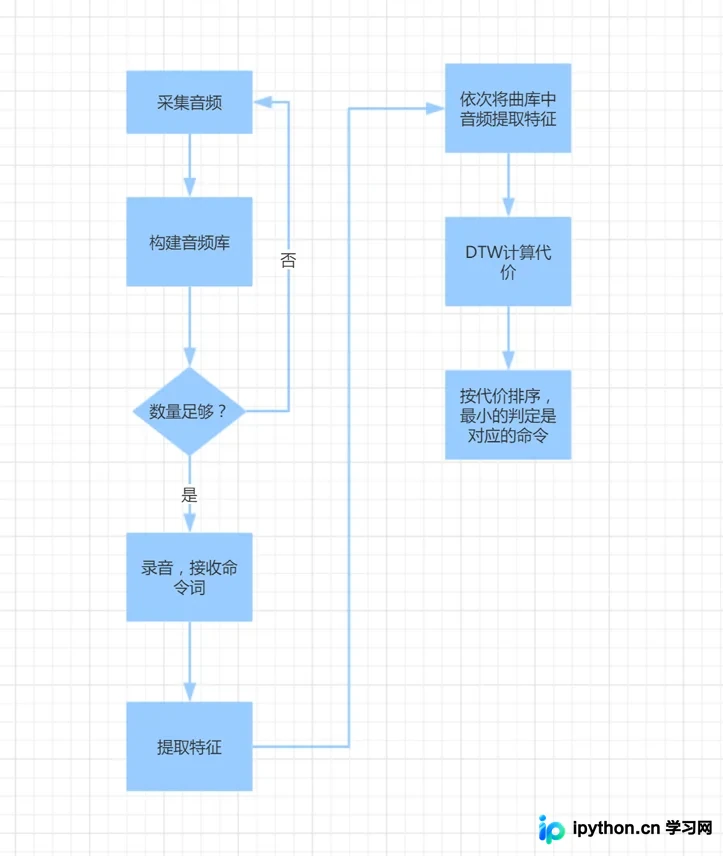
特征提取
与之前的听歌识曲项目类似,此处同样将一秒钟的音频划分为40个片段,对每个片段执行傅里叶变换并取模长。区别在于,此处不再进一步提取峰值,而是直接将模长值作为特征向量使用。
若对上述描述感到困惑,可参考下方的源代码或查阅听歌识曲相关文章以获取更直观的理解。
DTW算法
DTW,即Dynamic Time Warping(动态时间归整)。该算法旨在解决不同发音时长和位置偏移导致的匹配难题,通过寻找最优对齐路径来实现最合适的匹配。
算法接收两组音频的特征向量作为输入:A:[fp1,fp2,fp3,......,fpM1] 和 B:[fp1,fp2,fp3,fp4,.....fpM2]。其中,A组包含M1个特征,B组包含M2个特征。每个特征向量中的元素,即之前将每秒音频切分为40块后进行FFT(快速傅里叶变换)求得的模长向量。计算每对特征fp之间的代价时,采用欧氏距离作为度量标准。
设D(fpa,fpb)表示两个特征点之间的距离代价。
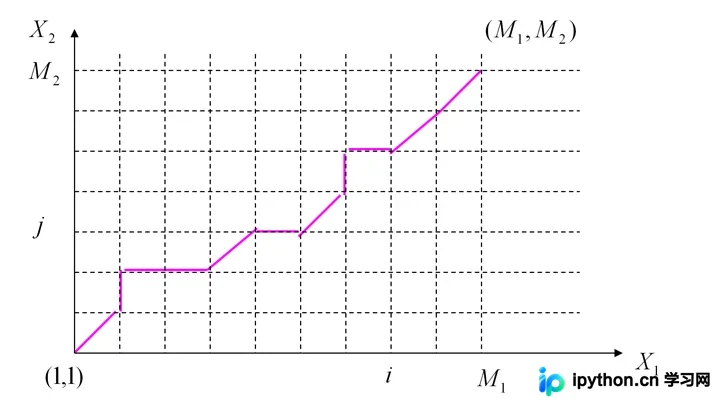
基于此定义,可以构建如下所示的匹配网格图。
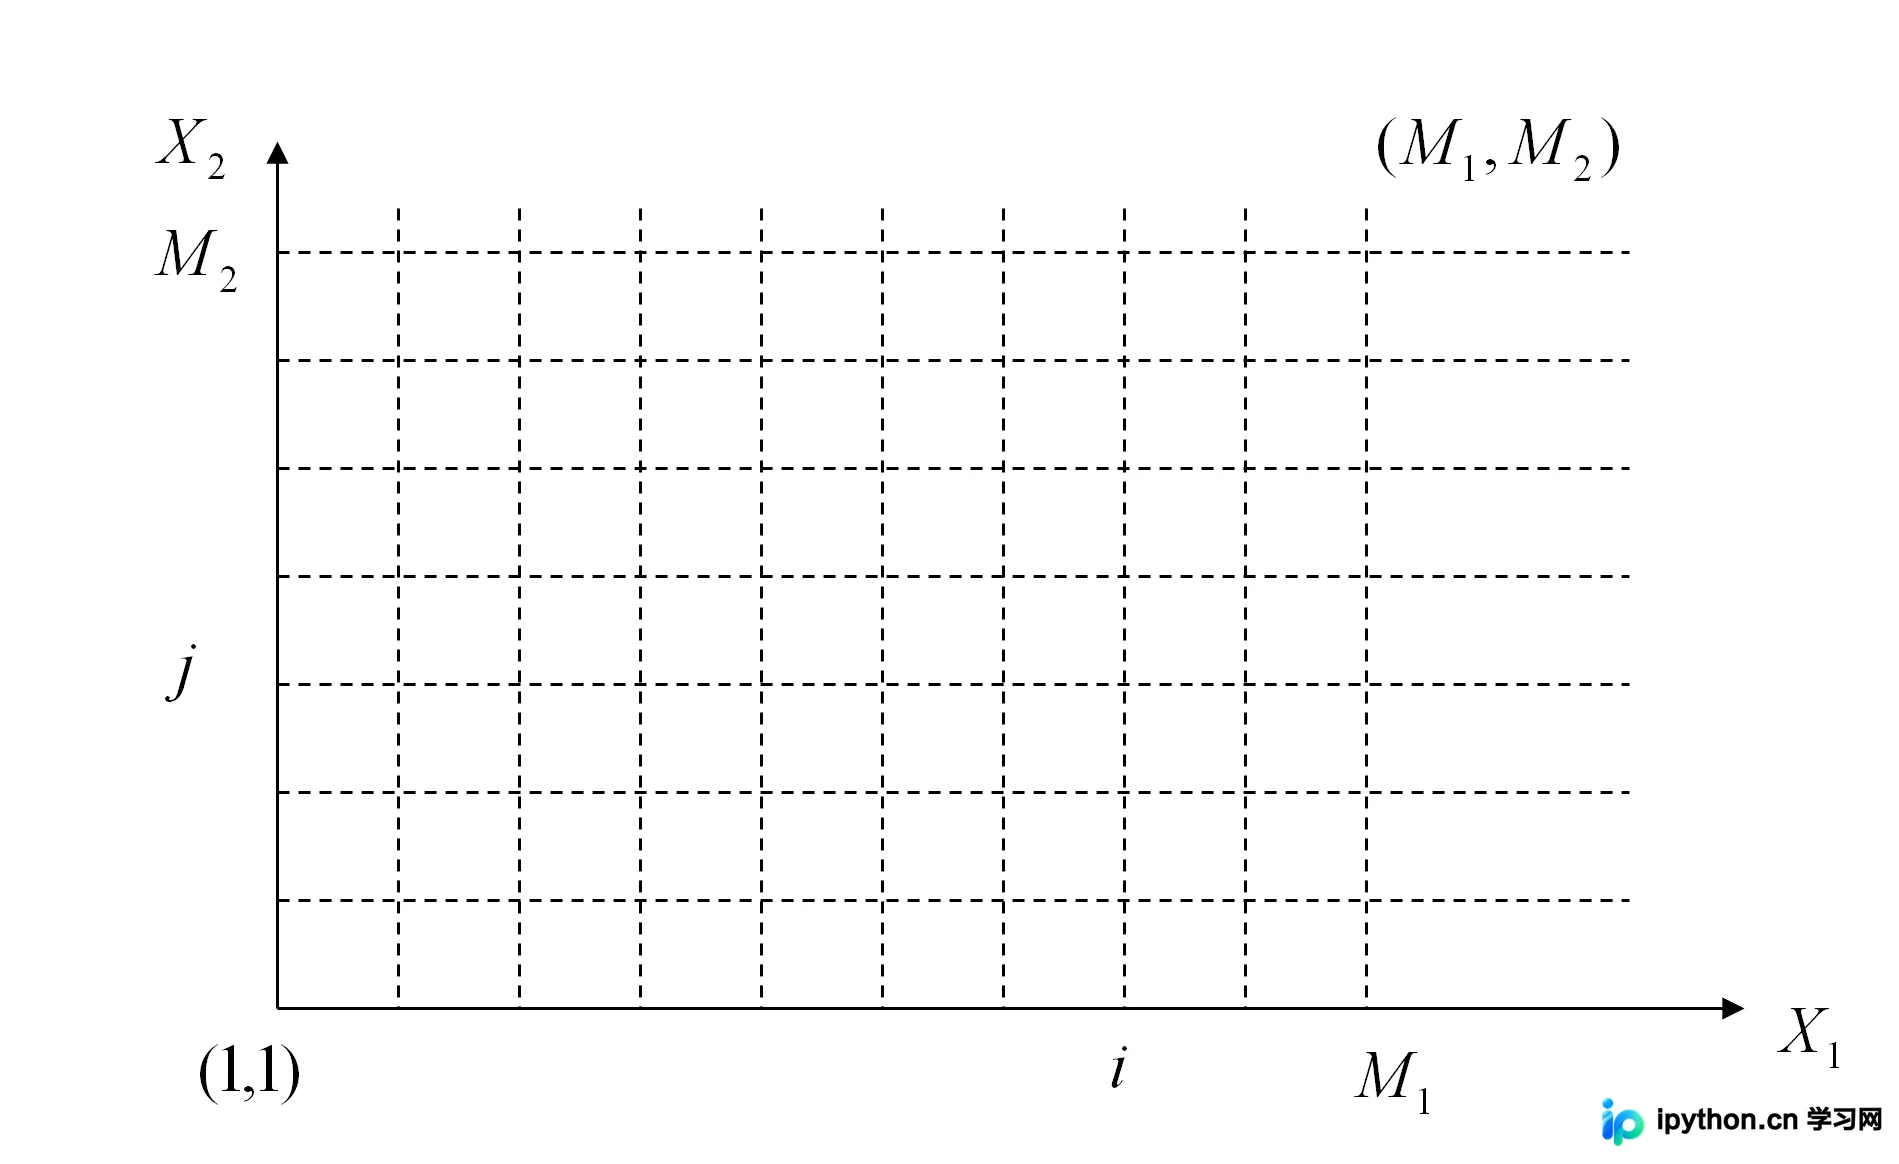
我们的目标是从坐标(1,1)移动到(M1,M2)。存在多种移动路径,每种路径代表一种音频位置匹配的方式。我们的目标是找到总代价最小的路径,从而确保这种对齐方式能提供最接近的匹配结果。
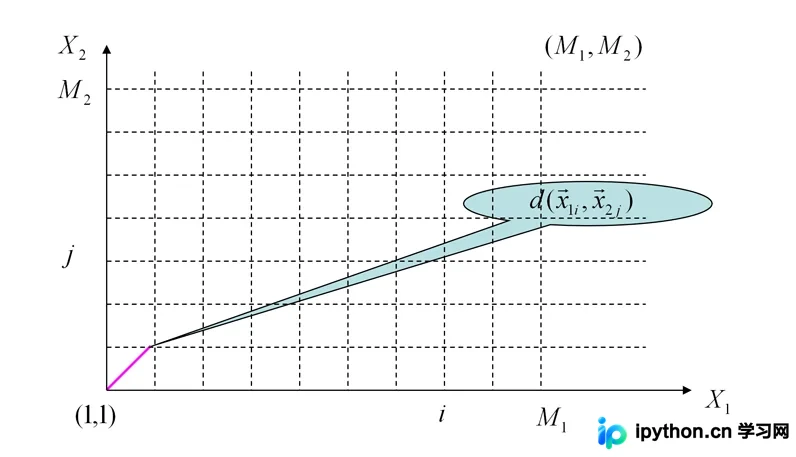
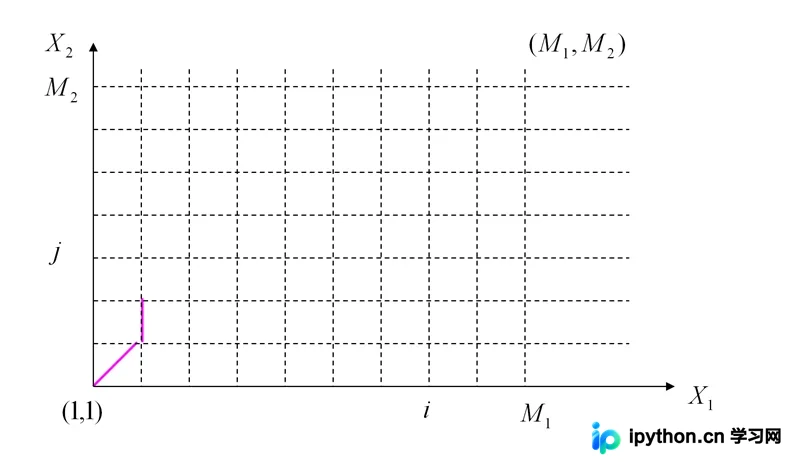
具体的移动策略如下:首先,坐标轴上的各个点可以直接计算累加代价。对于网格内部的点D(i,j),其代价由以下公式确定:D(i,j) = Min{D(i-1,j)+D(fpi,fpj), D(i,j-1)+D(fpi,fpj), D(i-1,j-1) + 2 * D(fpi,fpj)}。
为何从(i-1,j-1)直接移动到(i,j)需要加上两倍的代价?这是因为其他路径沿正方形的两条直角边行走,而该路径沿正方形对角线行走,几何距离更长,因此赋予双倍权重以平衡差异。
依据上述原理进行递归计算,直至得出D(M1,M2),该值即为两个音频序列之间的距离。
代码实现与应用建议
源代码和注释
# coding=utf8
import os
import wave
import dtw
import numpy as np
import pyaudio

def compute_distance_vec(vec1, vec2):
 return np.linalg.norm(vec1 - vec2) #计算两个特征之间的欧氏距离

class record():
 def record(self, CHUNK=44100, FORMAT=pyaudio.paInt16, CHANNELS=2, RATE=44100, RECORD_SECONDS=200,
    WAVE_OUTPUT_FILENAME="record.wav"):
  #录歌方法
  p = pyaudio.PyAudio()
  stream = p.open(format=FORMAT,
      channels=CHANNELS,
      rate=RATE,
      input=True,
      frames_per_buffer=CHUNK)
  frames = []
  for i in range(0, int(RATE / CHUNK * RECORD_SECONDS)):
   data = stream.read(CHUNK)
   frames.append(data)
  stream.stop_stream()
  stream.close()
  p.terminate()
  wf = wave.open(WAVE_OUTPUT_FILENAME, 'wb')
  wf.setnchannels(CHANNELS)
  wf.setsampwidth(p.get_sample_size(FORMAT))
  wf.setframerate(RATE)
  wf.writeframes(''.join(frames))
  wf.close()

class voice():
 def loaddata(self, filepath):
  try:
   f = wave.open(filepath, 'rb')
   params = f.getparams()
   self.nchannels, self.sampwidth, self.framerate, self.nframes = params[:4]
   str_data = f.readframes(self.nframes)
   self.wave_data = np.fromstring(str_data, dtype=np.short)
   self.wave_data.shape = -1, self.sampwidth
   self.wave_data = self.wave_data.T #存储歌曲原始数组
   f.close()
   self.name = os.path.basename(filepath) # 记录下文件名
   return True
  except:
   raise IOError, 'File Error'

 def fft(self, frames=40):
  self.fft_blocks = [] #将音频每秒分成40块,再对每块做傅里叶变换
  blocks_size = self.framerate / frames
  for i in xrange(0, len(self.wave_data[0]) - blocks_size, blocks_size):
   self.fft_blocks.append(np.abs(np.fft.fft(self.wave_data[0][i:i + blocks_size])))
 @staticmethod
 def play(filepath):
  chunk = 1024
  wf = wave.open(filepath, 'rb')
  p = pyaudio.PyAudio()
  # 播放音乐方法
  stream = p.open(format=p.get_format_from_width(wf.getsampwidth()),
      channels=wf.getnchannels(),
      rate=wf.getframerate(),
      output=True)
  while True:
   data = wf.readframes(chunk)
   if data == "": break
   stream.write(data)
  stream.close()
  p.terminate()
if __name__ == '__main__':
 r = record()
 r.record(RECORD_SECONDS=3, WAVE_OUTPUT_FILENAME='record.wav')
 v = voice()
 v.loaddata('record.wav')
 v.fft()
 file_list = os.listdir(os.getcwd())
 res = []
 for i in file_list:
  if i.split('.')[1] == 'wav' and i.split('.')[0] != 'record':
   temp = voice()
   temp.loaddata(i)
   temp.fft()
   res.append((dtw.dtw(v.fft_blocks, temp.fft_blocks, compute_distance_vec)[0],i))
 res.sort()
 print res
 if res[0][1].find('open_qq') != -1:
  os.system('C:\program\Tencent\QQ\Bin\QQScLauncher.exe') #我的QQ路径
 elif res[0][1].find('zhimakaimen') != -1:
  os.system('chrome.exe')#浏览器的路径,之前已经被添加到了Path中了
 elif res[0][1].find('play_music') != -1:
  voice.play('C:\data\music\\audio\\audio\\ (9).wav') #播放一段音乐
 # r = record()
 # r.record(RECORD_SECONDS=3,WAVE_OUTPUT_FILENAME='zhimakaimen_09.wav')
在实际应用前,建议先利用record方法录制几段命令词,尝试使用不同的语气和节奏进行录音,以提高识别准确度。随后设计好对应的文件名,系统将根据匹配到的最接近音频的文件名来判断具体命令,进而自定义执行相应的任务。
此处提供一段演示视频供参考:http://www.iqiyi.com/w_19ruisynsd.html
总结
以上为本文的全部内容,希望本文的内容对大家的学习或者使用python能带来一定的帮助,如果有疑问大家可以留言交流。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















