


Python处理百万级数据可视化的性能优化技巧

一、百万级数据可视化的性能瓶颈根源
当数据量达到百万甚至千万级别时,使用 Matplotlib 的 plt.scatter 或常规 Seaborn 绘图往往需要等待数十秒甚至直接导致进程崩溃。导致这一现象的原因主要有两个维度:底层对象开销与屏幕物理分辨率限制。
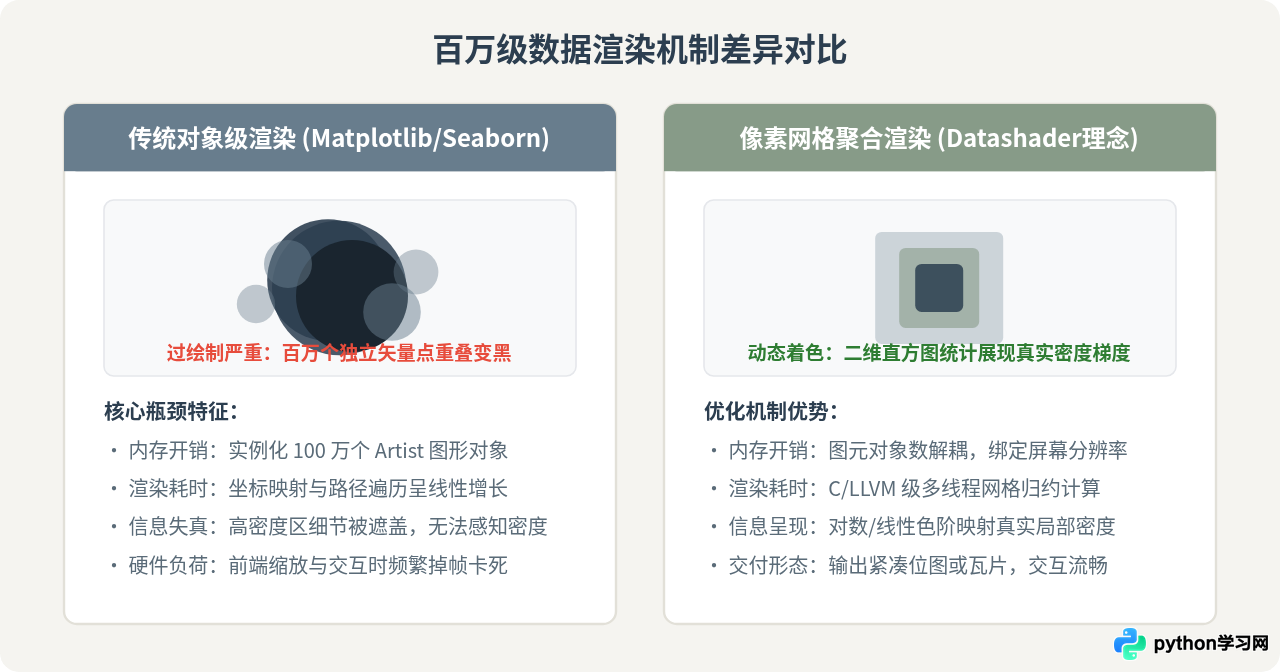
在传统矢量渲染体系中,每一个散点都会在内存中实例化为一个独立的图形对象(如 Matplotlib 的 Artist 对象或前端 DOM 节点)。一百万个散点意味着要分配上百万个对象的内存空间,并进行数百万次坐标投影计算与路径渲染。
与此同时,主流电脑显示器的物理像素通常只有 1920×1080(约 207 万像素)或 2560×1440(约 368 万像素)。在固定的图表区域内(通常只有 800×600 即 48 万像素),塞入 100 万个散点必然会导致多个数据点落在同一个像素网格中。这种现象被称为过绘制(Overplotting)。大量的点堆积成漆黑一片的色块,不仅浪费了海量硬件算力,还彻底抹杀了数据局部的真实密度与分布特征。
二、基础优化:数据前置处理与内存紧凑化
很多可视化任务在绘图开始前就已经耗尽了系统内存。Pandas 默认使用 float64 和 int64 存储数值,每个数值占用 8 字节;字符串列默认使用 object 类型,每个元素不仅包含指针开销,还缺乏连续内存布局。
通过数据类型下转换(Downcasting)以及将重复字符串转换为 category 类型,可以立刻将百万级数据集的内存占用缩减 60% 至 75%。这不仅减少了分页交换(Swap)导致的系统假死,还能让底层绘图库获得更高的 CPU 缓存命中率。
import numpy as np
import pandas as pd

def optimize_dataframe_memory(df: pd.DataFrame) -> pd.DataFrame:
    """
    通过数值类型降级与分类转换,显著缩减 DataFrame 内存占用
    """
    initial_memory = df.memory_usage(deep=True).sum() / (1024 ** 2)

    for col in df.columns:
        col_type = df[col].dtype

        # 处理浮点数:若精度允许,从 float64 转为 float32
        if col_type == 'float64':
            df[col] = df[col].astype(np.float32)

        # 处理整数:根据数值上下界转为 int32 或 int16
        elif col_type == 'int64':
            c_min, c_max = df[col].min(), df[col].max()
            if c_min > np.iinfo(np.int16).min and c_max < np.iinfo(np.int16).max:
                df[col] = df[col].astype(np.int16)
            elif c_min > np.iinfo(np.int32).min and c_max < np.iinfo(np.int32).max:
                df[col] = df[col].astype(np.int32)

        # 处理高基数或重复文本
        elif col_type == 'object':
            num_unique_values = len(df[col].unique())
            num_total_values = len(df[col])
            if num_unique_values / num_total_values < 0.5:
                df[col] = df[col].astype('category')

    optimized_memory = df.memory_usage(deep=True).sum() / (1024 ** 2)
    print(f"内存占用从 {initial_memory:.2f} MB 降低至 {optimized_memory:.2f} MB "
          f"(缩减 {(1 - optimized_memory / initial_memory) * 100:.1f}%)")
    return df

# 示例:创建包含 100 万行数据的样本
np.random.seed(42)
n_samples = 1_000_000
raw_df = pd.DataFrame({
    'x': np.random.normal(loc=0.0, scale=1.0, size=n_samples),
    'y': np.random.normal(loc=0.0, scale=1.0, size=n_samples),
    'category': np.random.choice(['Alpha', 'Beta', 'Gamma'], size=n_samples)
})

clean_df = optimize_dataframe_memory(raw_df)
在进行 float64 到 float32 的转换时,必须确认业务场景是否涉及微小差值比较(如经纬度厘米级定位)。对于一般的屏幕坐标映射(像素级精度要求),单精度浮点数足以提供至少 7 位有效十进制数字,完全满足像素定位要求。
三、核心方案:基于像素聚合的 Datashader 渲染流水线
当数据达到百万甚至千万行散点时,推荐的核心方案是 Datashader。Datashader 是 PyData 生态中的高性能渲染引擎,其核心思想是把可视化过程解构为一个纯粹的数据处理管道,分为四个严密阶段:投影(Projection)、聚合(Aggregation)、扩散(Spreading)和色彩映射(Colormapping)。
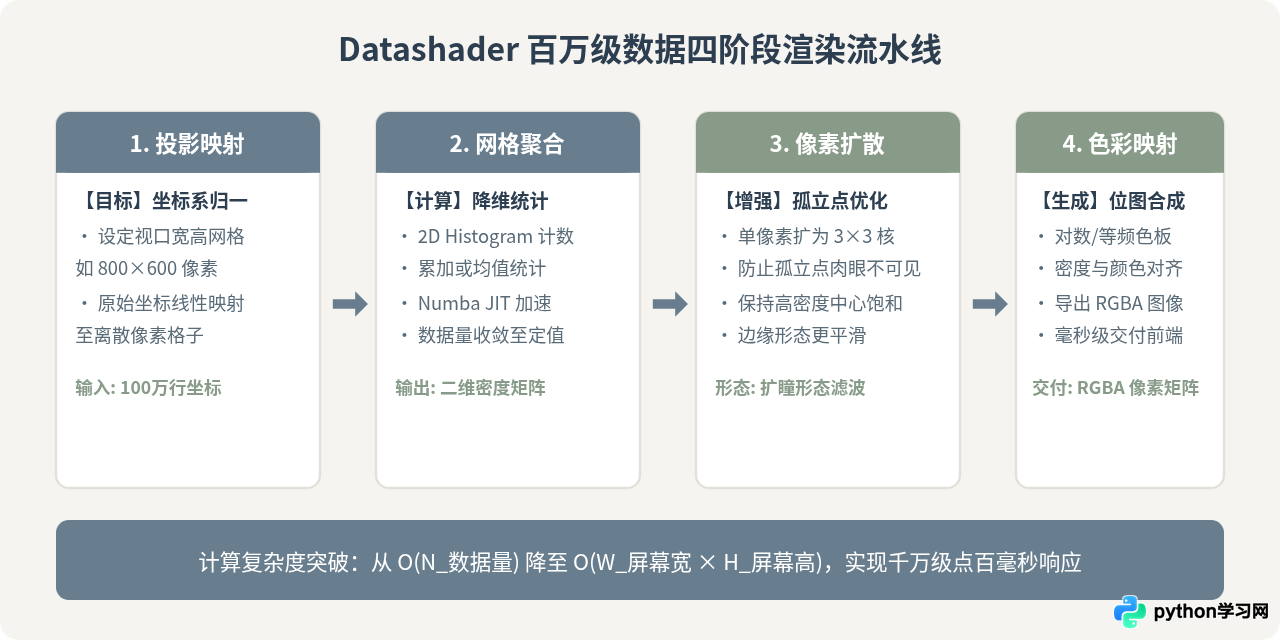
以下是使用 Datashader 在 1 秒内将 100 万个散点直接渲染为图像的完整执行示例代码:
import datashader as ds
import datashader.transfer_functions as tf
from colorcet import fire
import pandas as pd
import numpy as np

# 1. 构造 1,000,000 个双中心高斯分布散点
n_points = 1_000_000
cluster_a = np.random.normal(loc=[-1.5, -1.0], scale=[0.8, 0.6], size=(n_points // 2, 2))
cluster_b = np.random.normal(loc=[1.2, 1.2], scale=[0.5, 0.9], size=(n_points // 2, 2))
points = np.vstack([cluster_a, cluster_b])

df = pd.DataFrame(points, columns=['x', 'y'], dtype=np.float32)

# 2. 定义渲染视口画布大小 (根据终端显示设定分辨率)
canvas_width, canvas_height = 900, 600
cvs = ds.Canvas(plot_width=canvas_width, plot_height=canvas_height)

# 3. 执行投影与直方图聚合统计 (O(N) 极速计算)
agg = cvs.points(df, 'x', 'y')

# 4. 色彩映射与像素平滑:使用对数拉伸处理大动态范围密度
img = tf.shade(agg, cmap=fire, how='log')
# 对稀疏独立单点进行轻度像素扩散(扩瞳),确保单点清晰可见
img = tf.spread(img, px=1)

# 5. 保存结果或嵌入到交互容器中
img.to_pil().save("million_points_optimized.png")
print(f"成功将 {n_points} 个点聚合渲染为 {canvas_width}x{canvas_height} 图像")
四、时序与折线图场景:LTTB 降采样优化
对于散点图,基于二维网格的像素聚合(如 Datashader)是首选;但对于百万级时序信号或高频传感器曲线,折线图需要保留波峰、波谷及走势特征。如果直接把百万点塞给前端(如 ECharts、Plotly),浏览器会在绘制路径时发生严重掉帧甚至崩溃。
如果使用常规的简单步长下采样(如每隔 100 个点取 1 个点),很容易恰好漏掉短瞬间的异常尖峰,从而导致数据失真。
LTTB(Largest Triangle Three Buckets,最大三角形三桶算法)是专门解决这一问题的降采样技术。它将数据分为若干区间(桶),通过最大化三个相邻数据点所构成三角形的面积,动态挑选最具形态代表性的关键特征点。将 1,000,000 点压缩为 2,000 点后,图形轮廓和极值与全量渲染几乎完全一致,但前端渲染负担骤降 99.8%。
import numpy as np

def lttb_downsample(x: np.ndarray, y: np.ndarray, threshold: int) -> tuple[np.ndarray, np.ndarray]:
    """
    使用最大三角形三桶算法 (LTTB) 对一维时序数据进行高效降采样
    :param x: 时间戳或索引序列 (单调递增)
    :param y: 数值序列
    :param threshold: 目标保留点数 (通常取 1000 - 3000 点)
    """
    data_len = len(x)
    if threshold >= data_len or threshold <= 2:
        return x, y

    sampled_x = np.empty(threshold, dtype=x.dtype)
    sampled_y = np.empty(threshold, dtype=y.dtype)

    # 桶的大小 (首末点固定保留,其余划分为 threshold - 2 个桶)
    bucket_size = (data_len - 2) / (threshold - 2)

    # 第一个点始终保留
    a_idx = 0
    sampled_x[0] = x[a_idx]
    sampled_y[0] = y[a_idx]

    out_idx = 1
    for i in range(threshold - 2):
        # 当前桶与下一桶的边界
        curr_bucket_start = int(np.floor((i + 0) * bucket_size)) + 1
        curr_bucket_end = int(np.floor((i + 1) * bucket_size)) + 1
        curr_bucket_end = min(curr_bucket_end, data_len)

        next_bucket_start = int(np.floor((i + 1) * bucket_size)) + 1
        next_bucket_end = int(np.floor((i + 2) * bucket_size)) + 1
        next_bucket_end = min(next_bucket_end, data_len)

        # 计算下一个桶的中心平均坐标 (C 点)
        avg_x = np.mean(x[next_bucket_start:next_bucket_end])
        avg_y = np.mean(y[next_bucket_start:next_bucket_end])

        # 在当前桶中寻找使三角形面积最大的点 (B 点)
        point_a_x, point_a_y = x[a_idx], y[a_idx]

        max_area = -1.0
        best_b_idx = curr_bucket_start
        for b_idx in range(curr_bucket_start, curr_bucket_end):
            # 向量面积公式: 0.5 * |(Ax - Cx)(By - Ay) - (Ax - Bx)(Cy - Ay)|
            area = np.abs((point_a_x - avg_x) * (y[b_idx] - point_a_y) -
                          (point_a_x - x[b_idx]) * (avg_y - point_a_y))
            if area > max_area:
                max_area = area
                best_b_idx = b_idx

        sampled_x[out_idx] = x[best_b_idx]
        sampled_y[out_idx] = y[best_b_idx]
        a_idx = best_b_idx
        out_idx += 1

    # 最后一个点始终保留
    sampled_x[-1] = x[-1]
    sampled_y[-1] = y[-1]
    return sampled_x, sampled_y

# 验证效果:生成百万级带瞬态尖峰的时序波形
t = np.linspace(0, 1000, 1_000_000, dtype=np.float32)
signal = np.sin(t * 0.1) + np.random.normal(0, 0.05, 1_000_000)
# 插入一个单点异常脉冲
signal[450_231] = 8.5

sub_t, sub_signal = lttb_downsample(t, signal, threshold=2000)
print(f"数据量从 {len(t)} 点精简至 {len(sub_t)} 点")
print(f"异常峰值检测保留:{np.max(sub_signal):.2f} (原峰值: {np.max(signal):.2f})")
五、工程实施完整流程与关键技术分流
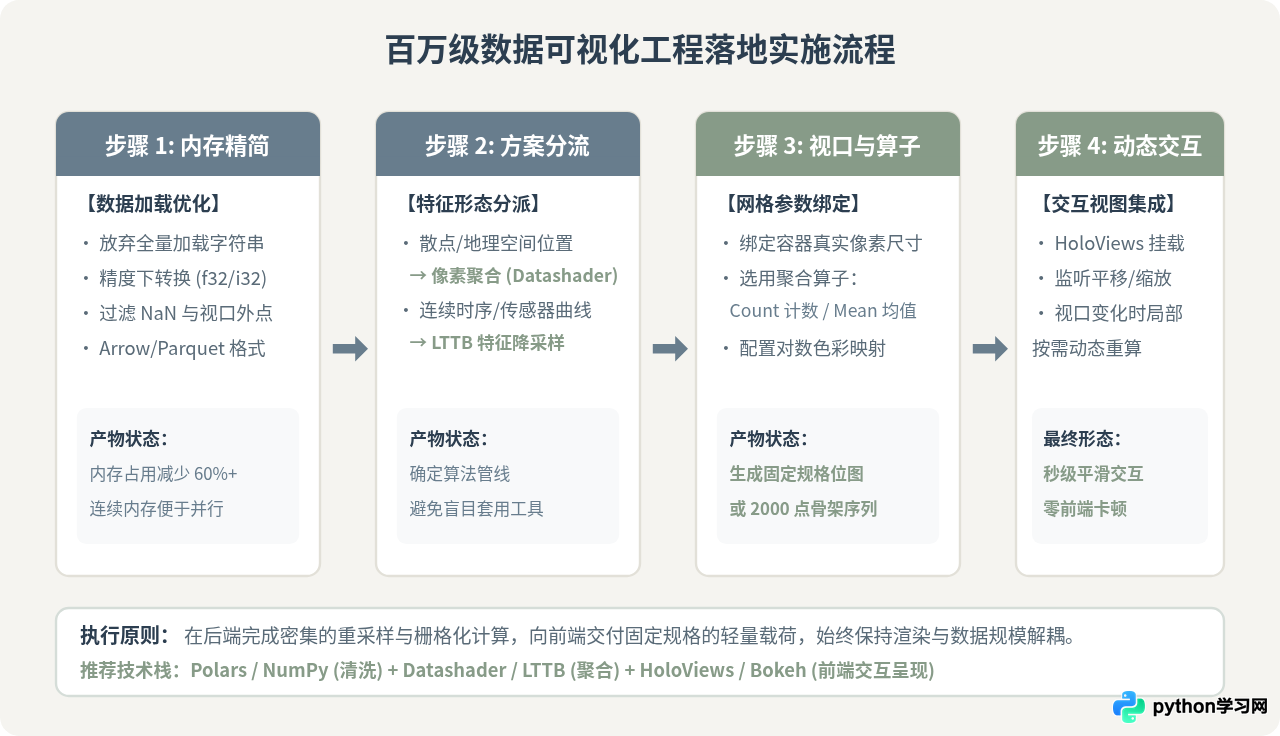
在实际项目落地中,百万级数据可视化不应盲目套用某一种工具,而应根据数据特征(散点、轨迹还是时序)、目标环境(交互式Web还是离线PDF报告)实施四步走的规范化流程。
六、关键差异对照:全量渲染 vs 栅格化聚合渲染
为了更清晰地理解为何技术选型直接决定了执行效率,下表在统一硬件基准环境(8核 CPU、16GB 内存、数据集为 1,000,000 行二维浮点点集)下,对比了全量矢量渲染与栅格化聚合渲染的关键差异。
| 对比维度 | 全量对象渲染 (Matplotlib plt.scatter) | 栅格化聚合渲染 (Datashader) | 差异为何重要 |
|---|---|---|---|
| 渲染执行耗时 | 约 25 ~ 45 秒 (常伴随未响应) | 约 0.15 ~ 0.35 秒 (即时返回) | 直接决定数据探索是否具备交互能力,百倍速度差距彻底消除等待焦虑。 |
| 内存峰值消耗 | 2.2 GB ~ 3.5 GB (容易 OOM) | 约 180 MB ~ 250 MB | 全量渲染的内存消耗随点数线性暴增;聚合渲染受限于固定像素画布,内存恒定受控。 |
| 视觉信息保真度 | 极差 (过绘制,中心形成纯黑硬边实心) | 极高 (连续对数色阶,清晰呈现局部密度) | 散点密集处全量渲染无法识别数据集中在中心还是均匀分布;聚合算法如实还原概率密度。 |
| 交互响应机制 | 缩放与平移时全量重绘,频繁卡死 | 视口变动仅重新生成 900×600 像素切片 | 前端只需传输和展示轻量图像,彻底解除浏览器端渲染引擎的计算与显存负担。 |
| 适用边界与局限 | 仅适合 5 万点以内的学术论文矢量出图 | 适合百万至千万级屏幕展示;打印放大有像素边界 | 选错工具会导致简单任务耗费巨大资源,必须根据最终交付媒介做正确取舍。 |
这种差异的核心在于认知维度的转换:许多工程师在遇到绘图卡顿时,第一反应往往是升级显卡或寻找更轻量的 JavaScript 前端库。但事实是,在物理分辨率只有百余万像素的显示器上,试图以矢量对象绘制上百万个几何体从数学和信息学上本身就是冗余的。理解“像素级聚合”而非“实体级遍历”,是解决海量数据可视化的底层思维转变。
七、常见排查与避坑指南
-
避开循环绘制与频繁创建图元:切忌在 Python 的
for循环中逐点调用plot()或annotate(),这会把函数调用开销放大数百万倍。始终以向量化(Vectorized)矩阵或批量聚合接口输入数据。 -
注意异常值对对数色阶的拉伸干扰:在 Datashader 中使用
how='log'或how='eq_hist'时,如果数据中存在极个别离群噪点(如数值比正常点大上万倍),直方图均质化会过度抬高背景底噪。应在聚合前通过 1% ~ 99% 的百分位截断(Clip)过滤异常极值。 -
静态印刷与海报级出图的折中方案:若必须输出高质量矢量图(如 SVG/PDF 交付出版),可以使用
matplotlib.pyplot.hexbin。Hexbin(正六边形蜂窝网格统计)将散点在数据层面聚合成有限个六边形图元(通常仅数千个),既保持了矢量图形的无损缩放特性,又避免了上百万个圆点带来的文件体积与解析灾难。
八、方案选型与优化总结
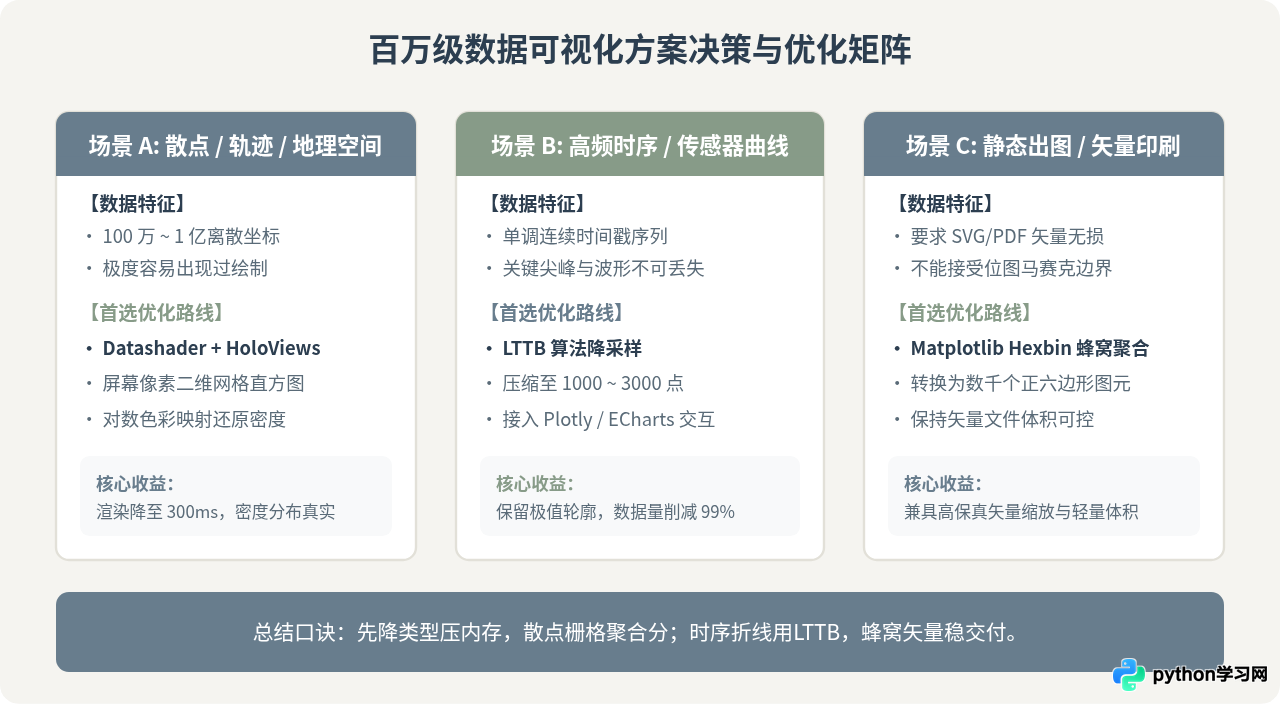
优化百万级数据可视化的精髓可概括为三个抓手:前置缩减内存类型、时序数据首选 LTTB 降采样、离散散点依赖 Datashader 栅格化。根据不同的业务场景,下图给出了清晰的工具栈决策树。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















