


怎么让Python输出的JSON字符串格式化缩进以便阅读

json 模块的 json.dumps() 函数,并传入 indent 参数(如 indent=4 或 indent=2)。若包含中文字符,搭配 ensure_ascii=False 即可避免中文被转义为 Unicode 编码。
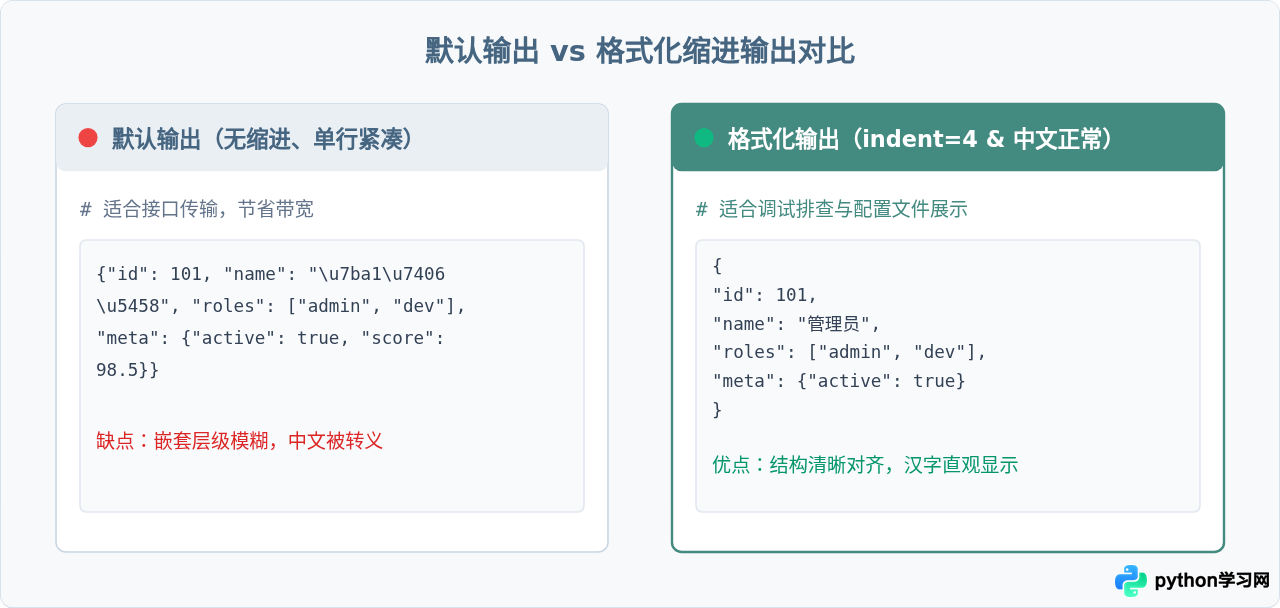
默认输出与格式化输出的对比
Python 自带的 json 模块是处理 JSON 数据的通用标准库。当我们调用 json.dumps(obj) 时,默认生成的 JSON 字符串是单行压缩的紧凑形式。这种格式去除了所有不必要的空格与换行,非常适合网络传输或存储以节省空间。
然而在本地调试、日志打印或生成配置文件时,单行 JSON 极难肉眼阅读。为了提升可读性,需要利用换行和层级缩进来清晰展示嵌套结构。
核心步骤:使用 indent 参数进行缩进
让输出具备缩进的关键在于 indent 参数。该参数接受一个正整数,代表每一级嵌套缩进的空格数量;通常使用 2 或 4。
1. 完整示例代码
import json

# 准备包含嵌套层级的字典数据
user_data = {
    "user_id": 10086,
    "user_name": "张小凡",
    "is_active": True,
    "tags": ["Python", "Backend", "AI"],
    "profile": {
        "city": "杭州",
        "department": "技术研发部"
    }
}

# 使用 indent=4 进行缩进格式化
formatted_json = json.dumps(user_data, indent=4)
print(formatted_json)
2. 运行结果示例
{
    "user_id": 10086,
    "user_name": "\u5f20\u5c0f\u51e1",
    "is_active": true,
    "tags": [
        "Python",
        "Backend",
        "AI"
    ],
    "profile": {
        "city": "\u67hang\u5dde",
        "department": "\u6280\u672f\u7814\u53d1\u90e8"
    }
}
可以看到,设置 indent=4 后,对象中的每一层属性以及数组中的每个元素都会自动另起一行并缩进 4 个空格,层级关系一目了然。
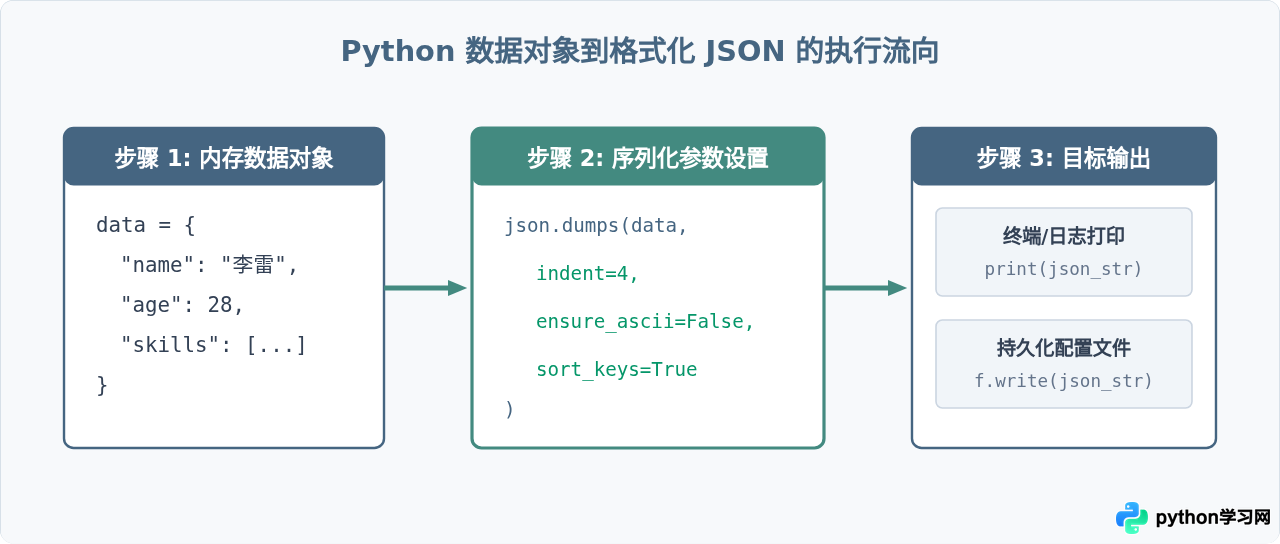
操作流向:从数据对象到格式化输出
理解数据在转换过程中的流动路径,有助于根据不同输出介质选择合适的方法:
- 如果需要字符串变量:使用
json.dumps()(带 s,表示 string)。 - 如果需要直接写入文件:使用
json.dump()(不带 s,直接操作文件流)。
关键配合参数:解决中文与排序问题
仅仅设置 indent 往往还不够。在日常开发中,常会遇到中文显示乱码(被转义为 \uXXXX)以及键值顺序错乱的问题。掌握以下几个参数配合,可以让输出更为规整。
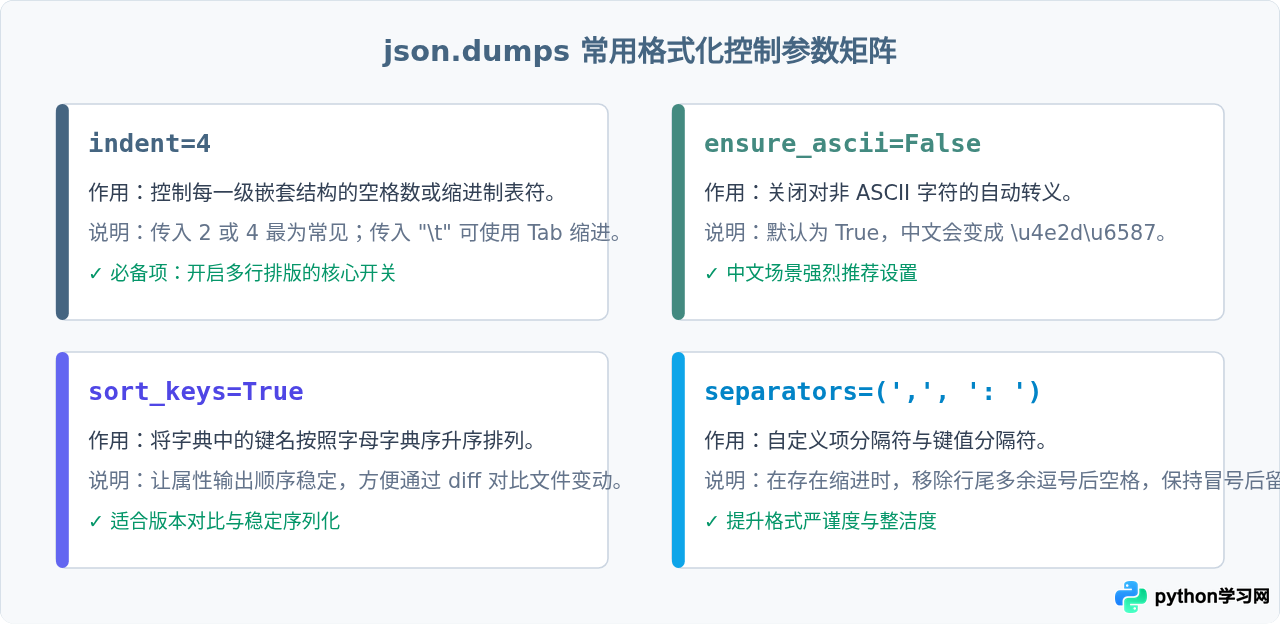
1. 正确显示中文字符:ensure_ascii=False
Python 默认为了保证输出内容能纯粹在 ASCII 环境下工作,会将非 ASCII 字符转换为十六进制转义形式。只需传入 ensure_ascii=False,就能直接输出原生的 UTF-8 汉字。
2. 统一键名顺序:sort_keys=True
如果需要对比两个配置字典的差异,或者希望输出的 JSON 属性具有固定的先后次序,可以开启 sort_keys=True。它会递归地将每个字典对象的属性按字母升序排列。
3. 组合使用代码示例
import json

payload = {
    "zebra": "斑马",
    "apple": "苹果",
    "cat": "猫咪",
    "details": {
        "count": 3,
        "location": "北京朝阳"
    }
}

# 组合参数:缩进 4 格 + 保持中文 + 键名按字母排序
pretty_json = json.dumps(
    payload,
    indent=4,
    ensure_ascii=False,
    sort_keys=True,
    separators=(',', ': ')
)

print(pretty_json)
运行输出:
{
    "apple": "苹果",
    "cat": "猫咪",
    "details": {
        "count": 3,
        "location": "北京朝阳"
    },
    "zebra": "斑马"
}
直接将格式化 JSON 写入文件
如果要将格式化后的数据直接保存到磁盘文件,不需要先 dumps 成字符串再 write,而是可以直接使用 json.dump()。它的参数列表与 json.dumps() 保持一致:
import json

config = {
    "app_name": "支付网关",
    "version": "1.2.0",
    "debug": False,
    "allowed_hosts": ["127.0.0.1", "api.example.com"]
}

# 打开文件时指定 encoding='utf-8',避免在 Windows 默认编码下报错
with open("config.json", "w", encoding="utf-8") as f:
json.dump(config, f, indent=4, ensure_ascii=False, sort_keys=True)open() 函数中指定 encoding='utf-8'。否则在 Windows 系统上,默认可能会使用 GBK 编码写入,导致生成的 UTF-8 文件在其他平台打开出现乱码。
扩展技巧:使用命令行工具直接格式化
如果你已经在终端中拿到了一段紧凑的 JSON 文本或者一个无缩进的 .json 文件,无需特意写一段 Python 脚本,Python 自带的 json.tool 命令行模块就能快速完成格式化。
# 格式化已有文件并输出到终端
python -m json.tool input.json

# 通过管道格式化 curl 或 echo 输出的内容
echo '{"status":200,"msg":"success"}' | python -m json.tool
总结与开发建议
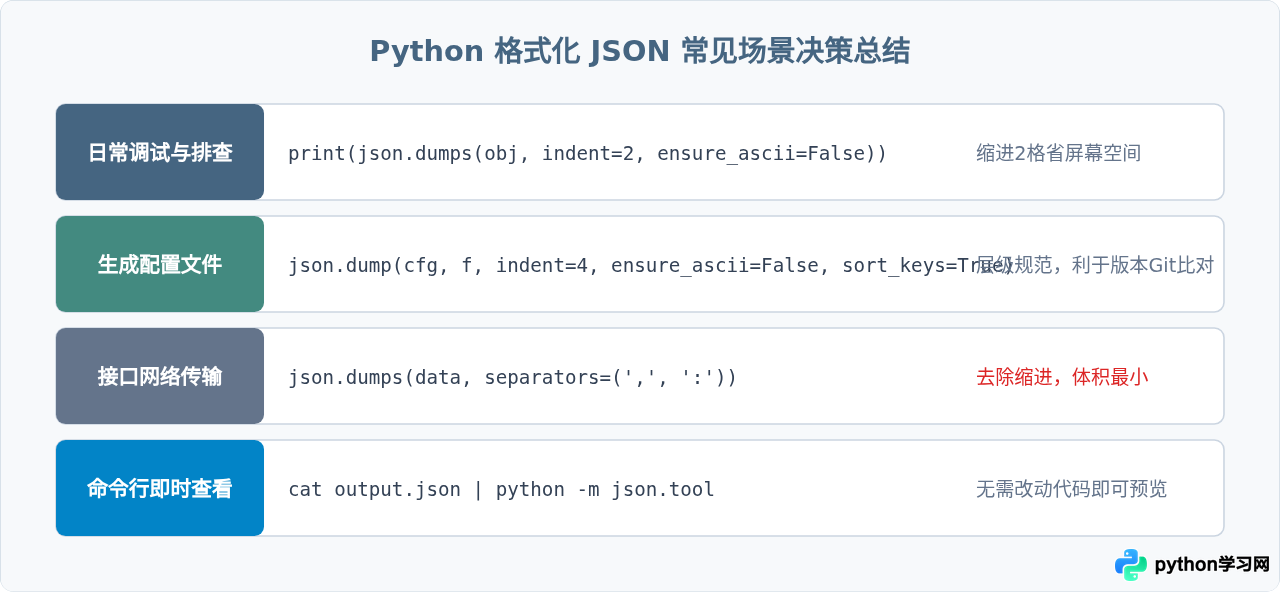
在实际工程开发中,建议根据具体的使用场景选择匹配的参数配置:
| 参数 | 默认值 | 推荐设置 | 应用目的 |
|---|---|---|---|
indent |
None(单行紧凑) |
2 或 4 |
开启缩进与换行,赋予层次感 |
ensure_ascii |
True |
False |
允许直接输出非 ASCII 原生字符,正常显示汉字 |
sort_keys |
False |
True(视需求而定) |
字典键名按字母排序,消除不确定性,便于代码比对 |
separators |
(', ', ': ') |
(',', ': ') |
规范分隔符,避免多行缩进时行尾产生无意义的空格 |
综上所述,让 Python 输出易读的 JSON 字符串只需在调用 json.dumps() 时加上 indent=4 和 ensure_ascii=False 即可。在开发调试阶段养成格式化打印的习惯,能显著降低数据结构的排查成本;而在生产部署与接口交互时,再切回无缩进模式以保持最高传输效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















