


从运行原理看Python和Java的区别:解释执行与字节码编译
深入剖析 Python 与 Java 的底层运行机制,从源码编译、字节码设计、虚拟机执行循环到 JIT 即时编译,揭示两者在性能、并发与适用场景上的本质区别。
一、核心认知澄清:两者都产生字节码,但分工完全不同
在理解更深层的原理之前,必须先纠正一个长期存在的认知偏差:“Python 没有编译步骤,直接由解释器逐行读取文本源码运行”。
实际上,只要你在终端运行过 Python 脚本,就会在工程目录下看到 __pycache__ 文件夹,里面存放着带有 .pyc 后缀的文件。这个 .pyc 文件正是 Python 的字节码文件(Bytecode)。同样地,Java 开发者使用 javac 编译后产生的 .class 文件也是字节码。
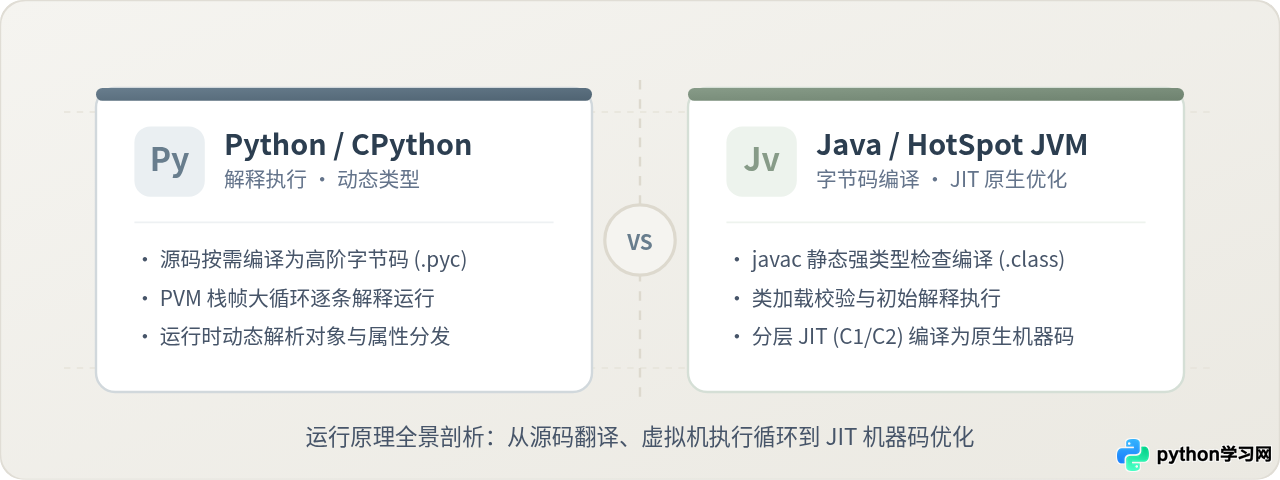
既然二者都运行在“字节码”这一中间层之上,为什么 Python 会被普遍当作“解释执行”,而 Java 却被视作“编译型高吞吐”的代表?答案就在虚拟机的底层架构与翻译机制中:
- Python(CPython 实现):源码在运行期被即时编译为高阶抽象的动态字节码。Python 虚拟机(PVM)通过一个巨大的 C 语言大循环,逐条提取指令并进行多态分发。默认情况下,PVM 不会生成任何直接由物理 CPU 运行的原生机器码,指令始终停留在虚拟栈的软件模拟中。
- Java(HotSpot JVM 实现):源码在开发或构建阶段由
javac完成强类型的静态编译,输出高度精简、类型特化的字节码。JVM 启动后先由解释器快速执行,但内置的热点探测引擎会迅速捕捉频繁执行的代码段(热点代码),并通过 JIT(Just-In-Time,即时编译器)将其直接重构并编译为高度优化的原生 CPU 机器指令,存入 Code Cache 高速执行。
二、Python (CPython) 的运行原理:源码到 PVM 字节码循环
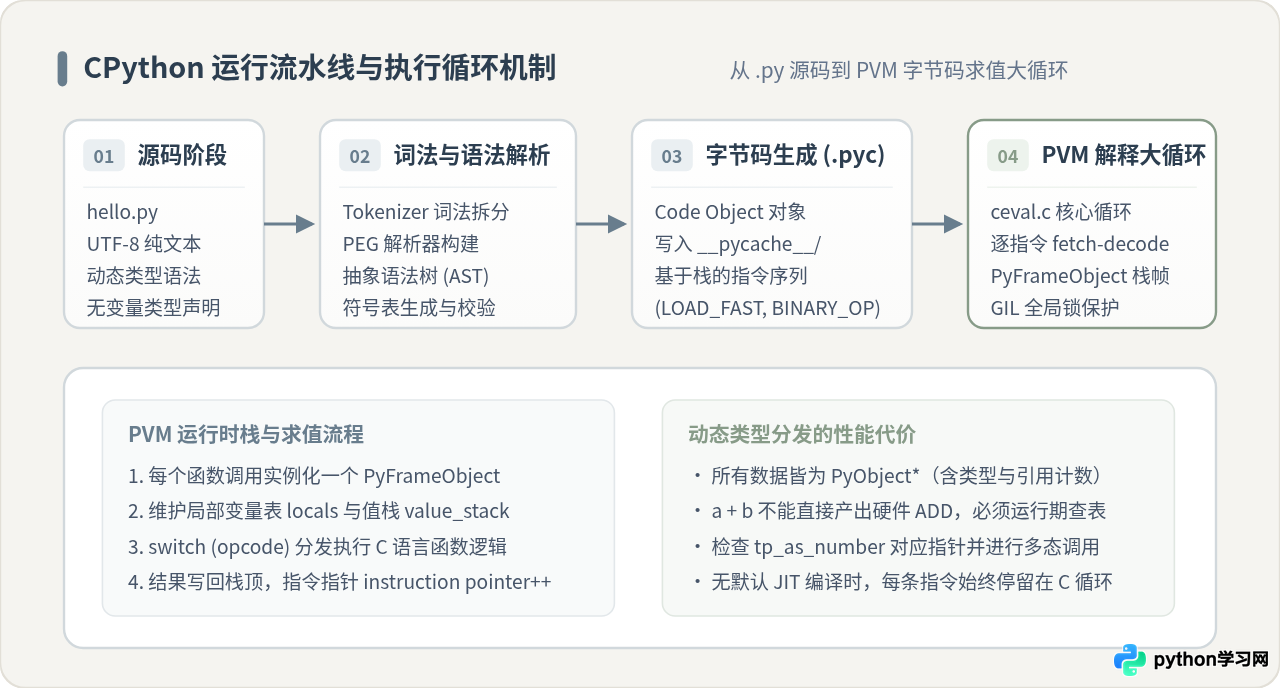
我们以官方标准实现 CPython 为例。当你在命令行执行 python main.py 时,内部会严格经历四个阶段:
1. 词法、语法解析与抽象语法树(AST)
Python 解释器启动后,首先由词法分析器(Tokenizer)将 .py 文本拆解为标记序列(Tokens),接着通过基于 PEG 算法的解析器构建出抽象语法树(AST)。在此阶段,解释器验证语法是否合法,但完全不关心变量的数据类型。
2. 生成 Code Object 与写入 .pyc 缓存
编译器遍历 AST,生成 Python 的核心数据结构 —— Code Object(代码对象)。它封装了基于栈的字节码指令数组(co_code)、常量池(co_consts)、局部变量名表(co_varnames)等。为了避免下次启动重复解析,CPython 会将包含魔法数、时间戳和序列化 Code Object 的数据写入 __pycache__/*.pyc 文件中。
3. PVM 栈帧与 ceval.c 求值大循环
当字节码被送入 Python 虚拟机(Python Virtual Machine, PVM)后,每个函数调用都会在 C 语言堆栈上分配一个 PyFrameObject(栈帧)。栈帧内包含局部变量表和用于暂存操作数的值栈。
PVM 的核心实现位于 CPython 源码的 Python/ceval.c 文件中。它本质上是一个庞大的 switch-case 循环结构(函数名为 _PyEval_EvalFrameDefault):
// CPython 核心解释循环概念简化
for (;;) {
    opcode = *next_instr++;
    switch (opcode) {
        case LOAD_FAST:
            // 从当前帧的局部变量数组读取 PyObject*,推入值栈
            PUSH(GETLOCAL(oparg));
            DISPATCH();
        case BINARY_OP:
            // 弹出栈顶两个对象,进行动态计算
            right = POP();
            left = TOP();
            // 动态检查类型并调用对应的 C 函数指针
            res = left->ob_type->tp_as_number->nb_add(left, right);
            SET_TOP(res);
            DISPATCH();
    }
}ob_type 类型结构体,通过指针查找数值槽中的 nb_add,再调用底层的 C 函数,最终在内存中分配一个新的 PyLongObject 返回。这种在软件循环内的反复指针跳转与堆内存分配,构成了 Python 纯解释执行的固有开销。
三、Java (HotSpot JVM) 的运行原理:静态编译与分层 JIT 原生优化
Java 的执行模型与 Python 截然不同。Java 采取了“静态前期验证 + 运行时动态优化”的双重设计:
1. 编译期 AOT(javac 静态编译)
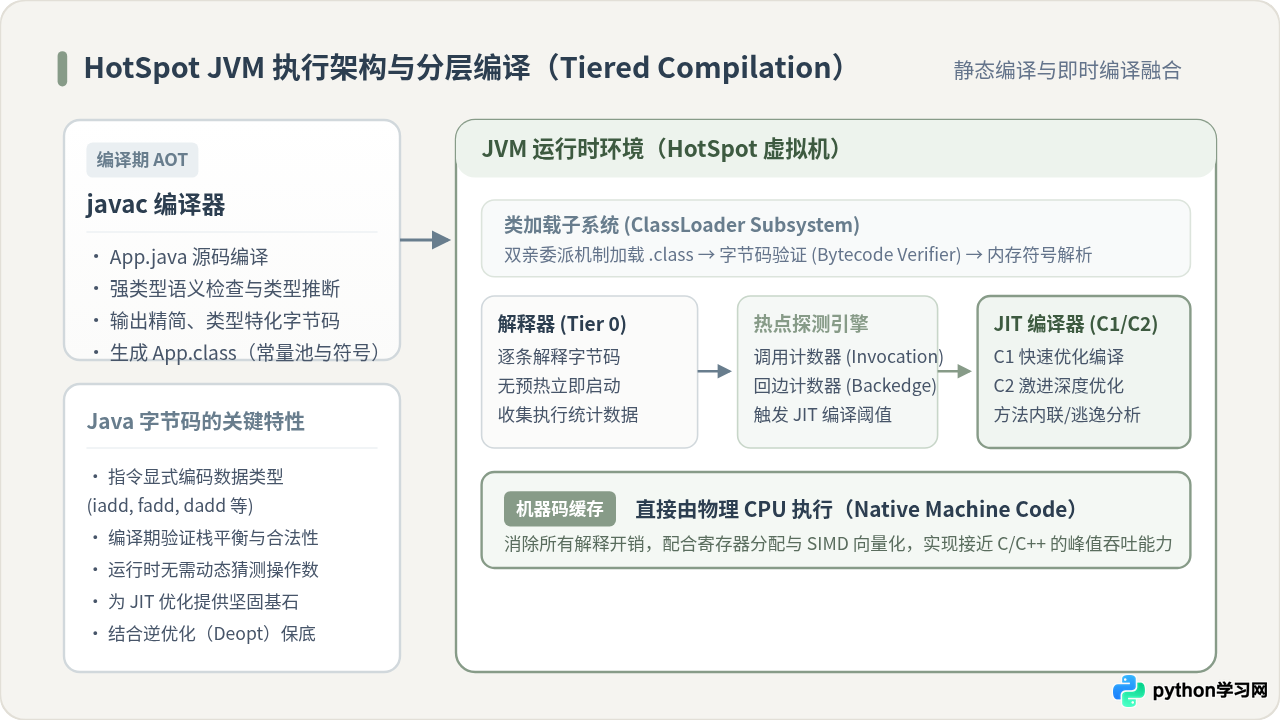
与 Python 在运行时按需解析不同,Java 源码必须显式通过 javac 命令提前编译为 .class 文件。在此阶段:
- 编译器完成严格的静态类型检查、符号引用解析与语法糖脱糖。
- 生成的字节码指令显式包含了数据类型信息。例如:整数相加对应
iadd,长整数相加对应ladd,单精度浮点相加对应fadd。这种类型特化使得后续执行引擎不需要在运行时猜测操作数类型。
2. 类加载子系统与字节码验证
当执行 java Main 时,JVM 通过 ClassLoader 双亲委派模型载入 .class 文件,并在内存中进行字节码校验(Bytecode Verifier)。它会核查操作数栈是否越界、类型强转是否合法、跳转指令是否越界等,在程序执行前杜绝大量非法内存破坏行为。
3. 执行引擎:解释执行与分层 JIT 编译(Tiered Compilation)
许多人误以为 Java 是一次性编译为机器码,实际上现代 HotSpot JVM 采用的是高效的分层编译架构:
- 解释执行(Tier 0):JVM 刚启动时,为了避免漫长的编译等待,解释器会立即逐条读取
.class中的字节码并运行。此时的机制与 Python 解释器类似,但指令类型明确,执行效率更高。 - 热点探测(Profiling):在解释执行过程中,JVM 内部的计数器开始工作 —— 统计方法调用次数的“调用计数器(Invocation Counter)”以及统计循环回边次数的“回边计数器(Backedge Counter)”。当某段代码执行频次达到预设阈值,即被判定为“热点代码”。
- C1 客户端编译器(Tier 1~3):针对高频代码快速进行局部优化编译,生成初级机器码并加入缓存,立即可见性能提升。
- C2 服务端编译器(Tier 4):对最核心的热点代码进行激进的深度全局优化。优化手段包括:
- 方法内联(Method Inlining):消除函数调用的栈帧压栈与跳转开销。
- 逃逸分析(Escape Analysis):若分析得出对象不会逃逸出当前方法,则将堆对象直接拆散在栈上分配(标量替换),完全绕过垃圾回收。
- 循环展开与向量化(SIMD):利用 CPU 的 AVX 指令集进行并行计算。
经过 C2 编译后的热点代码,已经完全成为纯粹的物理 CPU 机器码,执行速度直接逼近 C/C++ 的硬件性能。
四、关键细节对照:以「a + b」为例看底层差异
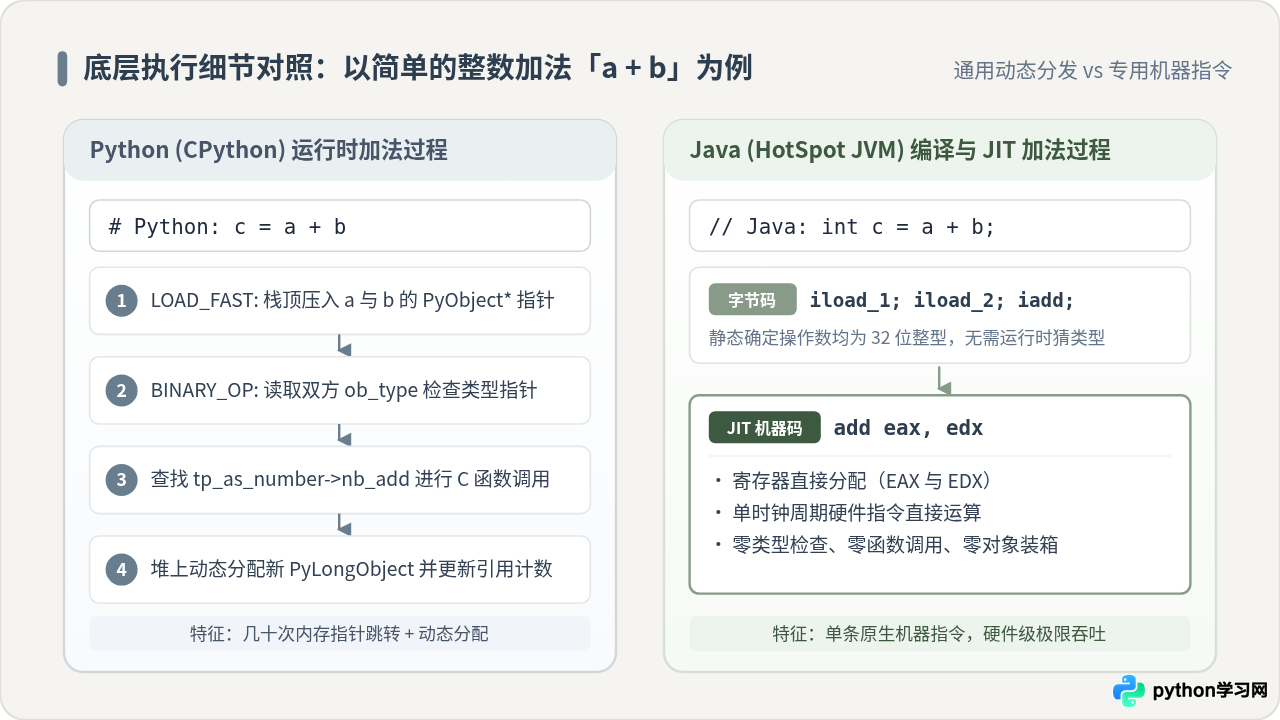
为了直观对比两种运行机制的差距,我们通过反汇编工具,观察两门语言在计算最简单的 a + b 时究竟发生了什么:
1. Python 的反汇编与底层执行
import dis

def add(a, b):
    return a + b

dis.dis(add)
其生成的字节码输出如下:
  2           0 RESUME                   0
              2 LOAD_FAST                0 (a)
              4 LOAD_FAST                1 (b)
              6 BINARY_OP                0 (+)
10 RETURN_VALUE底层流转:BINARY_OP 是通用操作码。PVM 并不知道 a 和 b 是整数、浮点数还是字符串拼接。每次执行,PVM 必须解引用 PyObject*,读取类型槽,进行条件判断和函数分发,并在堆上为计算结果申请一个新对象的内存空间。
2. Java 的反汇编与底层执行
public class Calculator {
    public static int add(int a, int b) {
        return a + b;
    }
}
通过 javap -c Calculator 查看编译出的字节码:
public static int add(int, int);
  Code:
     0: iload_0
     1: iload_1
     2: iadd
3: ireturn底层流转:指令是明确的 iadd,只接受 32 位整型输入。而在方法被高频调用触发 JIT 编译后,JVM 直接将其编译为一条 x86-64 汇编指令:
add eax, edx此时数据直接存放在 CPU 物理寄存器 EAX 和 EDX 中,在一个时钟周期内即可完成硬件级相加。没有任何类型判断,没有间接指针寻址,更没有内存分配。
五、运行机制差异对系统特性的综合影响
底层的运行机制直接塑造了两种语言在工程表现上的截然不同:
1. 内存布局与缓存局部性
Python 中一切皆对象。一个 64 位系统下的标准整数 int 实际是一个完整的 PyLongObject,包含对象头、引用计数和类型指针,至少占用 28 字节;若存储列表,存放的也是分散的对象指针。这种内存跳跃导致 CPU 很难命中 L1/L2 硬件缓存。
而 Java 区分原始类型(Primitive Types,如 int 占 4 字节)与引用类型,原始类型数组在物理内存中连续排布,极大提高了 CPU 的预取与缓存命中率。
2. 多线程与并发模型
CPython 解释器的求值大循环由全局解释器锁(GIL, Global Interpreter Lock)保护。这意味着即使在多核 CPU 服务器上,一个 Python 进程内的多线程在同一瞬间也只能有一个线程在解释字节码,无法直接通过多线程利用多核算力(计算密集型场景通常需要借助多进程 multiprocessing)。
相反,Java 拥有工业级严谨的 Java 内存模型(JMM),Java 线程直接对应操作系统内核线程(1:1 模型),配合 JIT 的无锁指令优化,能够完美榨干多核服务器的高并发性能。
六、全景对比与工程选型建议
根据两种语言底层的编译与执行特性,我们可以将关键维度归纳如下:
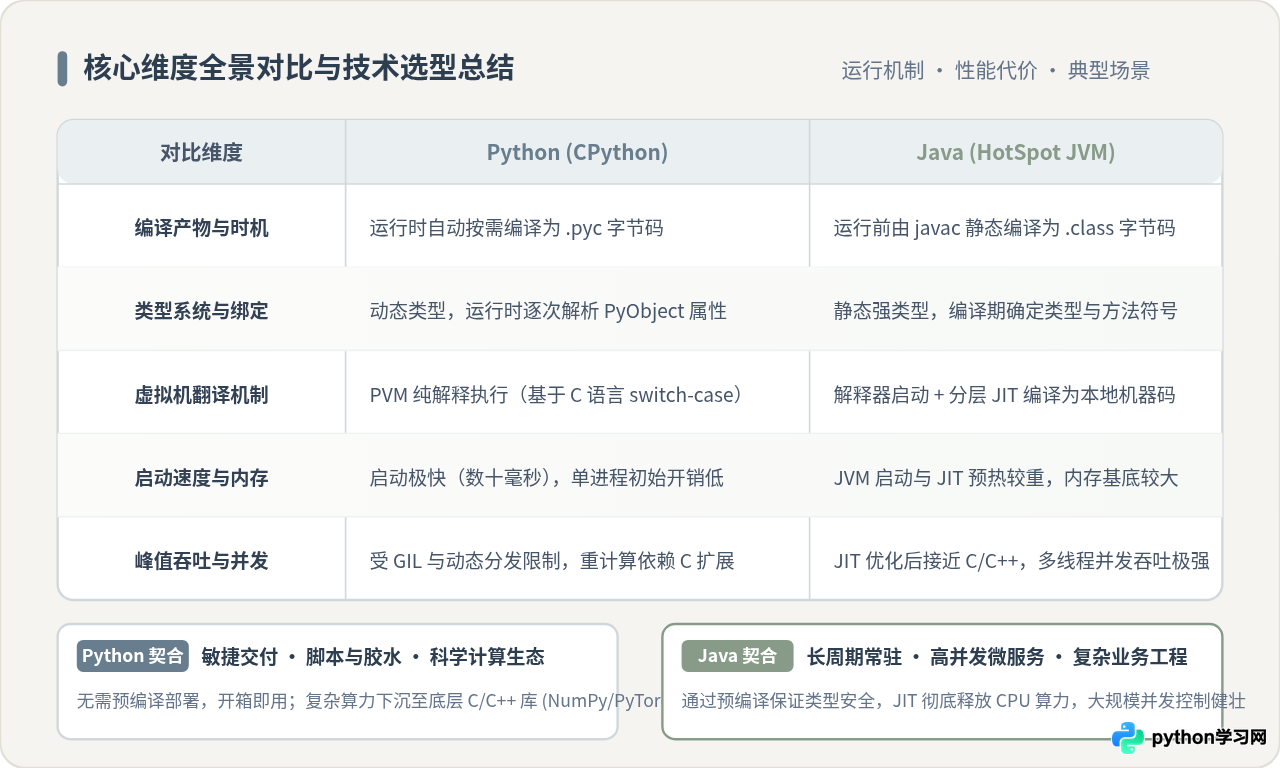
| 比较维度 | Python (CPython) | Java (HotSpot JVM) |
|---|---|---|
| 编译时机 | 运行期动态按需编译(生成 .pyc) |
开发/构建期 AOT 静态编译(生成 .class) |
| 类型系统 | 动态类型,变量无类型,对象有类型,运行时多态分发 | 静态强类型,编译期验证,字节码指令显式编码类型 |
| 运行翻译 | 纯软件解释循环(逐指令 fetch-decode,默认无 JIT) | 解释器启动 + 分层 JIT 编译为物理原生机器码 |
| 冷启动速度 | 极快(通常数十毫秒即可完成加载并输出) | 较慢(JVM 初始化、类加载与字节码验证需要数百毫秒) |
| 峰值吞吐量 | 受动态解析与 GIL 限制,CPU 密集型算力吞吐较低 | JIT 优化后接近 C/C++,高并发多线程吞吐能力极强 |
| 跨平台实现 | 依赖各个平台的 Python 解释器重新解释执行 | “一次编写,到处运行”依赖各平台特定的 JVM 虚拟机 |
常见认知误区澄清
- 误区一:“Python 性能差是因为它是解释型,Java 性能好是因为它是编译型”
更准确的表达是:Python 性能较低的主因是动态类型带来的运行时查找成本以及缺少原生 JIT 机器码优化;Java 的高性能主要得益于静态类型在编译期排除了类型不确定性,以及 HotSpot JIT 编译器在运行时进行的激进重构。 - 误区二:“Python 完全无法获得 JIT 优化”
并非如此。Python 生态中有替代实现 PyPy,它内置了 Tracing JIT,性能显著高于 CPython;同时 CPython 3.13 及后续版本也在逐步探索实验性的 JIT 编译器。但由于 Python 极其动态的语言语义(如随时动态修改类和属性),JIT 优化的难度远大于静态类型的 Java。 - 误区三:“既然 Java 性能更好,所有场景都应优先选 Java”
软件工程的核心是平衡开发效率与运行成本。Python 凭借免编译、秒级启动和极其简洁的语法,在自动化运维、CLI 工具、数据分析和机器学习编排领域拥有无可替代的敏捷优势(底层的复杂计算通常交由 C/C++ 和 CUDA 扩展库执行);而在长周期常驻、吞吐量敏感、并发要求极高的企业级核心业务系统与大数据生态中,Java 的底层架构优势则展现得淋漓尽致。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















