


详解Python名称修饰(Name Mangling):为什么__attr变成了_ClassName__attr

_类名__属性名 的格式。这种机制被称为名称修饰(Name Mangling)。它的存在并非为了实现真正意义上的私有权限封装,而是为了在多重继承与类派生场景下,为当前类划定专属命名空间,防止子类无意间覆盖父类的关键内部状态。
现象直观呈现:属性是如何“消失”并变形的
很多开发者在初学Python面向对象时,常常使用双下划线来声明所谓的“私有变量”。然而,在类外部直接调用该属性时,Python会立即抛出 AttributeError:
class Account:
    def __init__(self, owner, balance):
        self.owner = owner
        self.__balance = balance  # 双下划线开头

acc = Account("Alice", 5000)
print(acc.owner)       # 正常输出: Alice
print(acc.__balance)   # 抛出 AttributeError: 'Account' object has no attribute '__balance'
此时若通过内置函数 dir() 观察实例的属性字典,会发现 __balance 并没有真正消失,而是以一个新的键名静静躺在实例命名空间中:
print(dir(acc))
# 输出列表中包含: '_Account__balance', 'owner', ...

# 尝试通过转换后的名称访问:
print(acc._Account__balance)  # 成功输出: 5000
这种通过静态语法重写改变属性标识符的过程,就是名称修饰。要彻底理解这一机制,首先需要掌握Python编译器判定是否进行修饰的具体规则。
名称修饰的触发条件与规则判定
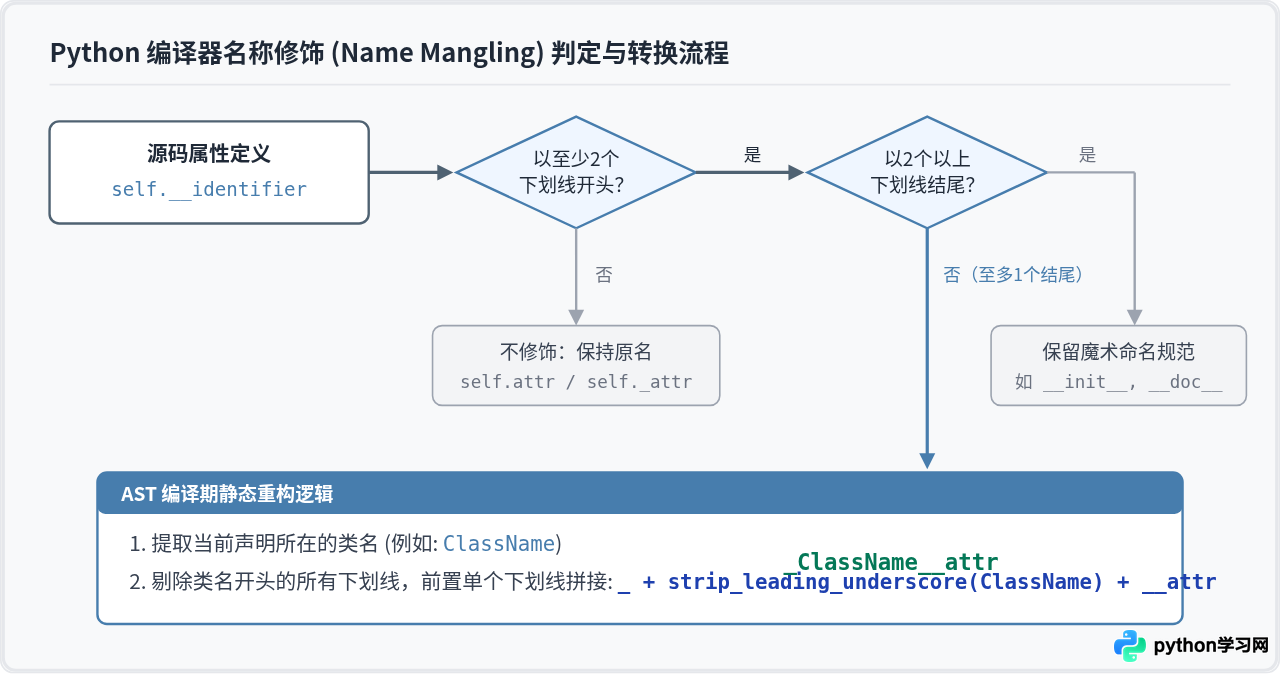
并非所有包含下划线的属性都会被修饰。Python编译器在将源代码编译为字节码时,遵循严格的语法匹配模式:
- 必须至少以两个下划线开头:例如
__value、___deep均满足条件。单下划线如_protected不会触发修饰。 - 至多以一个下划线结尾:例如
__data_会被修饰,但如果以两个或两个以上下划线结尾(如__init__、__str__、__doc__),编译器会将其认定为语言内置的特殊方法(Magic / Dunder Methods),绝不进行修饰。 - 类名自身的修饰规则:在合成新名称
_ClassName__attr时,如果定义所在的类名本身带有前导下划线,Python会先去除类名前部的所有下划线。例如在类class _Worker:中定义self.__id,修饰后的结果依然是_Worker__id,而不是__Worker__id;如果类名全由下划线组成(如class ___:),则保留类名本身。
核心原因:为什么需要这层机制?
很多开发者误以为 __attr 是 Python 提供的“Private 访问修饰符”。但只要知道修饰后的名字,外界依然可以直接读写该变量。既然防不住外部访问,Python 的设计者为何要大费周章设计这套重写逻辑?
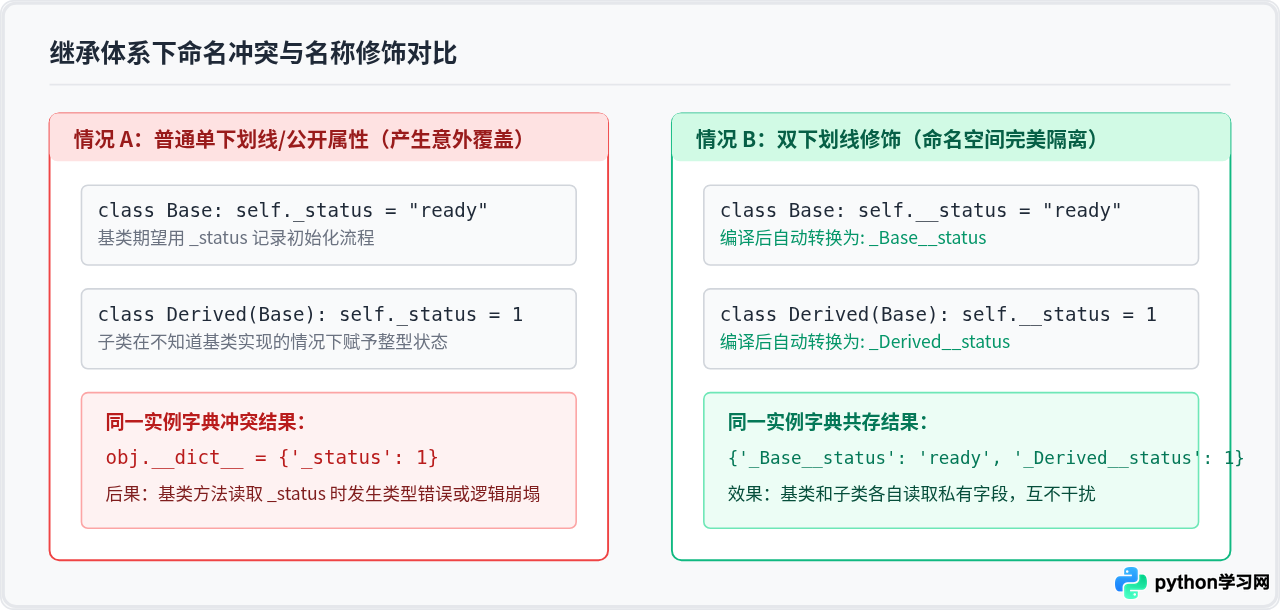
其核心目的只有一个:避免子类与父类之间的命名冲突,保障继承层次的安全性。
在复杂的面向对象系统或包含多继承的架构中,基类往往需要维护自身专属的内部状态或辅助方法。如果子类的编写者与基类的编写者不是同一个人(例如基类来自第三方框架),子类极有可能无意中定义了同名属性。如果没有名称修饰,子类的定义就会直接覆盖基类属性,破坏基类的内部运作。
代码验证:继承隔离的实际运作
我们通过一段具体的Python代码来验证图2中的机制:
class BaseEngine:
    def __init__(self):
        self.__setup()  # 意图调用自己的内部初始化

    def __setup(self):
        self.__config = "BASE_CONFIG"

    def print_config(self):
        # 编译期被重写为访问 self._BaseEngine__config
        print("BaseEngine config:", self.__config)


class TurboEngine(BaseEngine):
    def __init__(self):
        super().__init__()
        self.__setup()  # 子类也定义了一个内部初始化方法

    def __setup(self):
        self.__config = "TURBO_CONFIG"

engine = TurboEngine()
engine.print_config()
print("实例底层属性字典:", engine.__dict__)
运行该程序后,终端打印的示例输出如下:
BaseEngine config: BASE_CONFIG
实例底层属性字典: {'_BaseEngine__config': 'BASE_CONFIG', '_TurboEngine__config': 'TURBO_CONFIG'}
可以看到,基类与子类的 __setup 与 __config 均被赋予了带有各自类名前缀的独立键名。基类中的 self.__setup() 在执行时准确调用了基类的版本,并未被子类的同名方法意外覆盖。
编译期静态重构:底层到底发生了什么?
理解名称修饰的关键,在于认识到它是一次完全由编译器在语法分析阶段完成的纯文本重写,而不是运行期的动态拦截(如 __getattr__ 或属性描述符)。
我们可以使用Python内置的 dis 模块反编译包含双下划线属性的方法,直接观察字节码指令:
import dis

class Sample:
    def set_value(self, val):
        self.__secret = val

dis.dis(Sample.set_value)
输出的字节码指令清晰地证明了名称修饰的时机:
  3           0 LOAD_FAST                1 (val)
              2 LOAD_FAST                0 (self)
              4 STORE_ATTR               0 (_Sample__secret)
              6 RETURN_CONST             0 (None)
在字节码第4行中,存储指令操作的属性标识符已经直接是常量符号表里的 _Sample__secret,原始代码中的 __secret 在编译产物中根本不复存在。
正因为修饰是在编译类体时完成的,如果在类定义体之外动态挂载双下划线属性,解释器不会对其进行修饰:
s = Sample()
s.__dynamic = 123  # 在类外部动态添加
print(s.__dynamic) # 正常打印: 123
print(s.__dict__)  # 输出: {'__dynamic': 123},名字并未发生任何改变!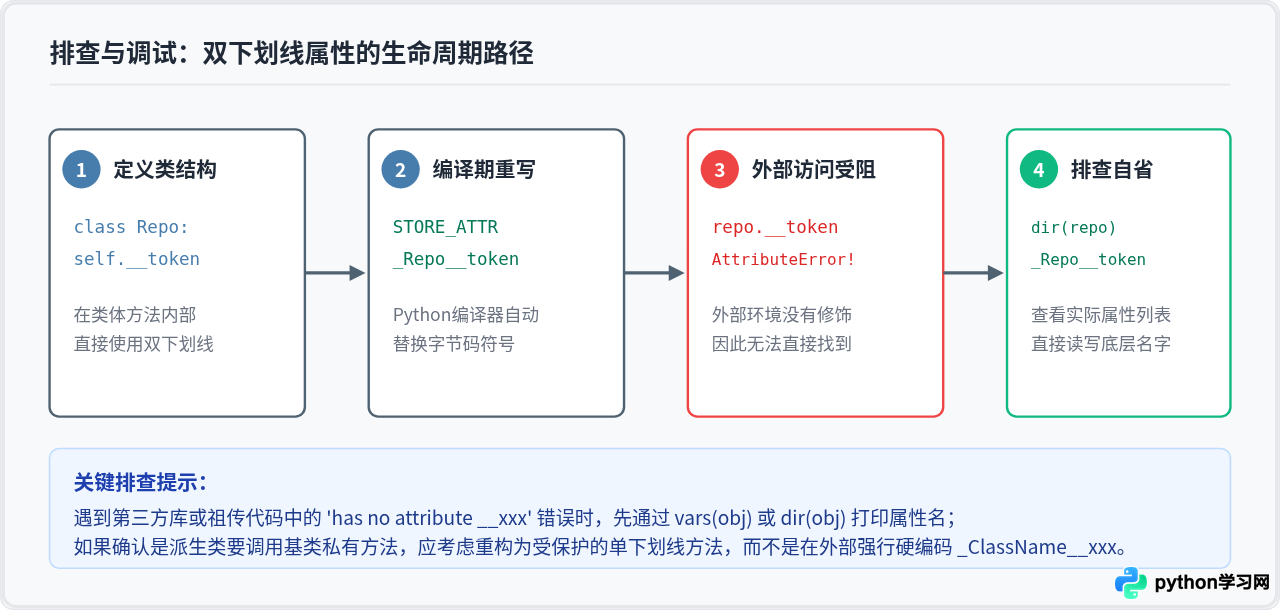
工程实践:下划线命名的选择与边界权衡
在Python社区中,“我们都是成年人”(We are all consenting adults here)是一条广泛认同的设计哲学。Python并不通过语法限制严格剥夺开发者对属性的访问能力。了解了名称修饰后,在日常工程开发中应该如何恰当选择命名前缀?
常见误区与避坑建议
- 不要盲目用双下划线伪装“私有”:将属性命名为
__attr会给单元测试、继承拓展和交互式调试带来显著的不便。子类若合法需要访问父类的内部状态,由于名称已被修饰,只能写出难看且脆弱的self._Parent__attr。在大多数业务场景下,单下划线_attr配合团队约定已经足够明确。 - 双下划线真正适合的场景:设计通用的多重继承基类(Mixins)、基础库或框架代码。在这些场景中,基类无法预测外界用户会派生出怎样的子类,采用双下划线修饰私有辅助状态能够保证基类自洽运转,不会因为使用者随便起了一个常见的变量名而发生覆盖崩溃。
- 避免在类外部硬编码修饰名:像
obj._ClassName__attr这种写法破坏了封装边界,并且一旦类名重构更改,所有外部调用点都会立即失效。如果外部确实需要读取该状态,应当通过@property显式暴露只读访问器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















