


Python常用第三方库有哪些?数据、Web与自动化领域核心库盘点
一、数据处理与科学计算核心库
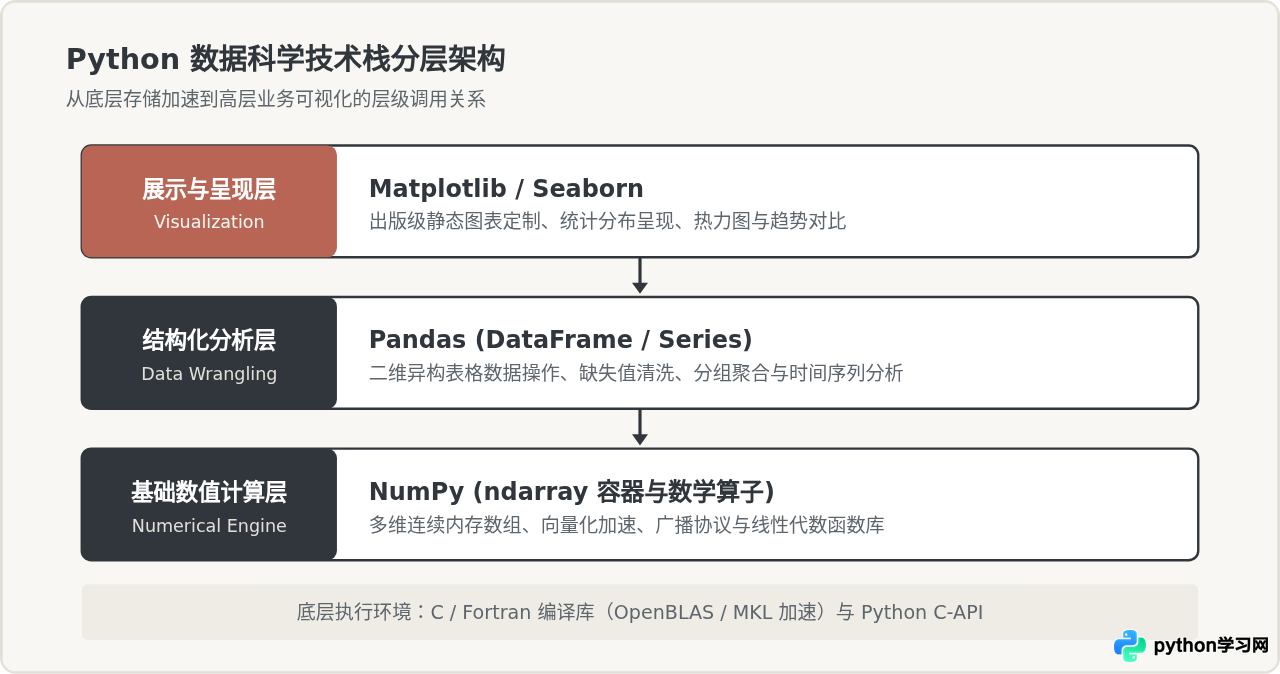
在数据科学与分析领域,Python 形成了以“底层数组容器 -> 表格结构分析 -> 数据可视化”为骨架的标准技术栈。理解这套体系的关键在于认识到:各个库并不是孤立存在的,而是依托统一的内存与计算协议紧密咬合。
1. NumPy:高性能多维数组与向量化基石
NumPy(Numerical Python)是整个 Python 科学计算生态的基础。原生 Python 列表(List)存储的是对象指针,不仅存在显著的寻址开销,也无法直接利用 CPU 的连续缓存优化。NumPy 提供了基于 C 语言连续内存块的 ndarray(N-dimensional Array)对象,并实现了高效的广播机制与向量化算子。
- 核心特点:支持同构多维数组、底层 C 级连续内存布局、SIMD 硬件指令加速、线性代数与随机数生成。
- 适用场景:大规模数值计算、图像矩阵变换、机器学习特征工程的底层张量操作。
2. Pandas:结构化数据分析与清洗利器
如果说 NumPy 解决了“数字矩阵怎么算得快”的问题,那么 Pandas 解决的则是“现实业务中的表格数据怎么理得清”的问题。Pandas 核心构建在 Series(单维带索引标签)和 DataFrame(二维表格数据容器)之上,提供了极度丰富的数据导入导出、缺失值插补、分组聚合(GroupBy)与时间序列处理接口。
- 核心特点:智能对齐行索引与列标签、内置强大且灵活的 SQL 级连接(Merge/Join)操作、支持复杂重塑透视(Pivot/Melt)。
- 适用场景:数据报表清洗、ETL 数据转换、指标统计聚合、时序指标特征提取。
3. Matplotlib 与 Seaborn:专业级数据可视化
数据处理的最后一步通常是洞察呈现。Matplotlib 是 Python 最底层的静态绘图标准库,具有极高的图表定制颗粒度,能够精准控制从坐标轴刻度、标签位置到几何标注的每个像素细节。而 Seaborn 则是建立在 Matplotlib 之上的高级统计绘图封装,默认整合了 Pandas DataFrame,能以更少的代码绘制分布箱线图、热力图及回归拟合曲线。
以下为一个典型的数据处理组合示例,展示如何从 NumPy 随机生成矩阵过渡到 Pandas 分组清洗:
import numpy as np
import pandas as pd

# 1. 利用 NumPy 生成包含随机浮点与整型的多维模拟数据
np.random.seed(42)
records_count = 1000
data = {
    "dept_id": np.random.choice(["Tech", "Marketing", "Sales", "Ops"], size=records_count),
    "work_years": np.random.randint(1, 15, size=records_count),
    "kpi_score": np.random.normal(loc=80, scale=8, size=records_count).round(2),
}

# 2. 载入 Pandas DataFrame 进行结构化清洗与指标聚合
df = pd.DataFrame(data)

# 过滤异常指标,并按部门计算平均年限与评分中位数
clean_df = df[df["kpi_score"].between(60, 100)]
summary = clean_df.groupby("dept_id").agg(
    avg_years=("work_years", "mean"),
    median_kpi=("kpi_score", "median")
).reset_index()

# 示例输出:展示分组汇总结果
print(summary)
二、Web 后端开发主流框架对比与选型
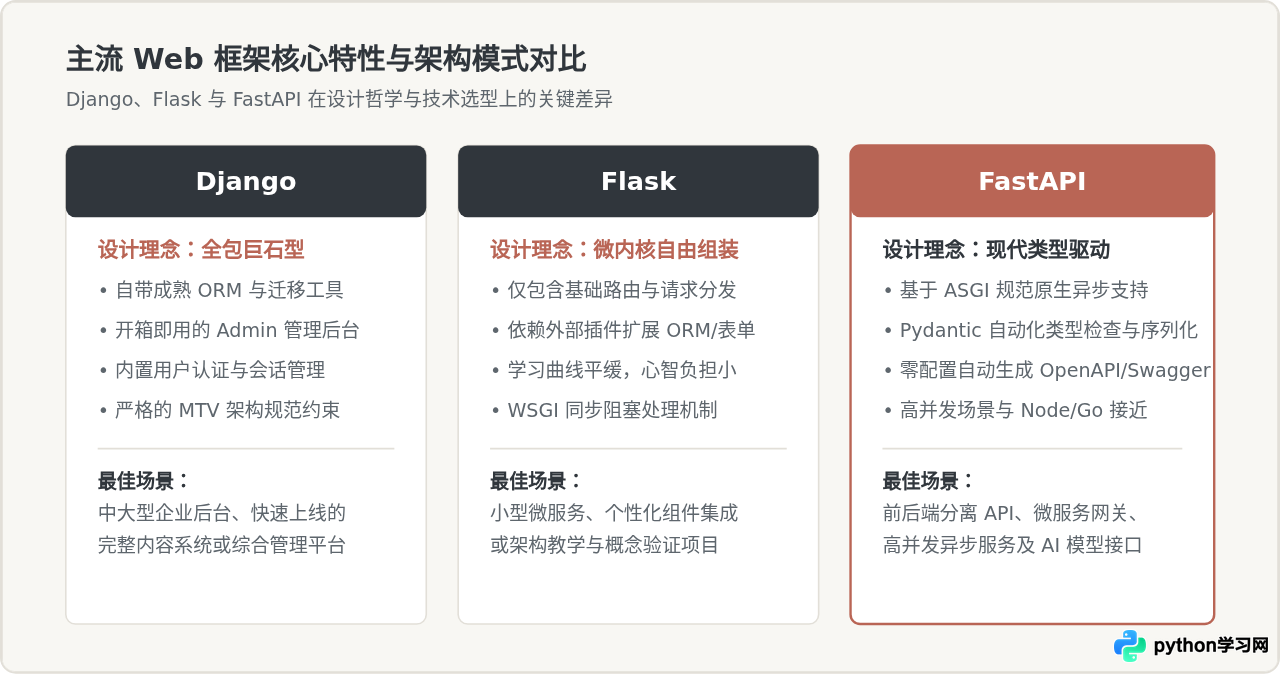
Python 在 Web 开发领域经历了两代协议演进:早期是以 WSGI(Web Server Gateway Interface)为核心的同步模型,近几年则全面普及了以 ASGI(Asynchronous Server Gateway Interface)为代表的异步高并发模型。当前最具实用价值的框架主要集中在 Django、Flask 与 FastAPI 三者之间。
1. Django:“开箱即用”的全栈巨石框架
Django 遵循“电池齐备(Batteries-Included)”理念,内置了完善的 ORM、管理员后台(Admin)、用户鉴权模块(Auth)、表单验证及 CSRF/XSS 安全防御机制。对于需要快速交付完整后台系统或中大型企业门户的场景,Django 能规避大量第三方拼装的时间与兼容性风险。
2. Flask:极简灵活的微框架代表
Flask 仅保留请求分发与路由上下文,其余诸如数据库访问、表单校验、权限系统均交由社区插件(如 Flask-SQLAlchemy、Flask-Login)决定。这种极简架构赋予了架构师极高的自由度,特别适用于架构简单的轻量应用或实验性原型系统。
3. FastAPI:现代高性能异步 API 框架
FastAPI 是近几年增长最迅猛的 Python 框架。它基于 Starlette(异步核心)与 Pydantic(数据校验),深度整合了 Python 3.6+ 的类型注解(Type Hints)。不仅能以 async/await 提供极佳的 I/O 吞吐量,还能在编写代码的同时自动生成符合 OpenAPI 标准的交互式 Swagger 文档。
下面是一个使用 FastAPI 实现的 RESTful 接口示例。注意其如何利用类型标注进行参数自动校验并支持异步处理:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="用户任务处理服务")

# 定义输入数据的契约模型
class TaskCreateRequest(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")

@app.post("/api/v1/tasks")
async def create_task(payload: TaskCreateRequest):
    # 异步业务逻辑处理(如写入数据库或消息队列)
    task_id = 1001
    return {
        "status": "success",
        "task_id": task_id,
        "title": payload.title,
        "priority": payload.priority
    }
三、自动化与任务编排核心库
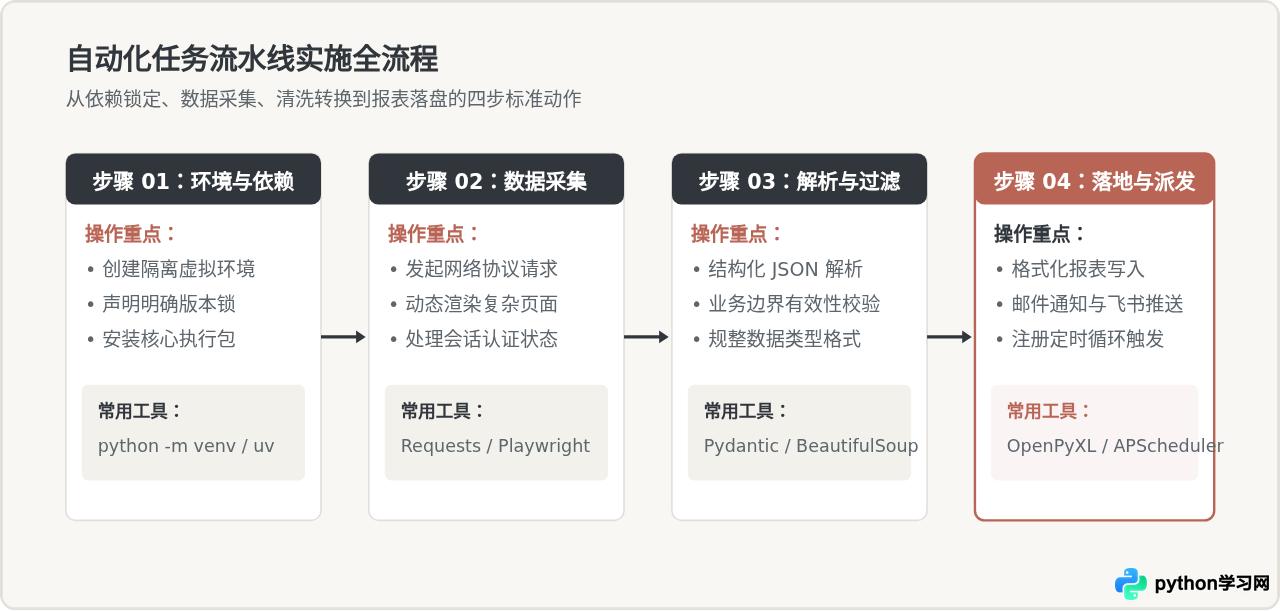
在系统管理、测试、办公协作与爬虫工程中,自动化工具的核心诉求在于“网络通信、网页渲染、文档落盘与任务计划”。以下是该领域最核心的四类组件:
1. Requests 与 httpx:网络请求与 API 调用标杆
Python 标准库自带的 urllib 接口繁冗。Requests 凭借人性化的 API 规范长久占据 Python 网络请求的龙头地位,封装了复杂的重定向、连接池(Connection Pool)复用、Cookie 持久化与证书验证机制。而在需要现代异步协程请求时,支持 HTTP/2 的 httpx 则成为了 Requests 的现代替代品。
2. Playwright:现代化无头浏览器自动化框架
过去的网页抓取与 UI 自动化多基于 Selenium,但其常受限于 WebDriver 驱动版本不匹配与等待机制不稳定等问题。微软推出的 Playwright 直接通过底层 CDP(Chrome DevTools Protocol)双向通信,原生支持自动等待(Auto-waiting)、跨浏览器(Chromium, Firefox, WebKit)、多页面隔离上下文与网络拦截,已成为现代前端测试与动态反爬页面抓取的首选工具。
3. OpenPyXL:Excel 数据自动化读写标准
在企业日常自动化中,Excel 报表输出是高频需求。OpenPyXL 专注于 .xlsx 格式的读写操作,既能读取几十万行的原始数据,又能精确设定单元格样式、公式函数、合并区域及字体格式,是自动化报表生成的核心依赖。
4. APScheduler:轻量级定时任务调度框架
如果任务仅需要定期在后台触发,引入庞大的 Celery + Redis 架构会带来过高的部署成本。APScheduler(Advanced Python Scheduler)是一个无需额外服务依赖的轻量调度器,支持类似 cron 的定时表达式、固定时间间隔及指定日期执行,可以直接嵌入任何现有的 Python 应用中运行。
以下示例展示如何利用 Requests 提取数据并直接通过 OpenPyXL 生成格式化的工作表:
import requests
from openpyxl import Workbook
from openpyxl.styles import Font, PatternFill

def fetch_and_export_status():
    # 1. 发起网络请求获取模拟服务健康指标
    # 注意:在生产环境请始终设定明确的 timeout 避免网络挂死
    url = "https://httpbin.org/json"
    response = requests.get(url, timeout=10)
    response.raise_for_status()
    payload = response.json()

    # 2. 创建并格式化 Excel 工作簿
    wb = Workbook()
    ws = wb.active
    ws.title = "自动巡检日志"

    # 写入表头并应用样式
    headers = ["键名", "取值详情"]
    ws.append(headers)

    header_font = Font(name="Arial", size=11, bold=True, color="FFFFFF")
    header_fill = PatternFill(start_color="30363C", end_color="30363C", fill_type="solid")
    for cell in ws[1]:
        cell.font = header_font
        cell.fill = header_fill

    # 3. 填充数据并保存
    slideshow = payload.get("slideshow", {})
    ws.append(["标题", slideshow.get("title", "")])
    ws.append(["作者", slideshow.get("author", "")])
    ws.append(["发布日期", slideshow.get("date", "")])

    output_filename = "daily_report.xlsx"
    wb.save(output_filename)
    print(f"数据已成功写入:{output_filename}")

if __name__ == "__main__":
    fetch_and_export_status()
四、依赖隔离与环境管理工程注意事项
引入第三方库意味着引入外部代码和潜在的传递依赖冲突。在工程落地时,以下几项规程至关重要:
- 必须使用虚拟环境隔离:切勿直接在全局 Python 环境下执行
pip install。请养成项目第一步即python3 -m venv .venv的习惯,并激活该环境,防止系统自带工具依赖被污染。 - 严防依赖漂移(Dependency Drift):仅在
requirements.txt中记录顶层包名容易导致子依赖在未来重新构建时安装不兼容版本。推荐使用带 Hash 锁定的工具(如 Poetry、uv 或 pip-tools)锁定具体构建依赖树。 - 权衡纯 Python 与 C 编译扩展包:像 NumPy、Pandas 等底层包含编译扩展的库,在构建 Docker 容器时尽量选用预编译的 Wheel 文件(使用
slim镜像而非极简的alpine镜像,避免耗费大量时间重新编译 C/C++ 源码)。
五、三大领域核心库决策与选型速查
不同项目规模与业务形态决定了工具库的最优搭配。下表汇总了各主要库的核心价值,并给出了明确的选用前提:
| 领域 | 推荐第三方库 | 核心能力与优势 | 选择依据与边界条件 |
|---|---|---|---|
| 数据与科学计算 | NumPy |
C 级内存布局、向量化运算、线性代数 | 涉及矩阵/多维张量计算时的必然基石 |
Pandas |
DataFrame 结构、多源 I/O、分组透视 | 单机内存足以容纳(<10GB)的结构化表格清洗与分析 | |
Matplotlib / Seaborn |
高定制静态绘图、统计图表模板 | 需要生成固定报表插图、论文图表或统计学趋势对比 | |
| Web 后端开发 | FastAPI |
异步 ASGI、Pydantic 类型校验、自动 OpenAPI | 前后端分离、微服务接口、高并发 I/O 密集型项目首选 |
Django |
全栈 Batteries-Included、内置 ORM 与 Admin | 需要快速构建企业后台管理、内容门户或要求规范统一的团队 | |
Flask |
轻量微内核、高度解耦、极高自由度 | 小型独立服务、现有系统嵌入式接口或架构概念验证 | |
| 自动化与脚本 | Requests / httpx |
极简 HTTP 客户端、会话管理、异步请求 | 任何需要与第三方 REST API 通信或抓取静态网页的场景 |
Playwright |
无头浏览器自动化、自动等待、反爬穿透 | 需要模拟真实用户操作、动态 JavaScript 页面渲染与测试 | |
OpenPyXL |
读取与写入 .xlsx 格式、单元格精细样式 | 自动化办公报表生成、指标结果交付给非技术部门 | |
APScheduler |
轻量进程内调度、Cron/间隔定时器 | 单进程自动化脚本需要在固定周期触发,无需复杂分布式队列 |
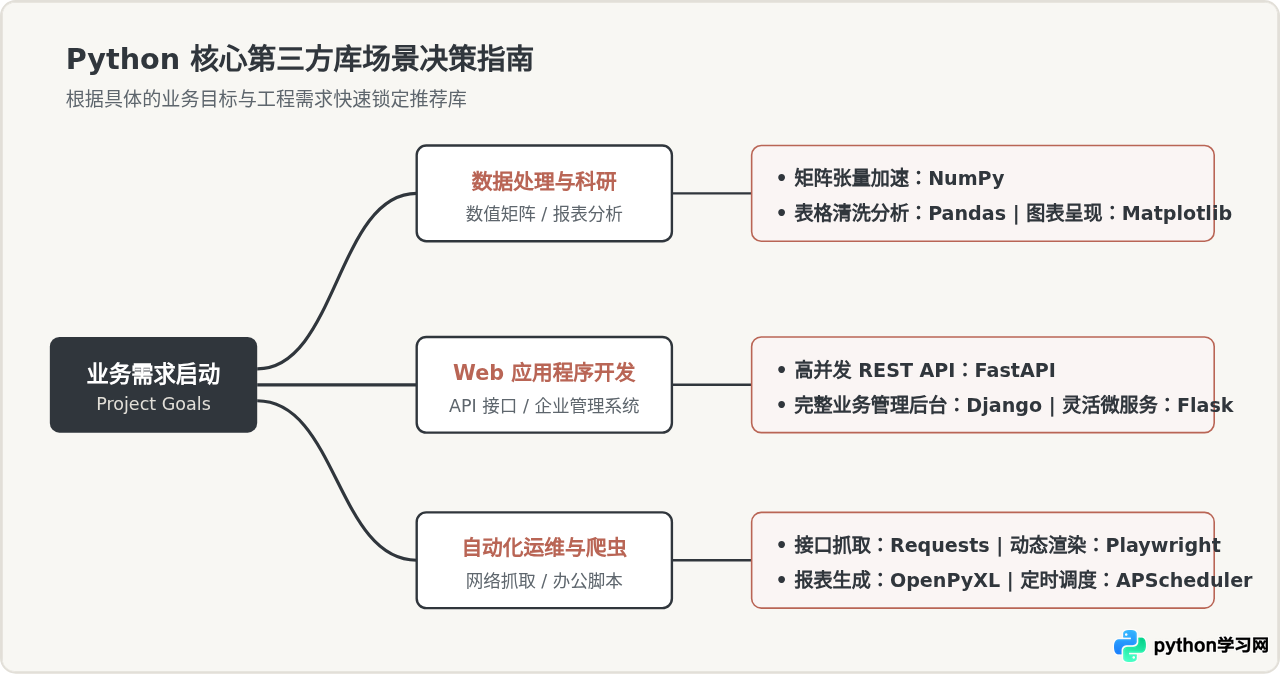
选择第三方库的核心原则不是“追逐最新”,而是“匹配场景与生态成熟度”。对于刚接触 Python 的开发者,先精通 NumPy + Pandas(数据域)、FastAPI(Web 域)与 Requests + Playwright(自动化域),就能覆盖日常工程开发中 80% 以上的需求。在实际开发中建立清晰的虚拟环境规范,将让你的 Python 生产系统保持持久的健壮与稳定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















