


Python常用框架有哪些?Web、数据与AI领域主流工具盘点
全面盘点Python在Web开发、数据科学与工程、人工智能三大领域的核心常用框架,包括Django、FastAPI、Flask、Pandas、Polars、PyTorch及Scikit-Learn的架构特性、核心代码示例与选型决策指南。
在当下的软件工程与算法研发中,Python凭借清晰的语法与庞大的开源生态,在众多技术领域占据主导地位。不同于从零编写底层逻辑,掌握对应领域的成熟框架是提升开发效率、保障系统稳健性的核心途径。本文面向需要技术选型与系统学习的开发者,集中盘点Python在Web开发、数据科学与工程以及人工智能三大主流领域的核心框架,解析其设计哲学、架构定位与适用场景,帮助读者建立系统清晰的技术版图。
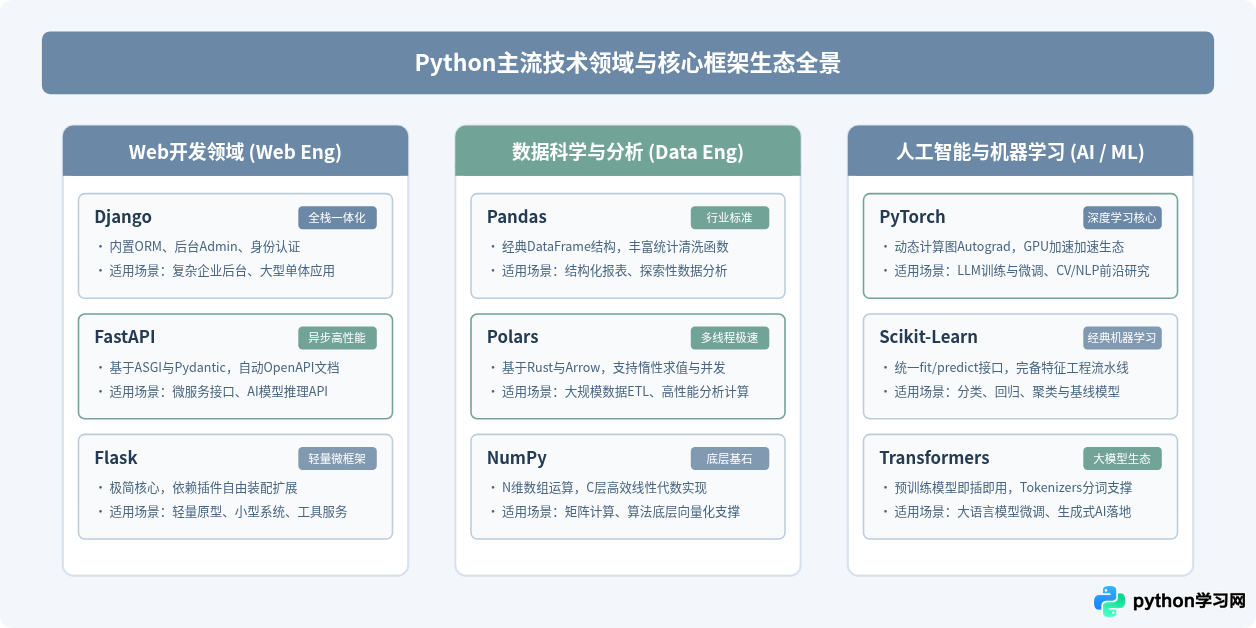
一、Web开发领域主流框架:Django、Flask与FastAPI
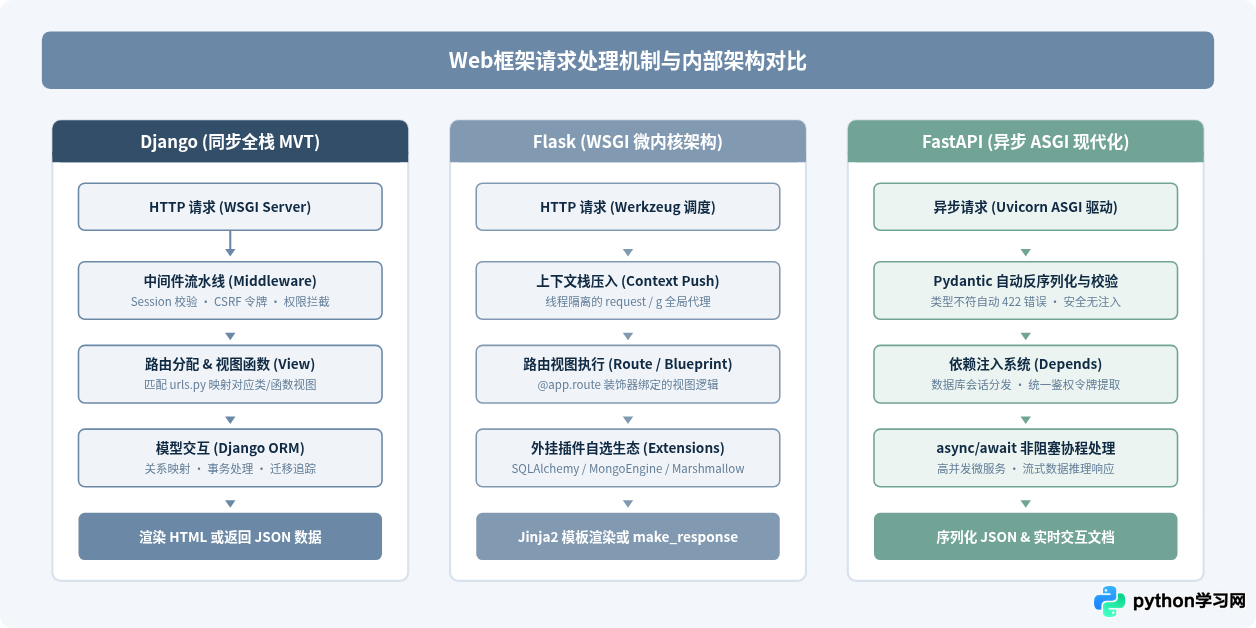
Python在Web服务端开发中拥有非常悠久的历史,逐步演进出了三种截然不同的设计流派:以Django为代表的“电池全包(Batteries-Included)”全栈方案、以Flask为代表的微内核极简主义,以及以FastAPI为代表的新一代现代异步API框架。
1. Django:成熟完备的企业级全栈解决方案
Django诞生于新闻出版业务系统,其核心哲学是“开箱即用”。开发者无需为数据库交互、权限验证、管理后台等基础组件选型,框架内置了经过严格生产检验的一整套体系。
- 内置功能齐备:自带强大的关系型数据库ORM(对象关系映射)、用户认证系统(Auth)、防CSRF/XSS的安全机制以及自动化生成的数据后台(Admin)。
- 开发规范性强:遵循明确的MVT(Model-View-Template)架构,项目代码结构高度统一,适合多人协作与长期维护。
- 适用场景:适合内容管理系统(CMS)、电商平台、企业内部管理后台以及业务逻辑紧密依赖关系型数据库的中大型单体系统。
2. Flask:灵活轻巧的微框架
Flask遵循微内核理念,核心仅保留路由系统(基于Werkzeug)和模板引擎(Jinja2)。其余如数据库连接、表单校验、缓存等功能全部以扩展插件(如Flask-SQLAlchemy、Flask-Migrate)的形式按需引入。
- 极低上手门槛:单文件即可跑起一个完整的Web服务,结构自由度极高。
- 选型自主权:开发者可以自由选用任何非关系型或异步数据库驱动,不受原生约定约束。
- 适用场景:小型工具系统、功能明确的原型开发,或是需要定制非常规技术栈的服务模块。
3. FastAPI:面向现代API与异步微服务的高性能首选
伴随Python 3.6+类型注解(Type Hints)与异步IO(async/await)的普及,FastAPI迅速成为近年来关注度最高的Web框架之一。它基于Starlette构建底层ASGI服务,并深度集成Pydantic处理数据验证。
- 原生类型驱动与自动验证:通过Python原生类型注解声明请求体与查询参数,框架自动完成严格的数据类型转换与错误提示。
- 自动交互式文档:启动服务即自动生成基于OpenAPI规范的Swagger UI与ReDoc交互式接口文档,免去前后端手动同步接口协议的成本。
- 优异并发表现:基于异步事件循环,对于IO密集型任务(如频繁调用第三方HTTP接口、向量数据库查询、等待大模型生成响应)具有显著的吞吐优势。
- 适用场景:移动应用API网关、微服务集群、人工智能大模型推理与流式响应接口。
下面的示例演示了使用FastAPI构建一个带有类型校验与自动文档的预测接口所需的最简代码:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="推理服务API", version="1.0.0")

class PredictRequest(BaseModel):
    feature_vector: list[float] = Field(..., min_length=1, description="特征浮点数列表")
    threshold: float = Field(0.5, ge=0.0, le=1.0, description="置信度阈值")

class PredictResponse(BaseModel):
    is_positive: bool
    confidence: float

@app.post("/predict", response_model=PredictResponse)
async def predict_endpoint(payload: PredictRequest):
    # 模拟异步处理计算
    score = sum(payload.feature_vector) / len(payload.feature_vector)
    return PredictResponse(
        is_positive=(score >= payload.threshold),
        confidence=round(score, 4)
    )
二、数据科学与工程核心框架:NumPy、Pandas与Polars
在数据分析与数据清洗场景中,Python本身由于GIL(全局解释器锁)与动态类型开销,直接使用原生列表和循环处理海量数据效率较低。数据处理框架通过引入C/C++/Rust编写的底层数据结构,实现了数倍至数百倍的性能跃迁。
1. NumPy:科学计算与多维数组的基础底座
NumPy的核心是ndarray(N-dimensional array object)。它要求数组内元素数据类型完全一致,并在内存中连续存放。几乎所有的上层数据框架(Pandas、Scikit-Learn、PyTorch)都以NumPy的向量化计算思想为蓝本。
- 广播机制(Broadcasting):允许对不同形状但兼容的数组直接进行算术运算,无需手动编写嵌套循环。
- 内存布局与切片视图:切片操作默认不拷贝内存,极大节省了大型矩阵计算时的开销。
2. Pandas:结构化表格数据分析的事实标准
Pandas将二维表格抽象为DataFrame,一维数据抽象为Series。它拥有最为全面的数据接入(CSV、Excel、SQL、Parquet、JSON等)和分析函数库,是日常业务分析和探索性数据分析(EDA)不可或缺的工具。
- 优势:数据对齐、缺失值填充、分组聚合(GroupBy)、透视表(Pivot Table)及时间序列处理API极度丰富,生态兼容度极高。
- 限制:Pandas底层严重依赖单线程计算,且操作过程中往往会产生多个数据副本,当数据量逼近或超过物理内存时极易发生内存溢出(OOM)。
3. Polars:新一代多线程与惰性求值数据引擎
针对传统Pandas在处理千万级数据时速度慢、易OOM的痛点,Polars应运而生。它完全基于Rust语言开发,底层采用Apache Arrow列式内存格式。
- 天然多线程并发:无需手动配置,充分榨干现代多核CPU的全部算力。
- 惰性执行(Lazy API)与查询优化器:支持编写执行计划,引擎在真正计算前会自动进行谓词下推(Predicate Pushdown)、投影下推(Projection Pushdown)及公共表达式消除,大幅减少无用IO与内存占用。
- 无内存拷贝:基于Arrow标准的零拷贝特性,与前后端数据传输极为契合。
三、人工智能与机器学习核心框架:Scikit-Learn与PyTorch
Python在AI领域的垄断地位建立在其从传统统计学习到现代大模型深度学习的无缝工具衔接上。
1. Scikit-Learn:传统机器学习与特征工程的黄金标准
Scikit-Learn(简称sklearn)规范了现代机器学习的通用工程范式。其最大的贡献是确立了极其优雅且一致的面向对象API:
Estimator类负责学习:通过fit(X, y)拟合模型参数。Transformer类负责数据预处理:通过fit_transform(X)完成标准化、独热编码(One-Hot)或缺失填充。Pipeline将特征处理与最终模型严格串联,防止训练集与测试集之间发生严重的数据泄露(Data Leakage)。
2. PyTorch:学术研究与工业落地的主导深度学习框架
相较于早期TensorFlow采用的静态计算图,PyTorch凭借“即刻执行(Eager Execution)”与动态计算图(Autograd)机制,彻底改变了深度学习研发体验。开发者可以像调试普通Python代码一样使用断点排查张量形状与梯度流向。
- 核心组件:
torch.Tensor(支持GPU/NPU显存加速加速)、torch.nn.Module(网络层搭建基类)、torch.optim(反向传播优化器)。 - 大模型基石:当前主流的开源大型语言模型(LLaMA、Qwen、DeepSeek等)及其分布式训练套件(DeepSpeed、Megatron-LM)以及HuggingFace Transformers均首要基于PyTorch深度优化。
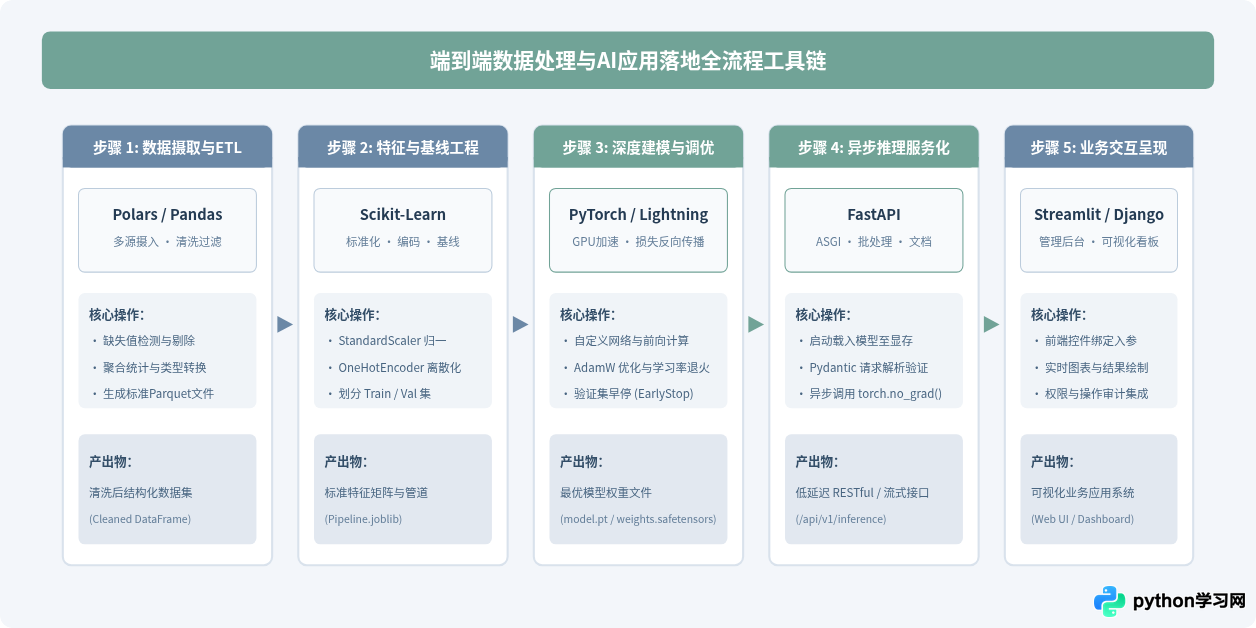
四、实战流水线:从原始数据到AI服务化落地的端到端协同
在真实的工程项目中,上述各个框架并非孤立存在,而是遵循“数据清洗 → 建模训练 → 接口封装 → 前端交付”的链条协同工作。
五、综合选型决策:如何选择最适合项目的Python框架?
在面对具体的业务需求时,切忌盲目追求最新技术或追求“大而全”。以下根据团队规模、性能指标与业务特征提供明确的选型决策参考:
| 所属领域 | 代表框架 | 学习曲线 | 最大优势 | 主要权衡与妥协 | 首选推荐场景 |
|---|---|---|---|---|---|
| Web开发 | Django | 中等偏高 | 内置组件极其完备,安全防范全面,管理后台无需手写 | 体系庞大,ORM与视图耦合深,难以做极低延迟定制 | 面向多角色权限的后台管理系统、企业内部门户、规范单体项目 |
| Flask | 平缓 | 微内核零侵入,设计自由度极高,适合定制与小脚本服务 | 中大型系统需要自行拼装组件,缺乏官方统一项目架构约束 | 简单原型演练、小工具链封装、内部轻量数据展示 | |
| FastAPI | 平缓(需懂类型提示) | 异步高吞吐,强类型Pydantic验证,自动同步OpenAPI文档 | 需理解异步机制(Event Loop),ORM需配合SQLAlchemy 2.0等异步驱动 | 移动端后端API、微服务集群、AI/大模型流式推理接口服务 | |
| 数据科学 | Pandas | 平缓 | 函数极其丰富,几乎所有第三方库均提供原生互通接口 | 单线程运行,内存消耗为原始文件2-5倍,易出现OOM | 探索性数据分析(EDA)、中小型表格统计清洗、教学研读 |
| Polars | 中等 | 多核并发极致提速,惰性执行优化物理计划,内存极其克制 | API与Pandas存在部分语法差异,复杂生僻统计函数需编写扩展 | 生产级大数据ETL清洗、对响应耗时敏感的高频离线分析流水线 | |
| 人工智能 | Scikit-Learn | 平缓 | API高度统一,特征处理Pipeline严谨规范,统计学理论完备 | 不支持GPU算力加速,无法处理复杂的非结构化图像/文本深度网络 | 表格数据分类预测、风控评分卡、特征工程基线、传统聚类分析 |
| PyTorch | 中等偏高 | 动态计算图调试直观,GPU生态极其完善,顶会论文与开源代码首选 | 需深入理解张量维度变换、显存管理与模型部署优化技术 | 计算机视觉(CV)、自然语言处理(NLP)、大语言模型训练与微调 |
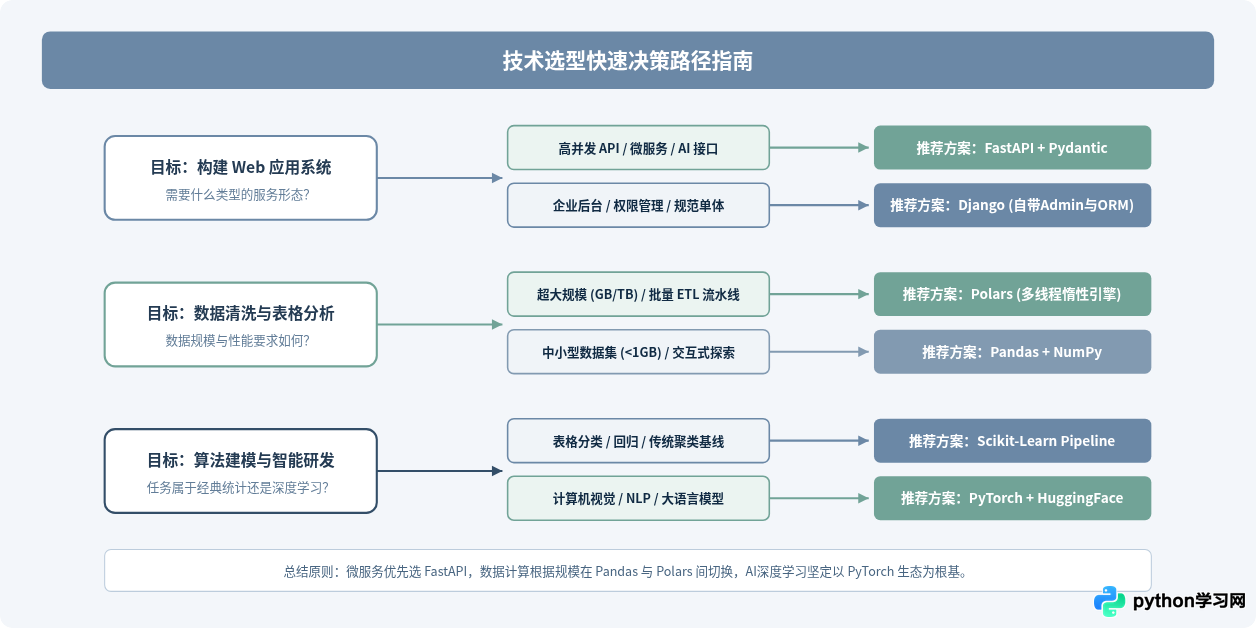
总结
综上所述,Python的强大并不源于单一框架的万能,而在于其各个领域高度细分且能够互联互通的工具网络:
- 对于需要快速交付、内置完整鉴权与Admin后台的单体项目,Django依然是生产力标杆;而现代微服务与高性能推理接口首选FastAPI。
- 对于日常数据处理与小体量表格分析,Pandas依然不可或缺;而面对大规模批处理清洗与极致性能要求,Polars正成为新一代生产利器。
- 对于统计学习与基线模型构建,Scikit-Learn提供了行业标准范式;而对于非结构化数据与大模型研发,PyTorch则是不可动摇的底座。
理解各个框架的设计哲学、优势边界与数据交换协议,能够帮助开发者在面对复杂的业务场景时迅速制定出最合理的技术方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















