Python读取CSV某一行出现乱码怎么办
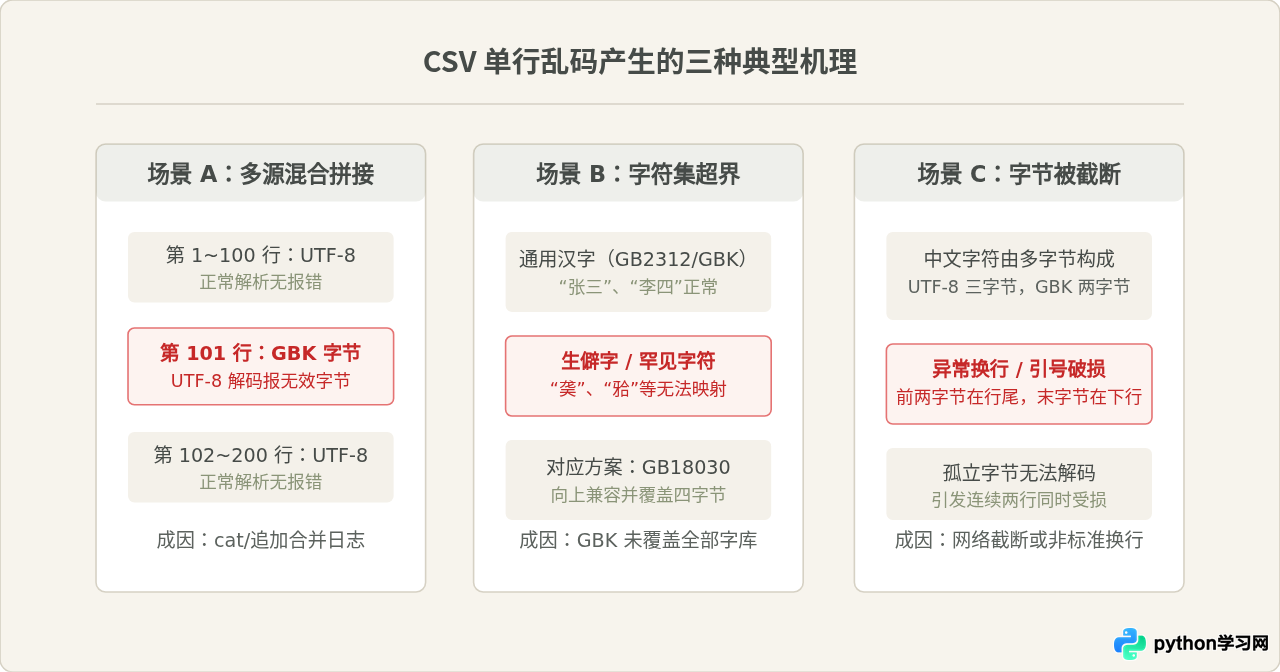
详细分析Python读取CSV文件时单行出现乱码或报错的具体成因,提供二进制定位、编码试探、容错处理及批量清洗的实用方法与代码示例。
10-21
12




本文详细解析 Python 2 中处理中文编码的常见陷阱与解决方案。涵盖如何正确设置文件编码声明、理解 str 与 unicode 的区别,以及在 Windows 环境下处理 ANSI 和 UTF-8 文件时的编码转换技巧。重点讲解了 BOM 头处理、print 输出机制及跨平台编码兼容性问题,帮助开发者避免中文乱码错误。
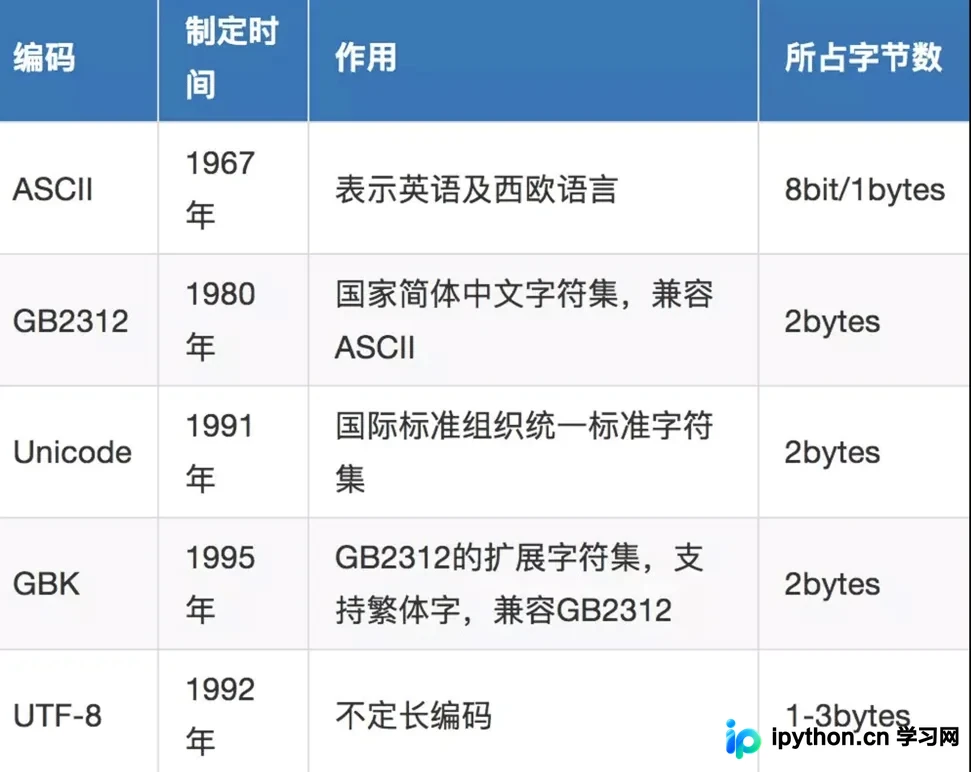
本文详细解析Python中常见的四种编码格式:ASCII、Unicode、UTF-8及GBK。从Python2默认ASCII到Python3默认UTF-8的演变出发,阐述各编码的字节占用、适用范围及存储效率差异,帮助开发者理解字符编码原理并解决乱码问题。
在 PHP 中对包含中文字符串的数组进行默认排序时,UTF-8 编码下的 asort 往往无法实现按拼音排序。这是因为 GBK 等内码集天然支持拼音序,而 UTF-8 是 Unicode 编码。解决思路是通过 iconv 函数将 UTF-8 临时转换为 GBK 或 GB2312 进行排序,最后再转回 UTF-8。本文将详细介绍处理非法字符风险的修正方法及完整代码实现。
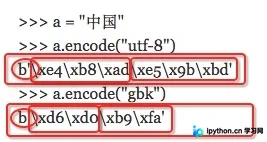
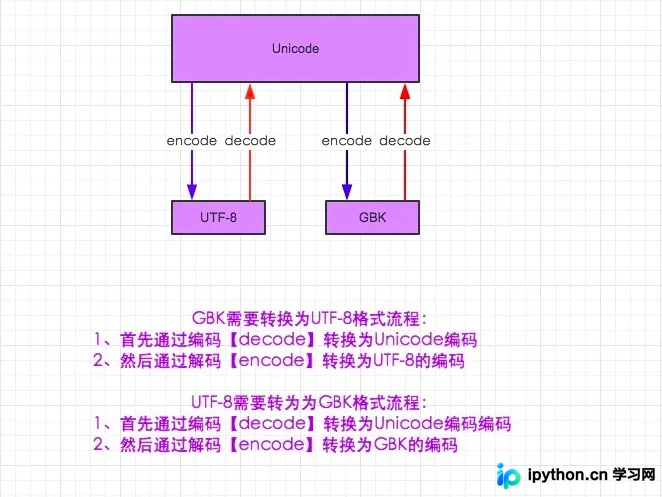
本文详解Python3中str与bytes的编码转换机制。Python3默认使用Unicode,需通过encode方法转换为UTF-8或GBK等字节格式以用于存储传输。文章对比了UTF-8(通常24位)与GBK(通常16位)的位数差异,并提供Python交互环境下的具体代码示例,帮助开发者解决中文字符编码问题。
本文介绍了一种Python自定义编码识别方法,旨在解决chardet工具在特定场景(如Windows记事本保存的GBK文件被误识为KOI8-R)下的局限性。通过遍历UTF-8、UTF-16、GB18030等编码并尝试解码,实现了对文件及字符串编码类型的准确判断,提供了完整的代码示例与使用说明。
本文详细解析Python中字符编码转换的原理与操作。重点对比Python 2与Python 3在字符串处理上的差异,通过具体代码示例演示GBK与UTF-8编码的互转过程。文章涵盖encode与decode的使用场景,以及不同版本中字符串类型的变化,帮助开发者解决乱码问题。
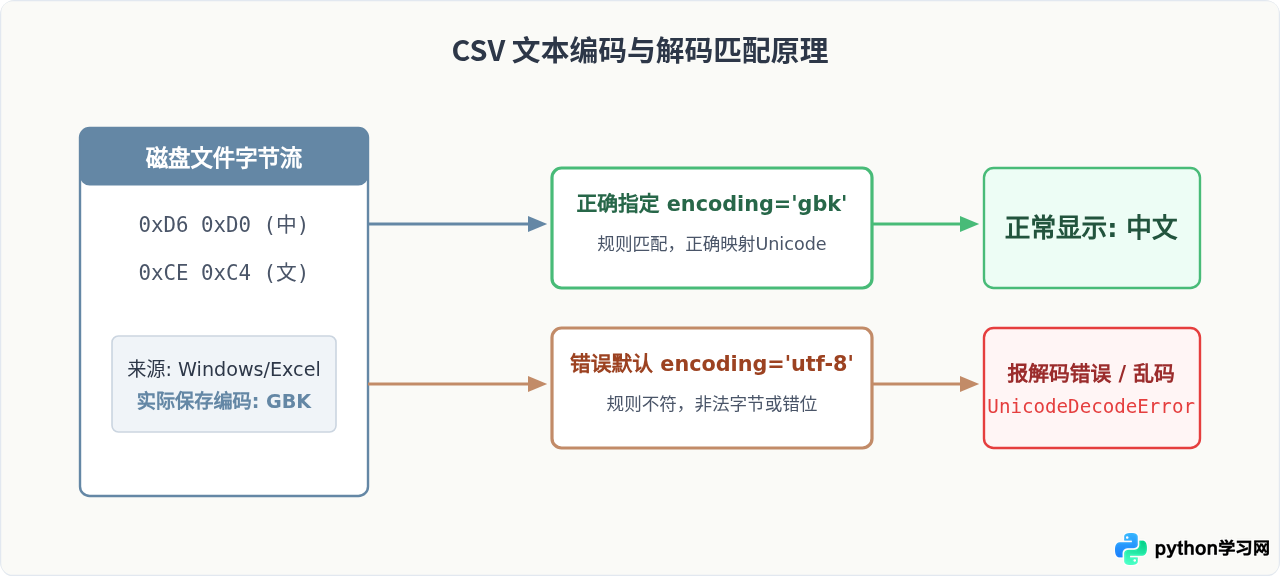
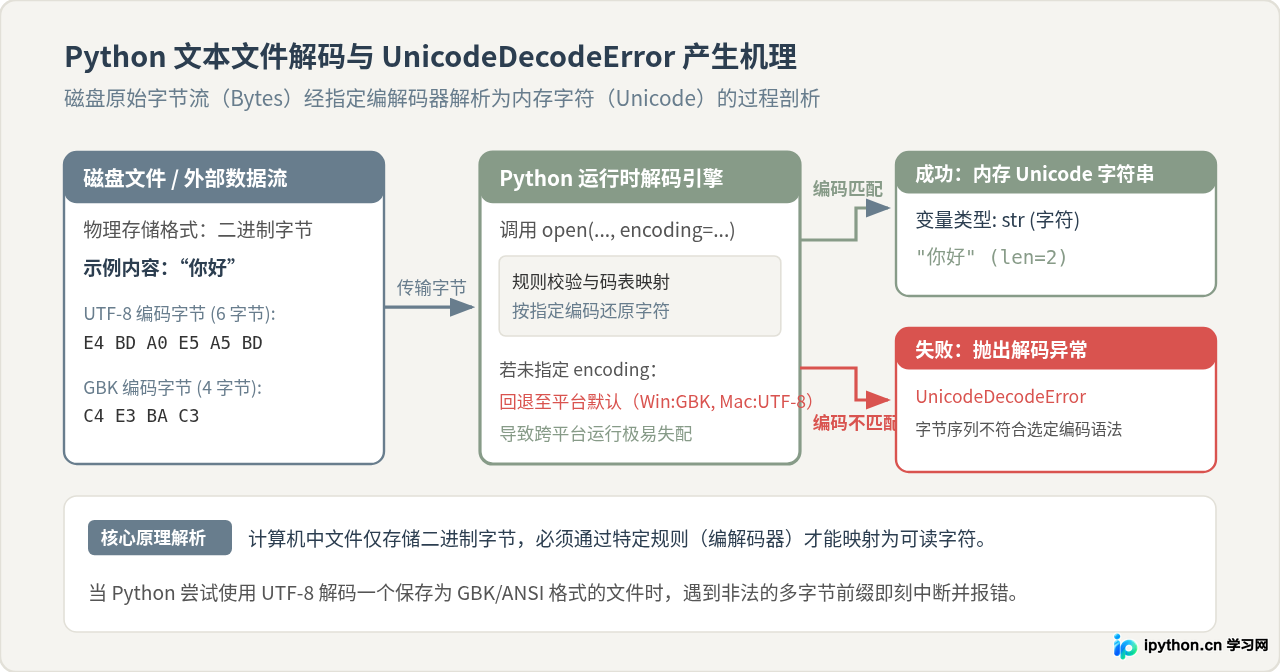
针对运行Python脚本时出现的UnicodeDecodeError编码错误,系统梳理报错原因、排查路径、修复方案及预防规范,帮助开发者彻底解决文本文件读写与终端输出中的字符解码异常。
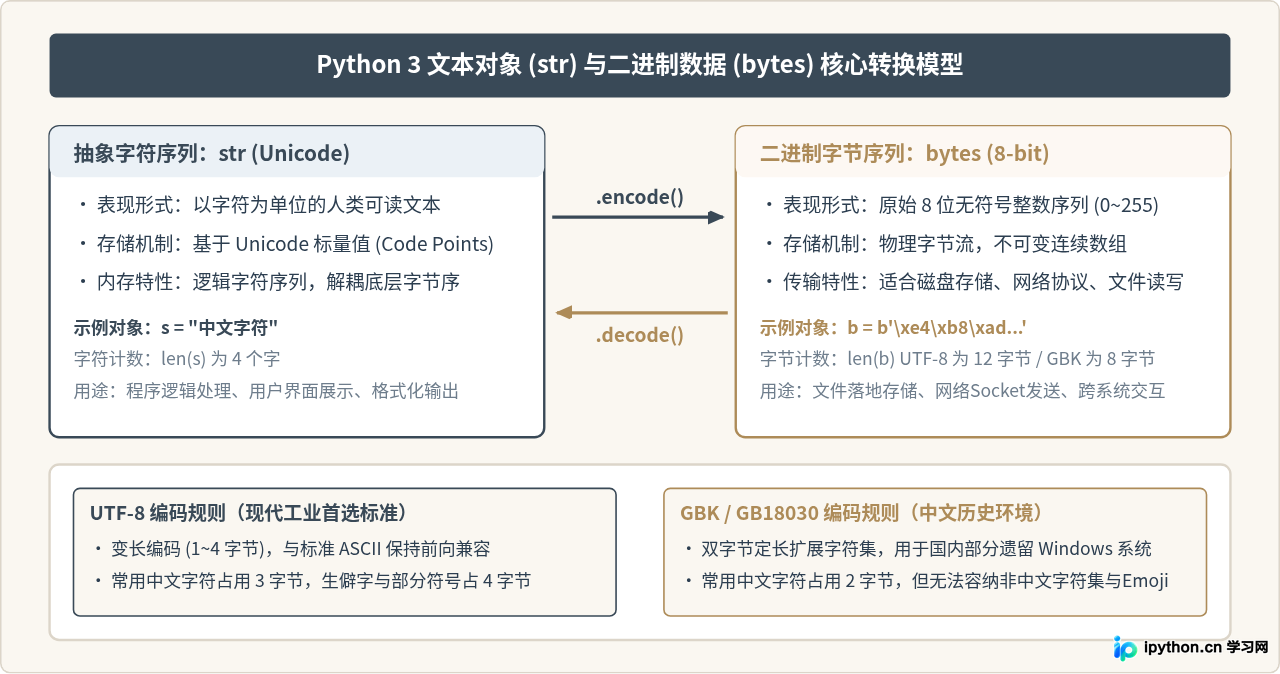
详细讲解Python 3中str与bytes的相互转换方法,剖析encode()与decode()在处理中文字符时的机制、UTF-8与GBK编码规则、错误处理策略及常见乱码报错排查。
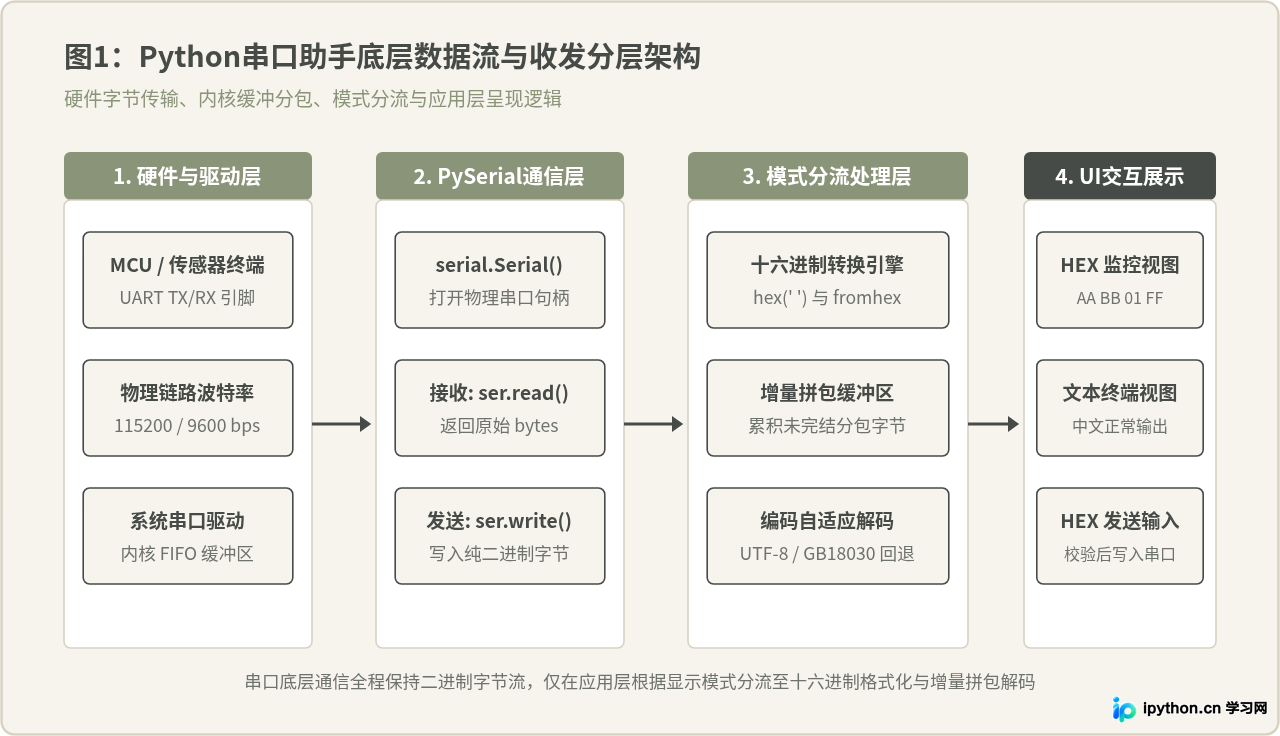
深入解析Python串口助手源码中十六进制收发的实现细节与串口乱码的根源,提供健壮的HEX数据清洗、字节流分包拼接与字符集安全解码实用技巧。