


Python标准库itertools与functools常用工具函数详解

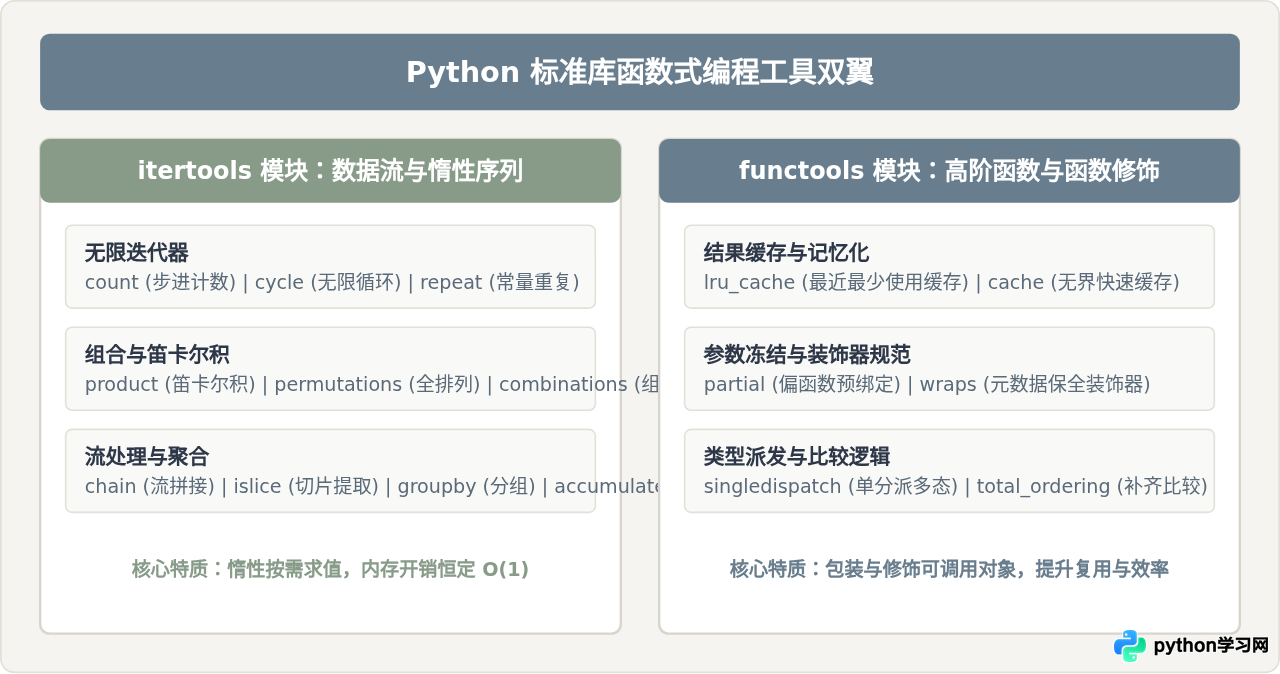
在 Python 标准库中,itertools 与 functools 是构建高效、函数式编程风格代码的两个基石模块。itertools 专注于为迭代器提供高效、内存友好的惰性序列生成与组合工具;functools 则专注于对可调用对象进行高阶封装、参数绑定、缓存优化与泛型派发。本文梳理这两个标准库模块的核心常用函数,通过工作原理、可执行示例与应用场景对比,帮助开发者在实际工程中写出更简洁、高性能的代码。
一、itertools 常用工具函数详解
itertools 提供的所有工具函数都返回迭代器对象。它们不会一次性将所有元素加载至内存,而是在每次调用 next() 时按需生成下一个元素,非常适合处理大规模数据流、无限序列和复杂排列组合。
1. 无限迭代器:count、cycle 与 repeat
无限迭代器会持续生成元素,通常需要与 islice、break 或条件截断配合使用,避免导致程序死循环。
count(start=0, step=1):从指定初始值start开始,每次递增step,生成无限数值序列。cycle(iterable):将有限序列的所有元素保存后无限循环输出。repeat(object[, times]):不断生成指定对象;如果指定了times,则在生成固定次数后终止。
import itertools

# 1. count:生成偶数序列,配合 break 停止
for n in itertools.count(start=10, step=2):
    if n > 16:
        break
    print(n, end=" ")
# 示例输出:10 12 14 16

# 2. cycle:轮流分配任务
workers = itertools.cycle(["Worker-A", "Worker-B", "Worker-C"])
tasks = ["Task 1", "Task 2", "Task 3", "Task 4"]
for task in tasks:
    print(f"{task} -> {next(workers)}")
# 示例输出:
# Task 1 -> Worker-A
# Task 2 -> Worker-B
# Task 3 -> Worker-C
# Task 4 -> Worker-A

# 3. repeat:提供固定的常量参数供 map 使用
list(map(pow, range(4), itertools.repeat(2)))
# 示例输出:[0, 1, 4, 9]
2. 切片与连接:islice 与 chain
常规切片操作(如 lst[start:stop])要求目标对象支持索引访问,并且通常会创建新的列表切片副本。对于生成器或大型文件句柄,常规切片无法使用,此时必须使用 itertools.islice。
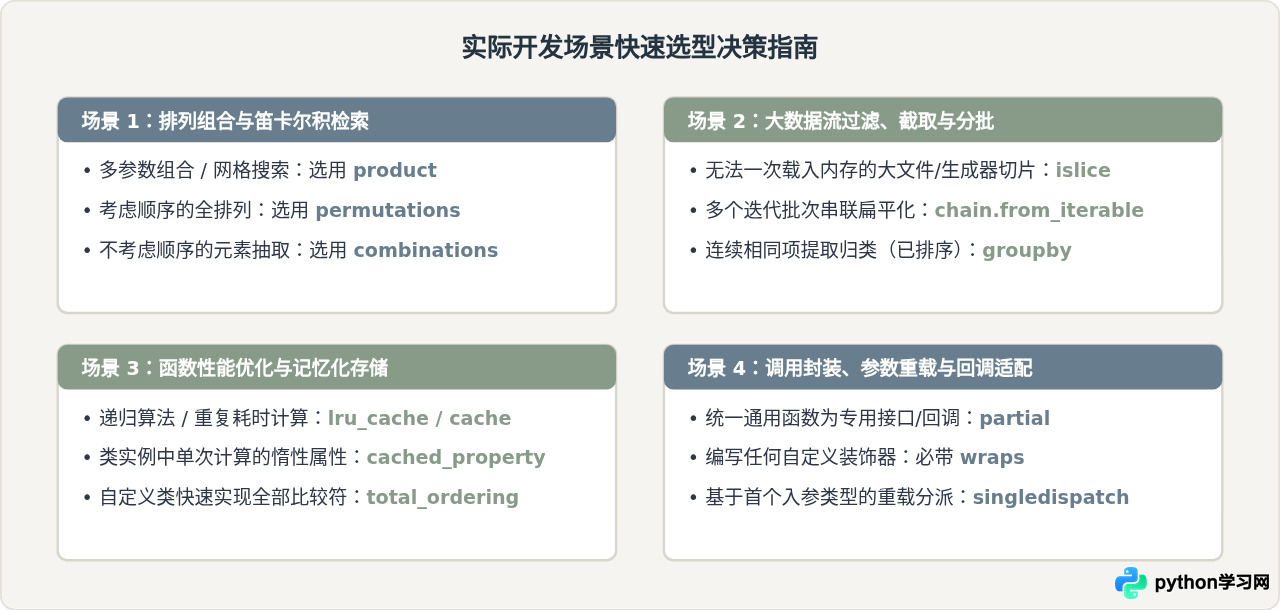
islice(iterable, stop)或islice(iterable, start, stop[, step]):按索引范围对任意迭代器进行切片提取,返回新的迭代器。chain(*iterables):将多个独立的可迭代对象串联成一个单一数据流。如果输入本身就是可迭代对象的列表或生成器,可使用chain.from_iterable(iterable)进行扁平化操作。
import itertools

# islice:获取无限序列中的前5个偶数
even_gen = itertools.count(0, 2)
first_five = list(itertools.islice(even_gen, 5))
print("first_five:", first_five)
# 示例输出:first_five: [0, 2, 4, 6, 8]

# chain:扁平化嵌套批次
batch_1 = [101, 102]
batch_2 = [201, 202, 203]
all_ids = list(itertools.chain(batch_1, batch_2))
print("all_ids:", all_ids)
# 示例输出:all_ids: [101, 102, 201, 202, 203]

# chain.from_iterable:扁平化二维数组
matrix = [[1, 2], [3, 4], [5, 6]]
flattened = list(itertools.chain.from_iterable(matrix))
print("flattened:", flattened)
# 示例输出:flattened: [1, 2, 3, 4, 5, 6]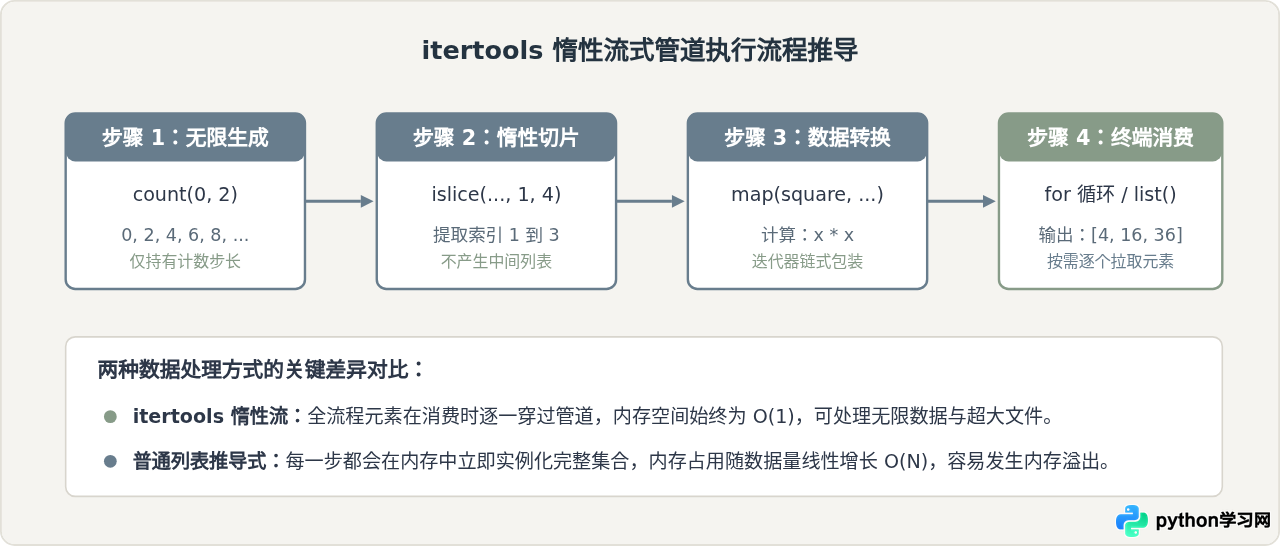
3. 分组与聚合:groupby 与 accumulate
groupby 用于对连续相同的键值进行归类分组,accumulate 则用于计算累计和或自定义二元累计运算。
groupby(iterable, key=None):将迭代器中相邻且键相同的元素分组。注意:必须先按照目标 key 对数据进行排序,否则相同 key 但不相邻的项会被归为不同的组。accumulate(iterable[, func, *, initial=None]):返回累积迭代结果。默认func为加法(计算前缀和),也可以传入min、max、operator.mul等自定义运算。
import itertools
import operator

# 1. groupby:对日志或列表按类型归类
raw_logs = [
    {"level": "INFO", "msg": "Server started"},
    {"level": "INFO", "msg": "Listening on port 80"},
    {"level": "WARN", "msg": "High CPU usage"},
    {"level": "INFO", "msg": "Request received"}
]

# 错误示范:未经排序直接 groupby 会导致同一个 "INFO" 分成两组
# 正确做法:先按键排序
sorted_logs = sorted(raw_logs, key=lambda x: x["level"])
for level, group in itertools.groupby(sorted_logs, key=lambda x: x["level"]):
    print(f"[{level}] 包含 {len(list(group))} 条记录")
# 示例输出:
# [INFO] 包含 3 条记录
# [WARN] 包含 1 条记录

# 2. accumulate:计算资产累计值与最大回撤基准
nums = [10, 5, 20, 8, 30]
running_max = list(itertools.accumulate(nums, max))
print("running_max:", running_max)
# 示例输出:running_max: [10, 10, 20, 20, 30]

cumulative_prod = list(itertools.accumulate([1, 2, 3, 4], operator.mul))
print("cumulative_prod:", cumulative_prod)
# 示例输出:cumulative_prod: [1, 2, 6, 24]
4. 组合数学:product、permutations 与 combinations
在算法求解与多参数遍历时,手动编写多重嵌套 for 循环不仅冗长,而且循环层数固定。itertools 提供了高效的 C 语言底层组合算子:
product(*iterables, repeat=1):计算笛卡尔积。替代多层嵌套循环。permutations(iterable, r=None):全排列。考虑元素顺序,元素不可重复选取。combinations(iterable, r):组合。不考虑元素顺序,元素不可重复选取。combinations_with_replacement(iterable, r):允许单个元素重复选取的组合。
import itertools

# 1. product:替代双重/三重嵌套循环
colors = ["red", "blue"]
sizes = ["S", "M"]
skus = list(itertools.product(colors, sizes))
print("skus:", skus)
# 示例输出:skus: [('red', 'S'), ('red', 'M'), ('blue', 'S'), ('blue', 'M')]

# 2. permutations:考虑顺序的两人排队方案
items = ['A', 'B', 'C']
perms = list(itertools.permutations(items, 2))
print("perms (3选2排列):", perms)
# 示例输出:[('A', 'B'), ('A', 'C'), ('B', 'A'), ('B', 'C'), ('C', 'A'), ('C', 'B')]

# 3. combinations:不考虑顺序的两人组合方案
combs = list(itertools.combinations(items, 2))
print("combs (3选2组合):", combs)
# 示例输出:[('A', 'B'), ('A', 'C'), ('B', 'C')]
二、functools 常用工具函数详解
functools 模块提供了高阶函数支持,即接受函数作为参数或返回新函数的函数。它能帮助我们优化函数执行效率、固定默认参数、保留修饰器元信息并实现多态派发。
1. 函数结果缓存:lru_cache 与 cache
在递归算法、耗时数据计算或高频配置查询中,如果函数是纯函数(相同输入总会得到相同输出),使用结果记忆化能够将指数级时间复杂度直接降至线性。
@lru_cache(maxsize=128, typed=False):基于 LRU(Least Recently Used,最近最少使用)淘汰策略的函数缓存修饰器。当缓存达到maxsize时,最久未被访问的键值将被清理。设置maxsize=None时缓存容量无上限。@cache:Python 3.9+ 引入的快捷简写,等同于@lru_cache(maxsize=None),实现无限容量缓存。
import functools
import time

# 斐波那契数列计算:未加缓存时为 O(2^n),加上缓存后降为 O(n)
@functools.lru_cache(maxsize=256)
def fibonacci(n: int) -> int:
    if n < 2:
        return n
    return fibonacci(n - 1) + fibonacci(n - 2)

print("fibonacci(30):", fibonacci(30))
# 示例输出:fibonacci(30): 832040

# 查看缓存命中情况与清理
info = fibonacci.cache_info()
print("缓存统计:", info)
# 示例输出:缓存统计: CacheInfo(hits=28, misses=31, maxsize=256, currsize=31)

# 手动清理缓存
fibonacci.cache_clear()lru_cache 内部使用字典存储参数键。因此,被修饰函数的所有入参必须是 可哈希对象(hashable)。如果向其传入 list、dict 或 set,程序将在运行时抛出 TypeError: unhashable type 异常。对于可变对象入参,应先将其转换为 tuple 或 frozenset。
2. 偏函数预绑定:partial 与 partialmethod
functools.partial 用于固定可调用对象的某些位置参数或关键字参数,返回一个新的可调用对象。它在接口统一、事件回调设置以及多进程函数调用中非常实用。
import functools

def base_converter(number_str: str, base: int) -> int:
    return int(number_str, base=base)

# 使用 partial 冻结 base 参数,派生专用工具函数
from_binary = functools.partial(base_converter, base=2)
from_hex = functools.partial(base_converter, base=16)

print("二进制转换:", from_binary("1010"))
# 示例输出:二进制转换: 10
print("十六进制转换:", from_hex("1F"))
# 示例输出:十六进制转换: 31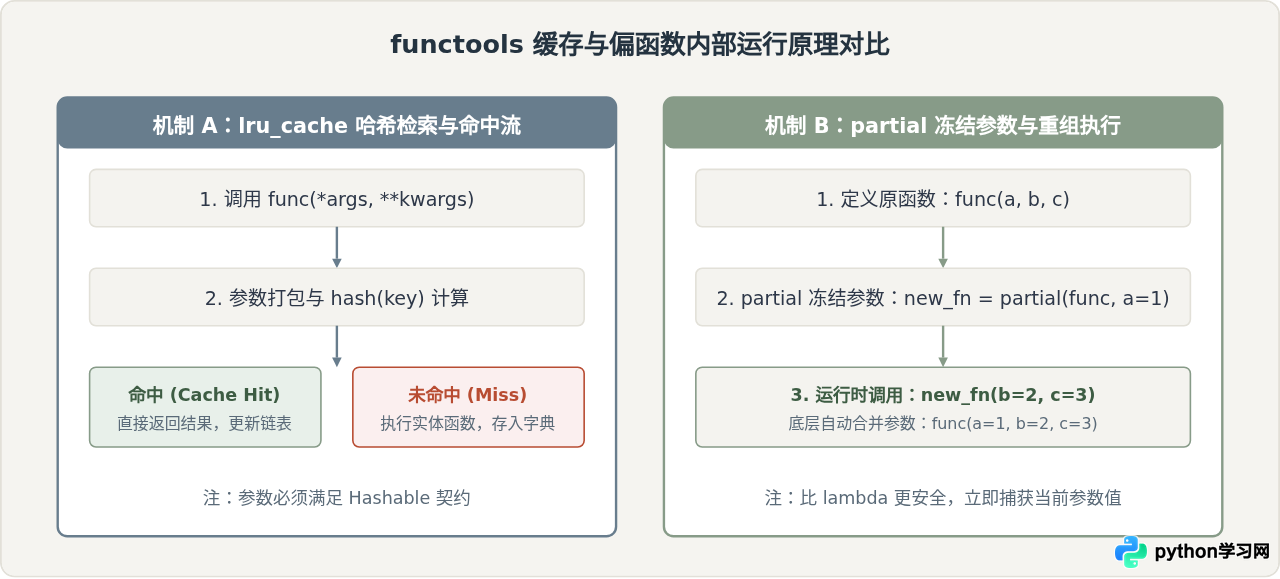
3. 保全元信息的装饰器辅助:wraps
当编写自定义装饰器时,如果不做特殊处理,被装饰后的原函数其 __name__、__doc__ 以及类型注解都会被内层闭包覆盖,这会导致调试困难、文档生成工具失效。@functools.wraps 能够将原函数的元数据自动拷贝到闭包函数上。
import functools
import time

def timer(func):
    @functools.wraps(func)  # 保留 func 的 __name__, __doc__, __annotations__
    def wrapper(*args, **kwargs):
        """计时器包装闭包"""
        start = time.perf_counter()
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start
        print(f"[{func.__name__}] 耗时: {duration:.4f}秒")
        return result
    return wrapper

@timer
def calculate_sum(n: int) -> int:
    """计算 0 到 n 的整数和"""
    return sum(range(n))

print("函数名称:", calculate_sum.__name__)
print("文档说明:", calculate_sum.__doc__)
calculate_sum(1000000)
# 示例输出:
# 函数名称: calculate_sum
# 文档说明: 计算 0 到 n 的整数和
# [calculate_sum] 耗时: 0.0215秒
4. 折叠归约:reduce
在 Python 3 中,reduce 从内置函数移动到了 functools 模块中。它接受一个二元函数和一个可迭代对象,从左到右将运算结果不断与下一个元素累计结合,最终缩减为一个单一标量值。
import functools
import operator

numbers = [1, 2, 3, 4, 5]

# 计算阶乘或连乘
total_product = functools.reduce(operator.mul, numbers)
print("连乘结果:", total_product)
# 示例输出:连乘结果: 120

# 带初始值的字典数据合并
payloads = [{"a": 1}, {"b": 2}, {"a": 10, "c": 3}]
merged = functools.reduce(lambda acc, d: {**acc, **d}, payloads, {})
print("合并字典:", merged)
# 示例输出:合并字典: {'a': 10, 'b': 2, 'c': 3}
5. 单分派泛型函数:singledispatch
很多面向对象语言支持基于参数类型的函数重载。Python 原生不支持多重载,但 functools.singledispatch 允许我们根据第一个参数的类型派发到不同的实现函数,避免在单一函数内编写臃肿的 if isinstance(...) 逻辑。
import functools
import json

@functools.singledispatch
def format_data(arg):
    """默认处理基准"""
    return f"Default string representation: {arg}"

@format_data.register(int)
def _(arg: int):
    return f"Integer number: {arg:,}"

@format_data.register(list)
def _(arg: list):
    return f"List with {len(arg)} items: {', '.join(map(str, arg))}"

@format_data.register(dict)
def _(arg: dict):
    return f"JSON: {json.dumps(arg, ensure_ascii=False)}"

print(format_data(1000000))
print(format_data(["apple", "banana"]))
print(format_data({"code": 200, "status": "ok"}))
print(format_data(3.14159))
# 示例输出:
# Integer number: 1,000,000
# List with 2 items: apple, banana
# JSON: {"code": 200, "status": "ok"}
# Default string representation: 3.14159
三、关键机制差异与避坑指南
在同时使用 itertools 与 functools 时,有几个常见的状态管理与引用陷阱必须特别注意:
| 对比维度 | 典型做法 A | 典型做法 B | 关键影响与选型建议 |
|---|---|---|---|
| 参数绑定方式 | partial(func, 10) |
lambda x: func(10, x) |
partial 立即在创建时固化参数值;lambda 会延迟绑定外层作用域变量,如果在循环体中创建 lambda,容易发生所有闭包均引用最后循环变量的 Bug。 |
| 数据流消费模式 | itertools.islice(gen, 10) |
[x for x in gen][:10] |
islice 仅按需拉取前 10 个元素,原生成器停在第 10 项;而列表切片需要先完整遍历 gen 并存入列表,耗尽生成器且极大浪费内存。 |
| 类实例方法缓存 | @lru_cache 作用于方法 |
@functools.cached_property |
直接在类方法上加 @lru_cache 会导致缓存字典内部持有 self 强引用,使实例无法被垃圾回收导致内存泄露;对于只读属性应使用 @cached_property。 |
Python 中的迭代器是单向流动且一次性消费的。一旦遍历完毕,迭代器将变空。如果需要多次使用同一个流式迭代器,切勿重复 for 循环,而应使用 itertools.tee(iterable, n=2) 分裂出 n 个互不影响的独立迭代器备份。
四、总结
itertools 和 functools 分别从“数据流生成”与“行为抽象封装”两个维度补齐了 Python 的高效函数式能力:
- 处理海量数据或组合逻辑时,优先考虑
itertools。利用islice、chain和product构建惰性处理管道,能将内存占用维持在极低水平。 - 优化函数调用与架构设计时,充分运用
functools。利用lru_cache消除重复计算,借助partial简化接口绑定,使用wraps维持装饰器元数据纯净,通过singledispatch实现类型解耦。
掌握这两个标准库工具函数,不仅能显著减少重复冗长的样板代码,更能编写出执行高效、逻辑严谨的高质量 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















