


Python多线程真的有意义吗?GIL机制下的性能真相

一、揭开面纱:GIL究竟是什么,为何它锁住了多线程
我们通常运行的Python官方实现是CPython。为了保证内部内存管理的安全性,CPython引入了一把名为GIL(Global Interpreter Lock,全局解释器锁)的互斥锁。
在CPython中,每个Python对象都维护着一个引用计数器。当有新变量引用该对象时计数器加1,引用失效时减1。一旦计数器清零,Python就立刻回收该对象的内存空间。如果在多核心CPU环境下允许多个系统线程完全并行地执行Python字节码,多个线程可能会在没有锁保护的情况下同时修改同一个对象的引用计数,引发竞态条件导致严重的内存泄漏或访问非法内存指针崩溃。为了简单且高效地解决这一痛点,CPython选择在解释器层级增加一把互斥锁:在任意给定的时刻,只有一个线程能够持有这把GIL并执行Python原生字节码。
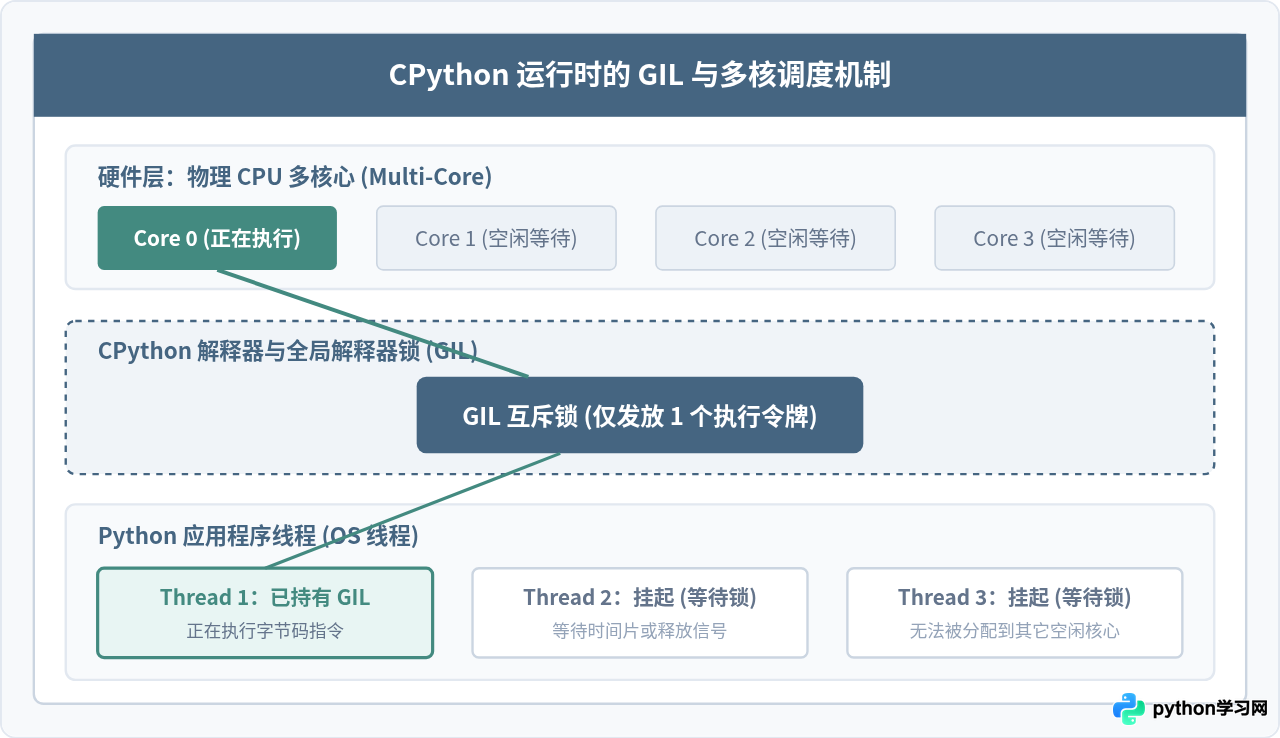
Python标准库中的 threading.Thread 创建的确实是真实的操作系统原生线程(在Linux上是pthread,在Windows上是Win32线程)。然而,由于每个线程在被CPU调度之前都必须先向解释器申请GIL,因此在计算任务下,它们只能排队轮流使用单核心,无法实现真正的多核物理并行。
二、性能真相:CPU密集型 vs I/O密集型实测对比
既然GIL只允许一个线程执行字节码,那么为什么在很多实际业务中,大家依然大量使用Python多线程?关键差异在于任务类型是属于CPU密集型还是I/O密集型。
1. CPU密集型任务:为什么多线程反而更慢?
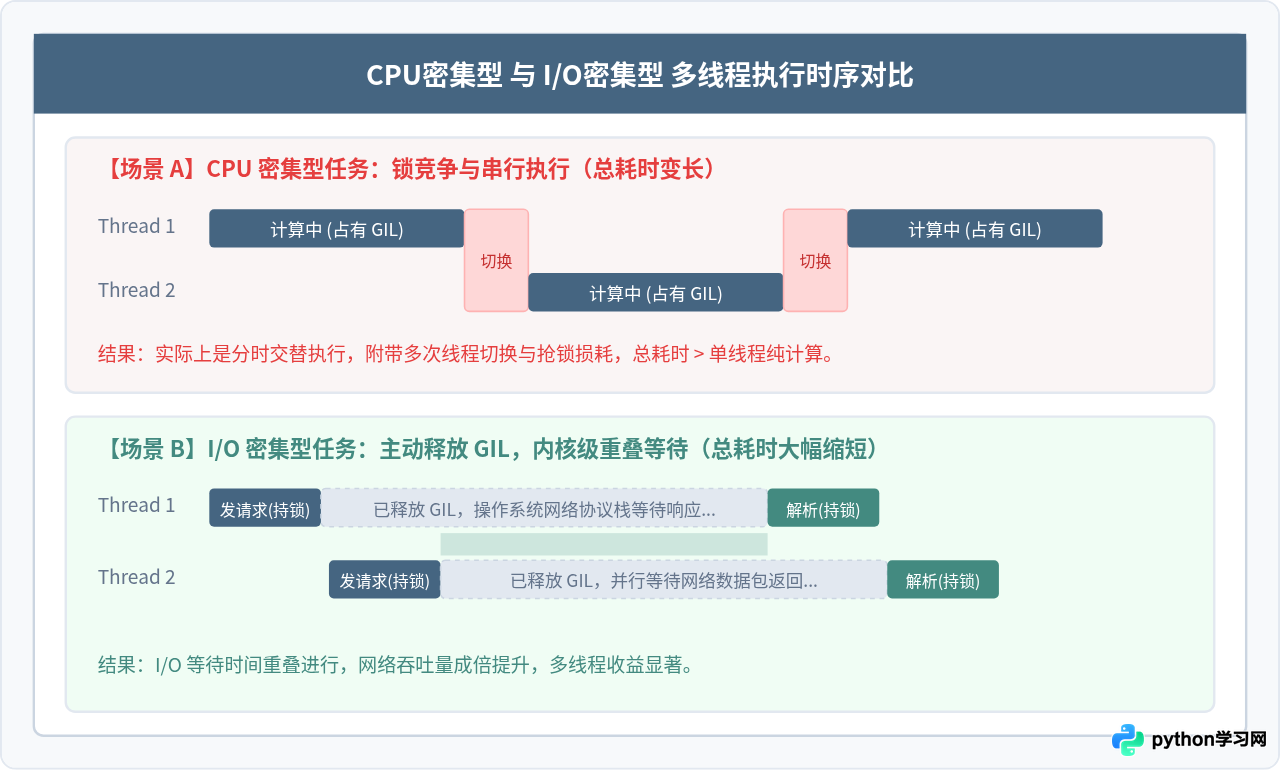
CPU密集型任务以算术计算、循环累加、哈希计算等纯逻辑运算为主。在这类任务中,线程执行时不会产生I/O等待,必须持续占用CPU。CPython为了防止某个线程一直霸占GIL,设置了强制切换机制(通过 sys.getswitchinterval(),默认间隔通常为5毫秒)。
当执行时间达到阈值时,当前线程被迫释放GIL,操作系统介入进行线程上下文切换。此时,其他处于等待状态的线程会立即开始争抢GIL。这种频繁的“释放锁 - 上下文切换 - 争抢锁”过程带来了显著的CPU系统开销。
import time
from concurrent.futures import ThreadPoolExecutor

# 纯计算任务:累加计算
def cpu_heavy_task(n):
    total = 0
    for i in range(n):
        total += i
    return total

if __name__ == "__main__":
    count = 40_000_000

    # 1. 单线程顺序执行
    start = time.perf_counter()
    cpu_heavy_task(count)
    cpu_heavy_task(count)
    print(f"单线程耗时: {time.perf_counter() - start:.2f}秒")

    # 2. 多线程并发执行
    start = time.perf_counter()
    with ThreadPoolExecutor(max_workers=2) as executor:
        f1 = executor.submit(cpu_heavy_task, count)
        f2 = executor.submit(cpu_heavy_task, count)
        f1.result()
        f2.result()
print(f"双线程耗时: {time.perf_counter() - start:.2f}秒")2. I/O密集型任务:多线程发挥威力的核心机制
I/O密集型任务的大部分时间花在等待外部设备或网络响应上,例如发送HTTP请求、读取本地磁盘大文件、执行数据库查询等。在这些场景中,CPU的实际计算量微乎其微。
Python内部对所有阻塞式I/O操作(如底层的套接字接收、文件读写等C函数调用)做过专门优化:当线程发起系统I/O调用前,会主动释放GIL;当I/O操作完成、数据准备就绪后,线程才重新申请GIL来处理结果。
这意味着,当线程A因等待远程服务器响应而释放GIL并挂起时,线程B可以立即拿到GIL去发起另一个网络请求。多个线程在操作系统内核层面并行等待网络传输,重叠了绝大部分网络往返时延(RTT),从而使总体吞吐量呈线性倍增。
三、如何判断自身业务是否受GIL制约:诊断流程
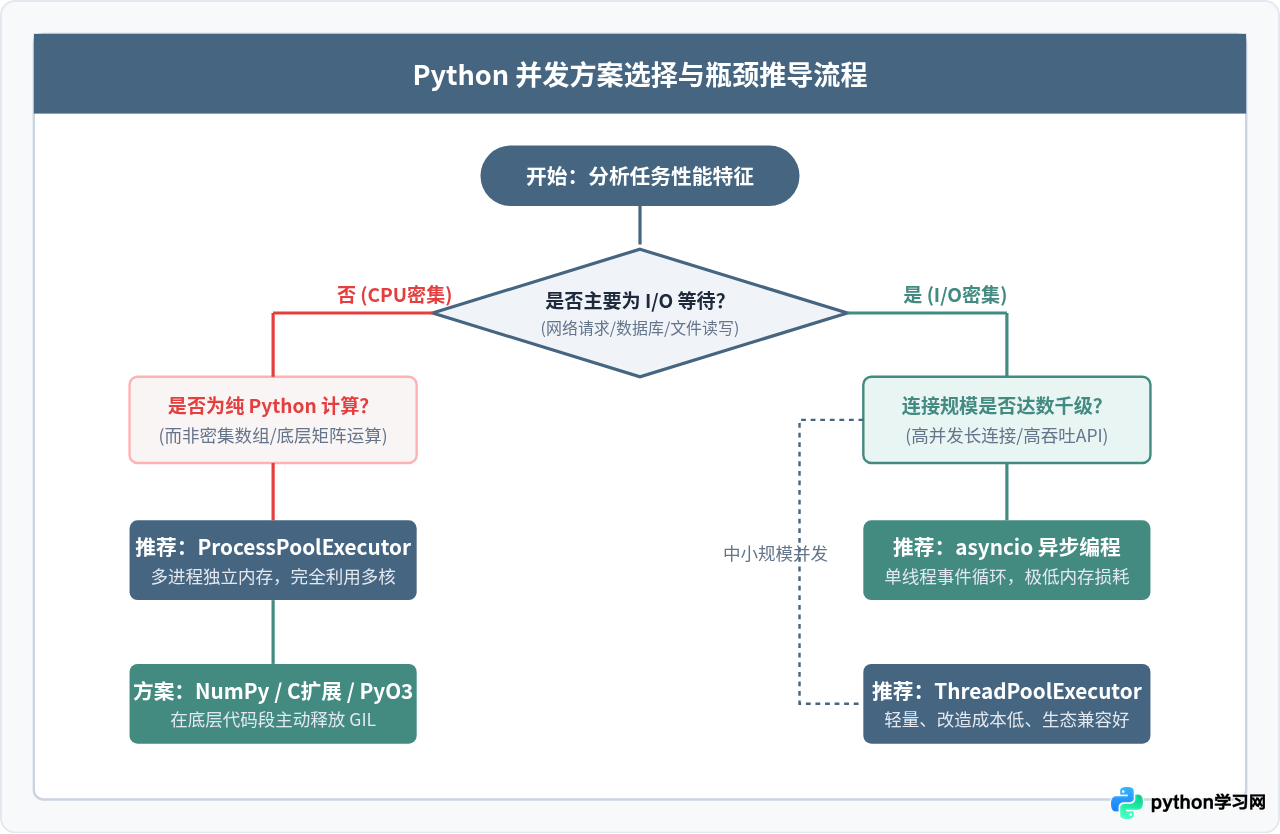
在着手重构代码前,应根据程序运行时的实际状态进行客观分析。很多开发者在发现程序运行缓慢时,盲目开启大量线程,结果CPU占用率飙升到单核100%,整体响应速度却没有改善。以下是标准的排查与分析步骤:
- 使用性能分析工具定位瓶颈:使用标准库的
cProfile模块或轻量监控工具分析热点代码。如果最耗时的调用大多集中在数学计算函数、字符串拼接、数据压缩等环节,属于典型的CPU瓶颈;如果耗时集中在socket.recv、file.read、select等系统调用上,则属于I/O瓶颈。 - 观察CPU核心使用率特征:使用
top或htop观察进程表现。若在拥有8核的服务器上运行多线程程序,进程的总CPU占用率牢牢停留在 100%(即刚好占满1个物理核心的算力),且多个核交替微升,这正是GIL限制的典型标志;如果每个核都有均匀且高负荷的计算,说明并未受GIL束缚(如底层NumPy矩阵运算)。 - 基准性能对照测试:通过将并发数从1递增到4测试总耗时。如果随着线程数增加,总耗时几乎不变甚至缓慢递增,应立即停止使用多线程方案。
四、绕过与打破GIL限制的三大主流方案
当经过测试确认任务受限于GIL机制后,可以采用以下成熟的技术路径来利用多核计算资源:
1. 多进程:concurrent.futures.ProcessPoolExecutor
多进程是解决Python CPU密集型任务最直接且标准的方式。操作系统中的每一个进程都拥有完全独立的地址空间和解释器实例,因此每个进程都拥有独立的GIL。多个进程可以被操作系统完全调度到不同的物理核心上并行运行。
from concurrent.futures import ProcessPoolExecutor
import time

def compute_chunk(data_slice):
    return sum(x * x for x in data_slice)

if __name__ == "__main__":
    data = list(range(10_000_000))
    chunk_size = len(data) // 4
    chunks = [data[i:i + chunk_size] for i in range(0, len(data), chunk_size)]

    start = time.perf_counter()
    # 启用4个进程并行计算
    with ProcessPoolExecutor(max_workers=4) as executor:
        results = list(executor.map(compute_chunk, chunks))
        total_sum = sum(results)

print(f"4进程多核并行耗时: {time.perf_counter() - start:.2f}秒")pickle 序列化和反序列化传递数据。若传递的数据量达到GB级别,序列化和反序列化开销可能会抵消多核计算带来的收益。因此,建议采用“小数据传输、重数据计算”的设计原则。
2. C/C++或Rust扩展:在底层主动释放GIL
很多常用的科学计算库(如 NumPy、SciPy、PyTorch)虽然通过Python代码调用,但在底层执行大规模矩阵运算时,是用C或Fortran编写的优化算法。在进入紧凑循环之前,它们会通过底层宏 Py_BEGIN_ALLOW_THREADS 主动释放GIL,在纯原生代码中开启真正的多线程运算,任务完成后再通过 Py_END_ALLOW_THREADS 重新获取锁。
因此,使用NumPy进行大规模数值计算时,多线程依然可以跑满多核心,因为耗时操作已经脱离了CPython字节码的解释执行环境。
3. Python 3.13 的自由线程模式(Free-Threaded CPython)
在最新的Python 3.13中,官方正式引入了根据 PEP 703 设计的自由线程构建(Free-Threaded build,实验性)。该构建完全移除了全局解释器锁,改用更细粒度的锁机制保护内部对象。在自由线程解释器下,原生的Python多线程在CPU密集型任务下可以直接跑满所有物理CPU核心,展现出与C/Go等语言类似的多核并行加速能力。随着第三方库逐步完成兼容适配,GIL对多核计算的制约在未来将从根本上得到解决。
五、选型结论与速查指南
回到核心问题:“Python多线程真的有意义吗?”答案非常明确:
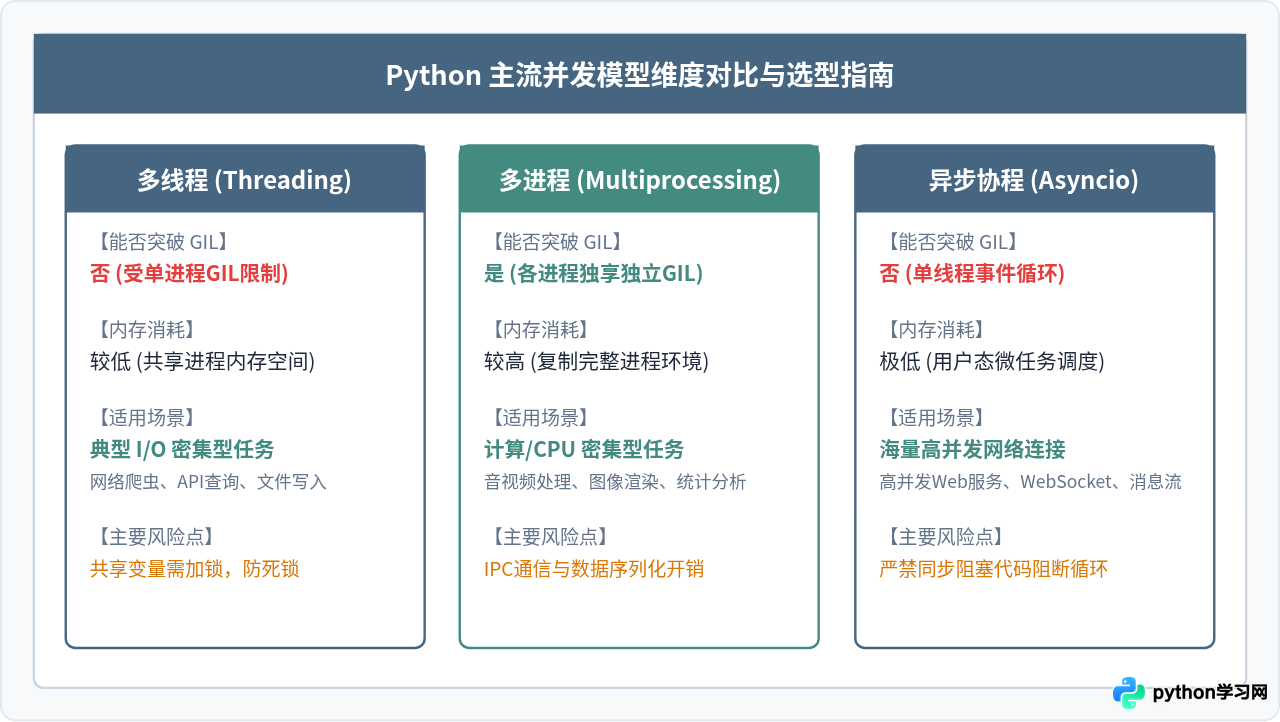
- 它在I/O密集型任务中非常有意义:多线程代码写法直观、共享内存无序列化开销、内存占用小,是处理网络请求、批量爬取、文件操作和第三方微服务调用的首选方案之一。
- 它在CPU密集型任务中没有加速意义:受制于GIL,单进程内的多个线程只能轮流使用单核心,频繁切换还会拖慢性能。这类场景应果断转向多进程(
ProcessPoolExecutor)或借助C/Rust扩展。
| 技术方案 | 典型模块 | 适合任务类型 | 核心优势 | 主要代价与注意点 |
|---|---|---|---|---|
| 多线程 | concurrent.futures.ThreadPoolExecutor |
I/O密集型(网络、磁盘、数据库) | 开销小、内存共享、编程模型直观 | 受GIL限制无法利用多核加速CPU计算;共享状态需互斥锁 |
| 多进程 | concurrent.futures.ProcessPoolExecutor |
CPU密集型(纯数学、音视频、算法) | 彻底避开GIL,完全跑满多物理核心 | 进程创建和数据IPC序列化开销大,内存占用随进程数成倍增加 |
| 异步协程 | asyncio |
高并发I/O(长连接、微服务网关) | 极高吞吐、单线程无锁竞争风险 | 传染性async/await语法,要求全链路异步生态支持,不可阻塞 |
掌握任务特征与底层机制的对应关系,是破除“多线程无用论”的关键。在面对实际业务时,只需明确区分任务是“等数据”还是“算数据”,即可准确选定最佳并发架构。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















