


Python多线程、多进程与协程的区别及适用场景

在Python中编写高并发程序时,选择多进程、多线程还是协程,核心取决于任务属于CPU密集型还是I/O密集型。由于全局解释器锁(GIL)的存在,多进程用于突破单核算力上限实现真正的多核并行;多线程适合有系统阻塞调用的中低并发I/O任务;而协程则通过单线程内的事件循环以极低开销支撑数以万计的并发网络连接。
一、并发编程的基础底座:GIL与任务特征分类
在对比三种技术之前,必须首先理解CPython解释器的核心限制机制——全局解释器锁(GIL,Global Interpreter Lock),以及计算机任务的两大基本特征。
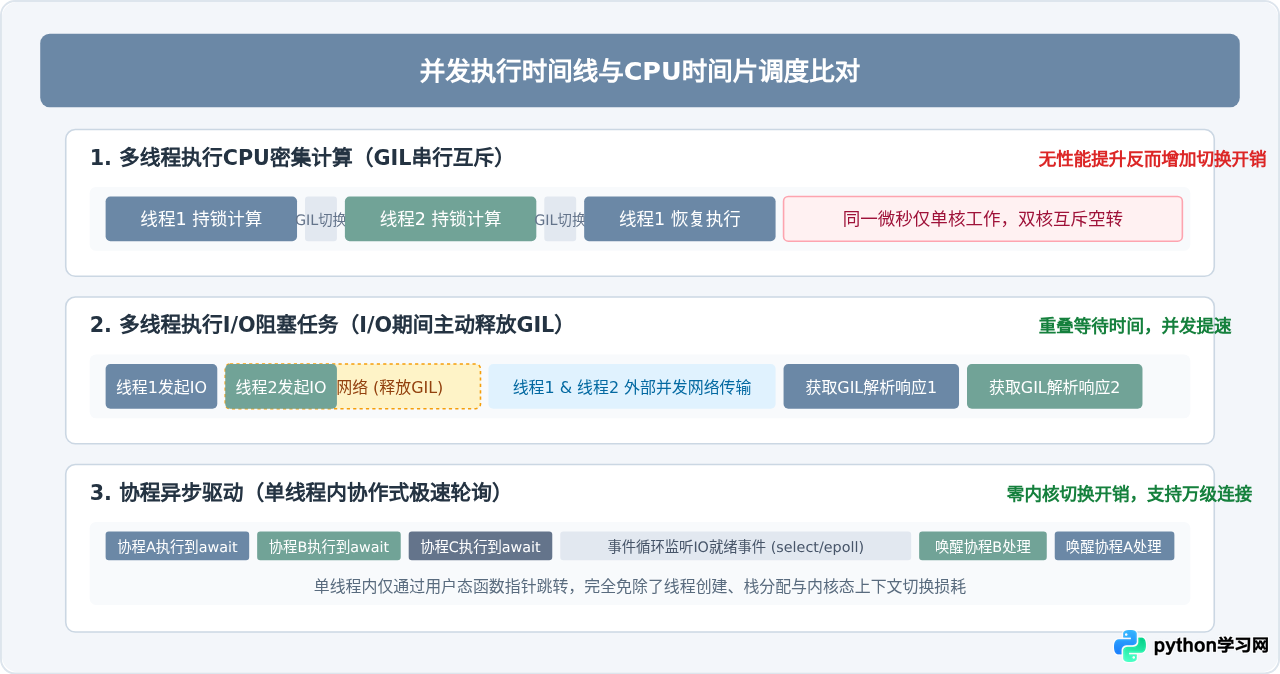
GIL是CPython解释器为了内存管理安全(特别是引用计数机制)而设计的互斥锁。在同一个操作系统进程内,即便硬件拥有16个CPU核心,在任意给定微秒内,只允许一个系统线程执行Python字节码。这意味着Python的原生多线程无法直接在多核CPU上实现并行的计算加速。
然而,程序执行的工作可以清晰划分为两类:
- CPU密集型任务(Compute-Bound):主要时间消耗在指令运算与数据处理上,例如复杂的数学计算、图像编解码、机器学习前向推理和矩阵运算。此类任务对CPU算力要求高,受GIL制约严重。
- I/O密集型任务(I/O-Bound):主要时间消耗在等待外部资源响应,例如网络HTTP请求、数据库读写、磁盘文件拷贝或微服务通信。在等待网络或磁盘应答期间,CPU几乎处于闲置状态。
关键机制在于:当Python线程执行底层系统I/O调用(如socket通信、文件读取或C语言拓展耗时运算)时,解释器会主动释放GIL。这就为多线程和协程在I/O场景下的高效运作留出了充裕的空间。
二、多进程(multiprocessing):突破GIL的多核并行方案
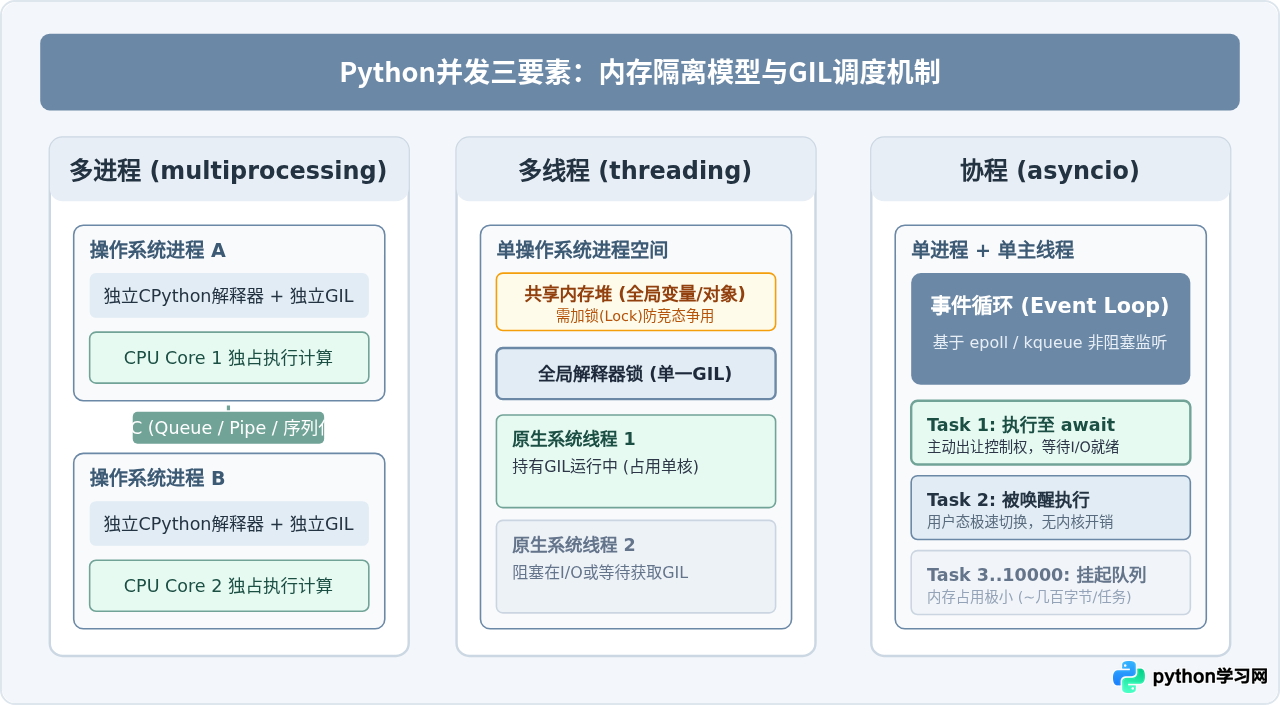
多进程通过创建完全独立的操作系统进程来工作。每个Python进程拥有独立的虚拟地址空间、独立的CPython运行时环境以及专属于自己的GIL。
1. 运作原理与核心优势
因为每个子进程都在独立执行其专属解释器,各进程之间互不干扰,操作系统内核可以直接将不同的Python进程分派到不同的物理CPU核心上,从而达到真正的并行计算(True Parallelism)。对于高耗能的数学密集型计算任务,双核即可带来近两倍的速度提升。
2. 代价与限制
- 内存开销大:每个进程都需要载入完整的Python解释器及相关依赖库,初始内存开销通常在十数兆至几十兆字节不等。
- 上下文切换成本高:操作系统进行进程切换时,涉及虚拟内存页表置换、CPU寄存器切换与TLB刷新,耗时显著高于线程。
- 进程间通信(IPC)复杂:由于地址空间彻底隔离,进程间传递对象必须经过
pickle序列化与反序列化,若需要传递海量数据,序列化本身的CPU开销可能抵消并行的收益。
3. 完整代码示例(多进程并行加速)
在编写多进程脚本时,入口处必须使用 if __name__ == '__main__': 进行守护,以防止子进程在Windows或macOS等采用 spawn 启动方式的系统中递归创建新进程。
import time
from concurrent.futures import ProcessPoolExecutor

def cpu_bound_task(n: int) -> int:
    """模拟CPU密集型计算任务:计算大数累加"""
    count = 0
    for i in range(n):
        count += (i * i) % 7
    return count

def run_multiprocess():
    numbers = [20_000_000] * 4  # 4个密集的计算任务
    start_time = time.perf_counter()

    # 创建与CPU核心数匹配的进程池
    with ProcessPoolExecutor(max_workers=4) as executor:
        results = list(executor.map(cpu_bound_task, numbers))

    elapsed = time.perf_counter() - start_time
    print(f"[多进程] 4个计算任务全部完成,耗时: {elapsed:.2f}秒,结果列表: {results}")

if __name__ == '__main__':
    run_multiprocess()
[多进程] 4个计算任务全部完成,耗时: 1.82秒,结果列表: [60000000, 60000000, 60000000, 60000000]注:若使用单进程顺序执行同样任务,耗时约为 6.95 秒。多进程在此类计算任务中展现出立竿见影的加速效果。
三、多线程(threading):低开销的抢占式I/O并发
多线程是指在同一个进程内部派生出多个执行线程。Python的 threading 模块映射的是操作系统的原生轻量级线程。
1. 运作原理与适用机制
同一进程内的所有线程共享完全相同的内存地址空间,包括全局变量、堆内存和打开的文件句柄。线程之间的通信非常迅速,无需借助网络或管道序列化即可直接读写共享对象。
虽然GIL限制同一时刻只能有一个线程执行Python代码,但当某个线程触发网络I/O、磁盘I/O或调用 time.sleep() 时,解释器会立即释放GIL,允许其他就绪线程获取锁并继续运行。因此,在面临大量网络延迟、接口请求等待时,多线程可以大幅缩短总体耗时。
2. 数据安全与竞争条件(Race Condition)
由于内存共享且线程调度由操作系统内核通过时间片抢占(Preemptive Scheduling),若多个线程同时读写无保护的可变对象,极易发生状态不一致问题。必须引入 threading.Lock 或使用线程安全的队列 queue.Queue。
3. 完整代码示例(多线程处理I/O等待)
import time
import threading
from concurrent.futures import ThreadPoolExecutor

# 共享计数器与保护锁
counter = 0
counter_lock = threading.Lock()

def io_bound_task(task_id: int) -> str:
    """模拟I/O密集型任务:等待远程服务响应"""
    global counter
    time.sleep(1.0)  # 模拟网络等待1秒,期间主动让出GIL

    with counter_lock:
        counter += 1

    return f"任务_{task_id}_完成(当前总数:{counter})"

def run_multithread():
    start_time = time.perf_counter()

    # 启动10个线程并发处理I/O任务
    with ThreadPoolExecutor(max_workers=10) as executor:
        futures = [executor.submit(io_bound_task, i) for i in range(10)]
        results = [f.result() for f in futures]

    elapsed = time.perf_counter() - start_time
    print(f"[多线程] 10个I/O任务全部完成,耗时: {elapsed:.2f}秒")
    print(f"示例输出条目: {results[0]} ~ {results[-1]}")

if __name__ == '__main__':
    run_multithread()
[多线程] 10个I/O任务全部完成,耗时: 1.02秒注:顺序执行10个耗时1秒的I/O任务需10秒,而10个并发线程利用I/O期间释放GIL的特性,仅耗时1秒多即全部结束。
四、协程(asyncio):单线程内的协作式超高并发
协程(Coroutine)常被称为“用户态轻量级线程”。在Python 3.5引入 async/await 语法之后,协程已成为处理超高并发I/O的标准方案。
1. 运作原理与协作式调度(Cooperative Multitasking)
与多进程和多线程由操作系统的内核时钟中断强行剥夺CPU控制权(抢占式)不同,协程是完全协作式的:
- 代码在单一主线程内部运行,自始至终只有一个进程、一个线程和一个GIL。
- 程序通过底层的事件循环(Event Loop)组织调度。当某个协程执行到带有
await的异步I/O操作时,该协程会主动挂起自身并将CPU控制权归还给事件循环。 - 事件循环依托操作系统的非阻塞多路复用机制(Linux上的
epoll、macOS上的kqueue、Windows上的IOCP)监听海量网络套接字。一旦某个套接字的数据到达,事件循环便按顺序唤醒对应的协程恢复执行后续逻辑。
2. 核心优势与致命陷阱
极致的并发能力:每个操作系统线程默认拥有8MB左右的独立调用栈,创建数千个线程会耗尽系统内存并导致严重的调度开销。而一个Python协程仅是一个微型的生成器对象,内存开销仅数百字节,一台普通服务器即可轻松维持成千上万个并发协程。
由于所有协程运行在单一线程内,如果在协程中调用了如 time.sleep()、requests.get() 或密集循环计算,整个事件循环将被彻底卡死,所有其他协程都无法被唤醒。必须使用全异步生态(如 asyncio.sleep()、aiohttp、asyncpg),或将阻塞调用通过 asyncio.to_thread() 委派至辅助线程池中执行。
3. 完整代码示例(asyncio高并发模拟)
import asyncio
import time

async def fetch_api(task_id: int) -> str:
    """模拟异步网络请求:非阻塞等待1秒"""
    # 模拟网络I/O请求,让出控制权让其他协程继续处理
    await asyncio.sleep(1.0)
    return f"接口响应_{task_id}"

async def main():
    start_time = time.perf_counter()

    # 同时调度1000个并发协程任务
    tasks = [fetch_api(i) for i in range(1000)]
    results = await asyncio.gather(*tasks)

    elapsed = time.perf_counter() - start_time
    print(f"[协程] 1000个并发网络任务全部完成,耗时: {elapsed:.2f}秒")
    print(f"数据总数: {len(results)}条,前三条: {results[:3]}")

if __name__ == '__main__':
    asyncio.run(main())
[协程] 1000个并发网络任务全部完成,耗时: 1.05秒注:即便将并发任务扩展至1000个,耗时依然仅为1秒左右,且系统内存占用与CPU利用率维持在极低水准。
五、多进程、多线程与协程的关键特性横向对比
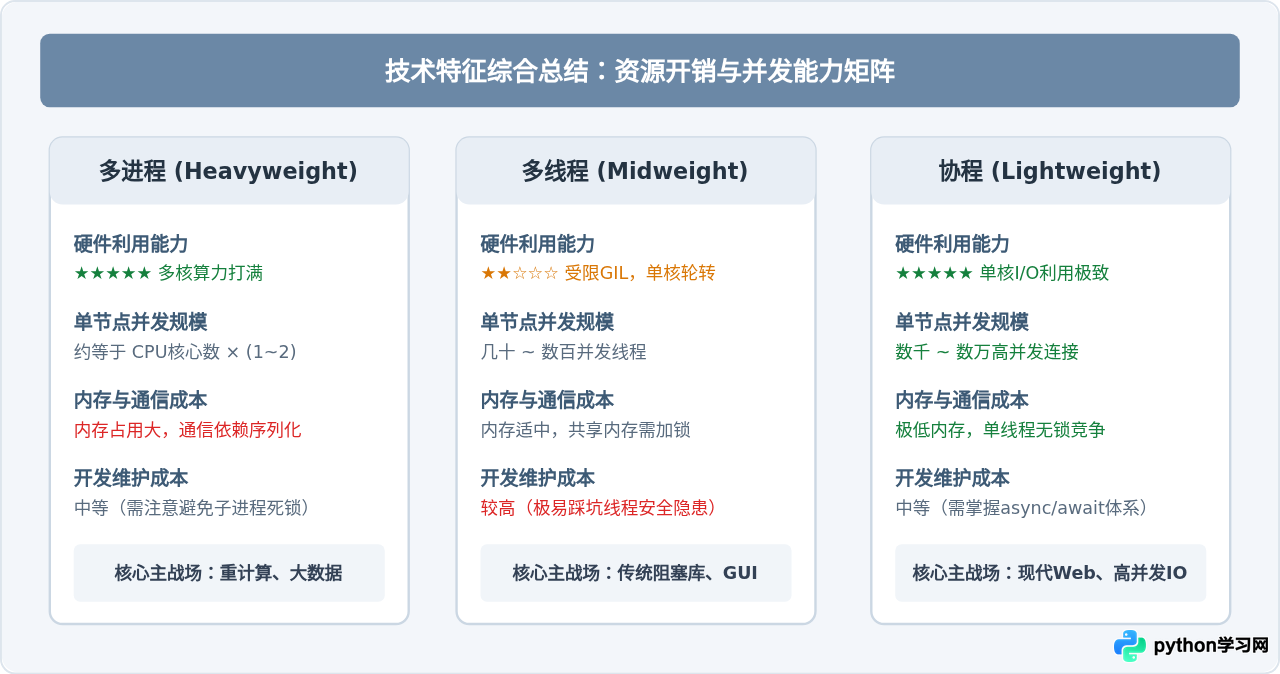
为了直观建立全方位的技术认知,下表将三种并发机制在架构层级、系统开销、安全边界及典型使用场景进行系统化对齐:
| 对比维度 | 多进程 (multiprocessing) | 多线程 (threading) | 协程 (asyncio) |
|---|---|---|---|
| 核心调度者 | 操作系统内核(抢占式) | 操作系统内核(抢占式) | 用户态事件循环(协作式) |
| GIL影响 | 完全绕过(每个进程独立GIL) | 受GIL限制,多核只能串行运行字节码 | 受GIL限制,本身仅在单线程内运行 |
| 内存开销 | 极高(每个进程独立虚拟内存) | 中等(共享堆,每个线程约8MB栈) | 极低(单任务仅数百字节对象) |
| 切换代价 | 高(页表切换、TLB重刷) | 中等(内核态上下文切换) | 极低(函数指针调用,用户态跳转) |
| 通信机制 | IPC(队列、管道,需pickle序列化) | 共享内存(全局变量,需加互斥锁) | 共享内存(事件循环队列,单线程无竞态) |
| 并发规模上限 | 数十至数百(受物理CPU核与内存制约) | 数百至千级(受OS线程数与栈内存制约) | 万级至十万级(受网络文件句柄与网络带宽制约) |
| 典型适用领域 | 视频编解码、大模型推理、科学计算 | 桌面GUI异步交互、中小型爬虫、文件IO | Web微服务、即时聊天网关、超高并发爬虫 |
六、如何根据业务特征进行技术选型(决策路径)
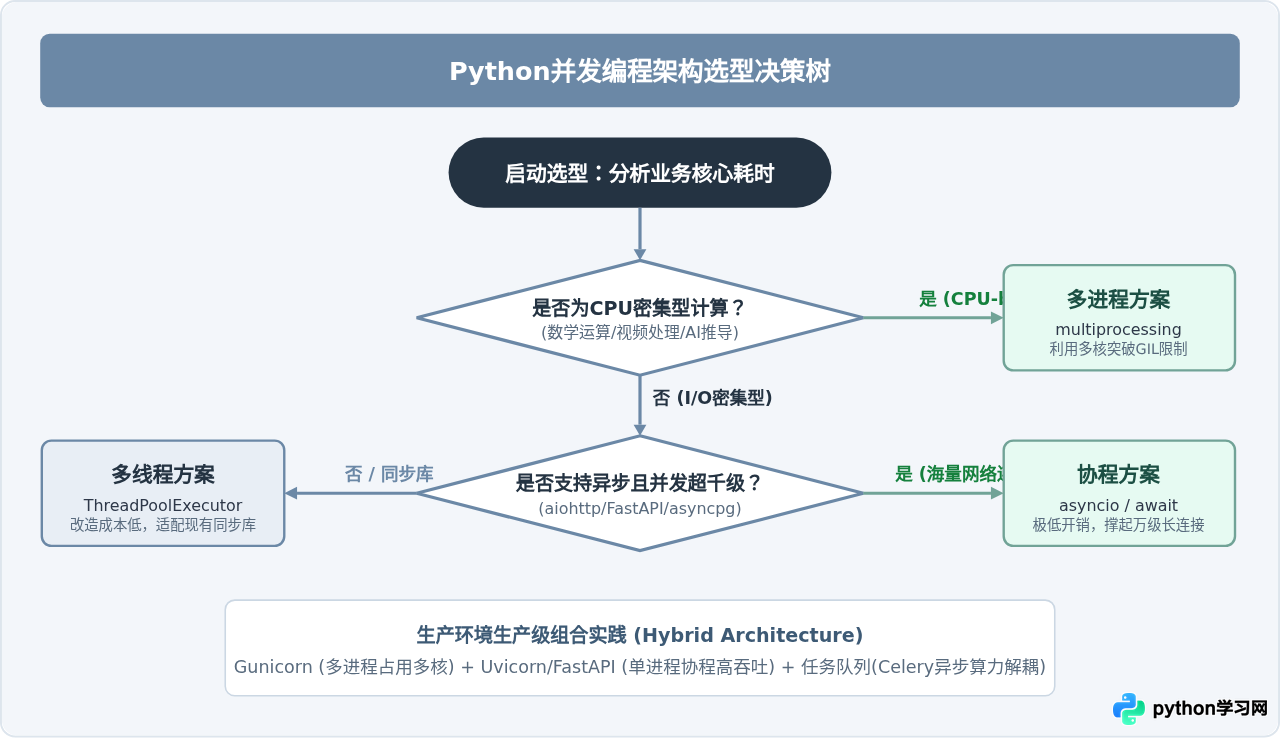
在工程实践中,切忌盲目追求协程或随意套用多线程。应遵循以下标准决策流程:
- 第一步:判断是否包含大量CPU计算。
如果任务的核心耗时在循环、压缩、加密、数字矩阵运算或图像渲染上,直接选择多进程(
multiprocessing或ProcessPoolExecutor)。无论多线程还是协程在此类场景下不仅无法提速,反而因频繁切换导致性能劣化。 - 第二步:若为I/O任务,评估外部三方库生态是否支持异步。
如果任务大量依赖旧有的同步阻塞库(如旧版数据库驱动、仅提供同步阻塞调用的SDK、或基于
requests编写的历史代码),重构为异步成本极高,此时推荐使用多线程池(concurrent.futures.ThreadPoolExecutor)。 - 第三步:若支持异步或追求极高并发规模,选择协程。
对于全新的Web后端(FastAPI / Sanic)、网络爬虫、WebSocket即时通信或网关转发类服务,由于并发连接动辄数千且拥有完整的异步生态支持,协程(
asyncio+aiohttp/httpx)是最佳选择。 - 第四步:混合架构实践。
现实系统往往并非非黑即白。例如一个高并发API服务端,通常使用多进程作为外层部署容器(如使用 Gunicorn 启动多个 Worker 进程占用多个CPU核心),每个 Worker 进程内部运行asyncio 事件循环来并发响应数万个HTTP请求;当个别请求需要处理密集的图像裁剪时,再将其临时抛入专用的子进程池中异步计算。这种“多进程外壳 + 单进程协程 + 计算进程池”的组合拳,正是现代Python系统架构的标准范式。
七、总结
理解Python并发编程的本质,不在于背诵API名称,而在于准确把握CPU瓶颈与I/O瓶颈的物理区别,以及解释器锁GIL在不同状态下的表现:
- 想要榨干多核物理算力处理大批量数据与科学计算,选择多进程;
- 想要平滑改造已有的阻塞式网络、磁盘操作或配合GUI交互,选择多线程;
- 想要以最低资源损耗构建现代高并发Web接口、网关服务与微服务客户端,选择协程。
结合具体工程环境,权衡开发维护成本、内存开销与吞吐量上限,即可构建出稳定高效的Python并发系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















