


初级Python程序员怎么进阶?突破瓶颈所需的技术深度与架构能力
针对初级Python程序员面临的成长瓶颈,从语言底层运行机制、并发模型设计、性能分析调优到系统分层架构与工程化落地,全面解析突破瓶颈所需的技术深度与架构能力。
一、认识瓶颈:初级开发与中高级工程师的核心差距
初级 Python 开发者通常以“功能实现”为第一目标。只要代码能跑通、输出结果正确,任务即告完成。但在高吞吐、低延迟或复杂业务场景下,这种思维模式会迅速遇到天花板。
中高级工程师与初级开发者的区别,不在于记住了多少个第三方库的函数签名,而在于对技术底层边界的清晰认知,以及在不确定场景下做技术选型与权衡的能力。初级工程师看重“怎么用”,而中高级工程师关注“底层的代价、失败的容错与扩展的上限”。
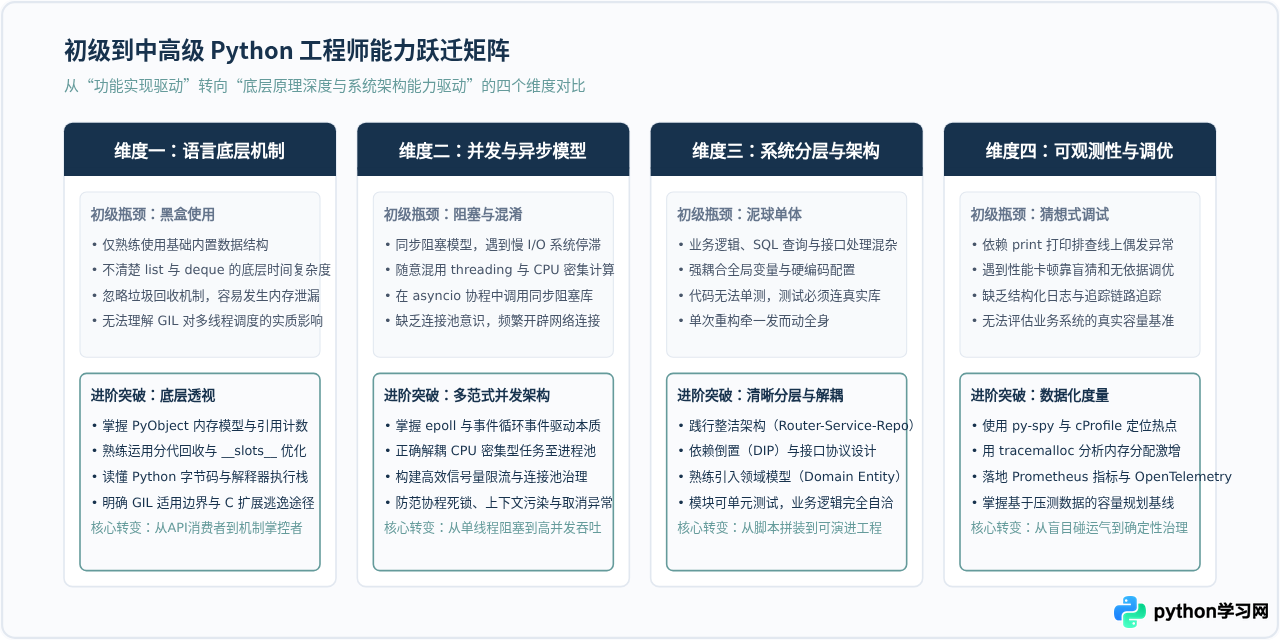
二、突破瓶颈所需的技术深度
技术深度是编写稳健系统的底气。当系统规模变大时,Python 抽象层掩盖的底层开销就会被放大。进阶开发者必须掌握以下三项核心深度技能。
1. 深入 Python 对象模型与内存回收机制
在 CPython 实现中,一切变量皆为指向 PyObject 结构的指针。一个简单的整数在 Python 中不仅包含 8 字节的数值,还包含 8 字节的引用计数 ob_refcnt 以及 8 字节的类型对象指针 ob_type。这种开销在处理百万级细粒度对象时会消耗巨量内存。
- 内存优化实践:对于需要大量实例化的实体类,应显式声明
__slots__,这会阻止 Python 为每个实例分配动态字典__dict__,通常可减少 40% 到 60% 的内存占用。 - 垃圾回收双轨制:CPython 主要依托引用计数实时回收垃圾;为解决循环引用(如对象 A 包含对象 B,对象 B 同时引用对象 A),额外引入了分代回收机制(分为 0、1、2 三代)。如果代码中大量生成循环引用,会迫使分代回收器频繁执行慢速标记-清除,引发不可忽视的停顿。
# 示例:通过 __slots__ 与 tracemalloc 度量内存消耗
import tracemalloc

class LegacyPoint:
    def __init__(self, x: float, y: float):
        self.x = x
        self.y = y

class OptimizedPoint:
    __slots__ = ('x', 'y')  # 消除 __dict__ 开销
    def __init__(self, x: float, y: float):
        self.x = x
        self.y = y

tracemalloc.start()
# 实例化 100,000 个带 slots 的优化对象
points = [OptimizedPoint(i * 0.5, i * 1.5) for i in range(100_000)]
current, peak = tracemalloc.get_traced_memory()
tracemalloc.stop()

print(f"当前常驻内存: {current / 1024 / 1024:.2f} MB | 峰值内存: {peak / 1024 / 1024:.2f} MB")
2. 透视并发模型:GIL、线程、进程与协程的本质抉择
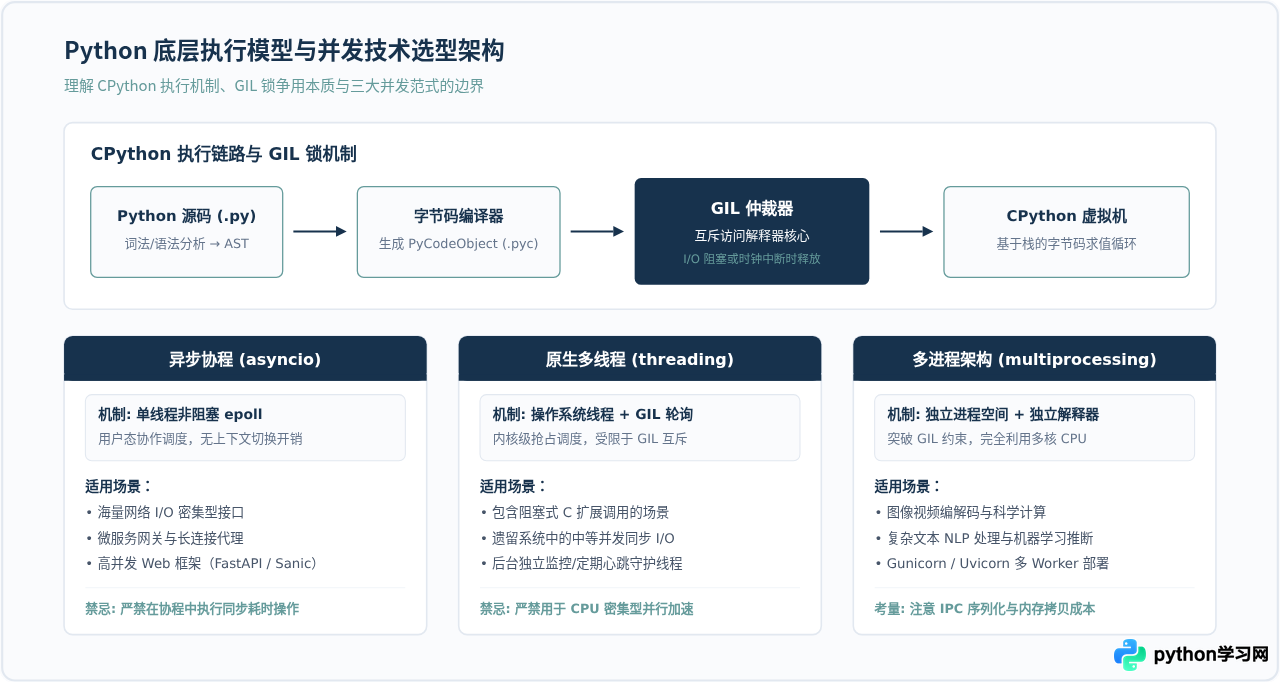
初级程序员最常见的误区是:“系统慢了就开多线程”。但在 CPython 中,全局解释器锁(GIL)确保同一时刻只有一个原生线程在执行 Python 字节码。
- 多线程(threading):受 GIL 制约,无法利用多核 CPU 加速纯计算任务。它只适合传统阻塞式网络 I/O 或文件操作,因为在进入系统调用前,解释器会主动释放 GIL。
- 多进程(multiprocessing):通过派生独立操作系统进程,拥有独立的 Python 解释器和独立 GIL,是充分释放多核 CPU 算力(如图像处理、机器学习推断、大数据批处理)的标准解法。但缺点是跨进程通信(IPC)与内存序列化开销较高。
- 协程(asyncio):采用单线程事件循环(基于 epoll / kqueue),通过用户态调度协作执行。由于没有操作系统线程上下文切换的开销,单个进程即可承载数万并发网络连接,非常适合现代高并发 API 服务。但必须严禁在协程中调用任何同步阻塞函数。
3. 基于性能分析器的精确调优与诊断
不要依赖经验盲猜性能瓶颈。经验往往会误判热点所在。中高级工程师掌握基于 Profiler 工具链的性能分析方法:
- 函数级分析(cProfile):Python 标准库内置的确定性性能分析器,统计每个函数的调用次数、总耗时(cumtime)与自身净耗时(tottime)。
- 无侵入采样分析(py-spy):可以在无需修改代码、不重启生产进程的前提下,直接附加到运行中的 Python 进程抓取调用栈火焰图(FlameGraph),极其适合生产偶发假死排查。
# 示例:通过 cProfile 排查计算热点代码示例
import cProfile
import pstats
import io

def heavy_computation():
    total = 0
    # 典型低效做法:大循环内的列表推导与反复查找
    for i in range(500_000):
        total += sum([x for x in range(10)])
    return total

pr = cProfile.Profile()
pr.enable()
heavy_computation()
pr.disable()

# 格式化输出耗时排名前 5 的函数
s = io.StringIO()
ps = pstats.Stats(pr, stream=s).sort_stats('tottime')
ps.print_stats(5)
print(s.getvalue())
三、构建进阶所需的软件架构能力
如果说技术深度决定了代码单点的运行质量,那么架构能力则决定了系统整体在面对业务膨胀、人员协作与故障突发时的生命周期。
1. 告别单体脚本:践行整洁分层架构
很多初级开发者编写 FastAPI 或 Django 代码时,把请求校验、业务规则校验、SQL 拼装、第三方 HTTP 调用全部堆放在 View/Controller 函数中。当业务稍有调整,修改逻辑就会破坏其他功能。
进阶的第一步是建立分层架构(Layered Architecture),将应用划分为三层边界明确的模块:
- 表现层(Presentation / API Layer):仅负责 HTTP 路由解包、参数合法性检验(如 Pydantic BaseModel)及状态码组装,绝不包含任何业务判断与 SQL 逻辑。
- 业务领域层(Service / Domain Layer):系统的核心大脑,纯粹表达业务规则(如“用户余额充足校验”、“优惠券核销逻辑”),通过抽象接口与外部持久层通信。
- 持久与基础设施层(Repository / Infrastructure Layer):屏蔽底层数据库、Redis 缓存或外部三方 API 的细节,提供标准的
get_by_id、save等契约。
# 示例:Clean Architecture 分层与依赖倒置实践
from typing import Protocol, Optional
from pydantic import BaseModel

# 1. 契约定义(Repository 抽象接口)
class UserRepository(Protocol):
    def find_by_id(self, user_id: int) -> Optional[dict]:
        ...
    def update_balance(self, user_id: int, new_balance: float) -> None:
        ...

# 2. 领域服务层(专注于纯粹业务规则)
class UserService:
    def __init__(self, repo: UserRepository):
        self._repo = repo  # 依赖注入,便于单独进行单元测试

    def deduct_balance(self, user_id: int, amount: float) -> bool:
        if amount <= 0:
            raise ValueError("扣减金额必须大于0")

        user = self._repo.find_by_id(user_id)
        if not user or user["balance"] < amount:
            return False

        new_balance = user["balance"] - amount
        self._repo.update_balance(user_id, new_balance)
        return True
2. 分布式思维:缓存、队列与数据一致性
单机系统的瓶颈通常在数据库。进阶开发者需要建立“数据访问分级”的架构思维:
- 缓存防护:使用 Redis 承载 80% 的高频读流量。必须在架构设计之初就考虑并防范缓存穿透(布隆过滤器或空值缓存)、缓存击穿(互斥锁加载)与缓存雪崩(过期时间加随机抖动)。
- 异步解耦:将耗时较长、非强依赖即时响应的操作(如邮件发送、报表生成、日志归档)剥离出主流程,投递至 Celery / Redis Streams / RabbitMQ 异步任务队列。
- 接口幂等性保障:在分布式环境下,网络超时重试是常态。无论是订单支付还是库存扣减,必须通过“业务唯一键”、“防重 Token”或数据库唯一索引确保多次提交结果一致。
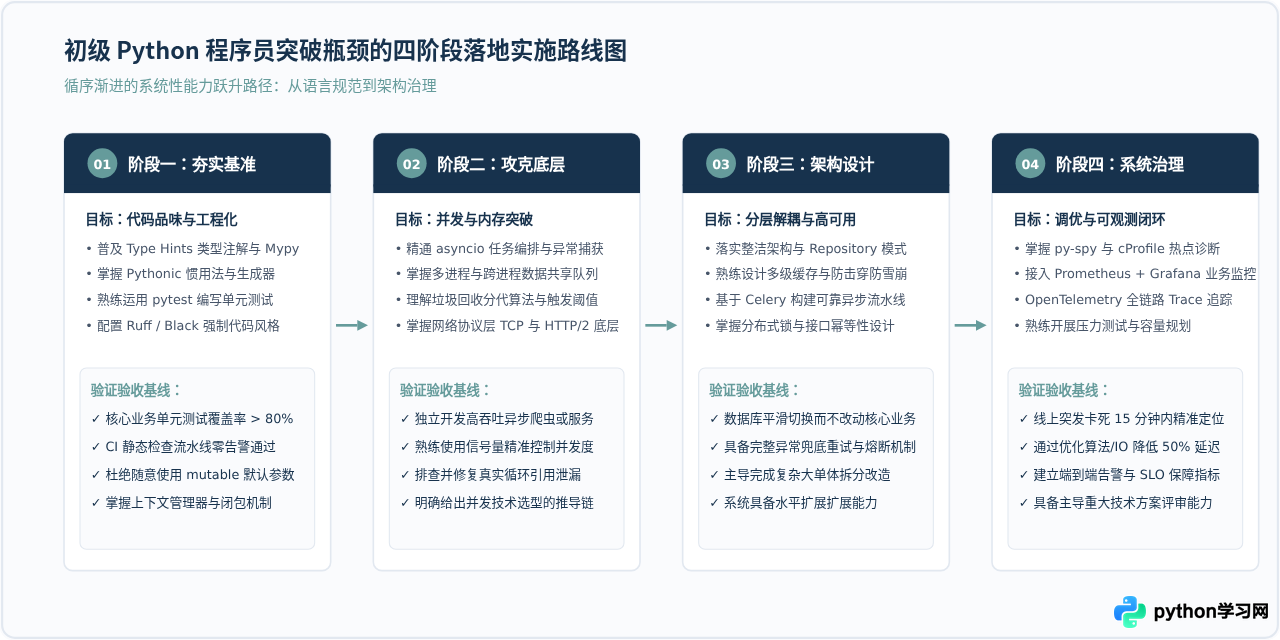
四、四阶段进阶实施路线图
突破技术瓶颈并非一蹴而就,建议初级开发者按照清晰的步骤梯次推进,每一步都有明确的检验标准。
五、进阶路上的常见误区与避坑指南
| 常见误区 | 典型错误表现 | 中高级工程师的正确做法 |
|---|---|---|
| 盲目追求新框架 | 今天学 FastAPI,明天换 Litestar,但对底层 ASGI 规范与事件循环原理一无所知。 | 掌握网络通信底层与协议(WSGI / ASGI),透视框架在路由匹配与依赖注入上的实现逻辑。 |
| 性能问题靠猜想 | 系统响应慢,在没有数据支撑的情况下随意加多线程或盲目优化微小代码片段。 | 先使用采样分析器(如 py-spy)绘制火焰图,找到耗时占比最高的核心热点后再定向重构。 |
| 缺乏单元测试 | 修改一处代码需要在整个界面或 Postman 中手动点击测试,重构成本极高。 | 核心领域逻辑必须具备单元测试,通过 Mock 隔离外部依赖,保障重构时系统行为不退化。 |
| 误用异步编程 | 在 async def 路由中直接调用 requests.get() 或同步数据库驱动,导致整个事件循环完全卡死。 |
全程使用原生异步库(如 httpx、asyncpg),若必须调用第三方同步阻塞库,务必放入 asyncio.to_thread()。 |
六、总结:构建长期可持续的架构能力全景
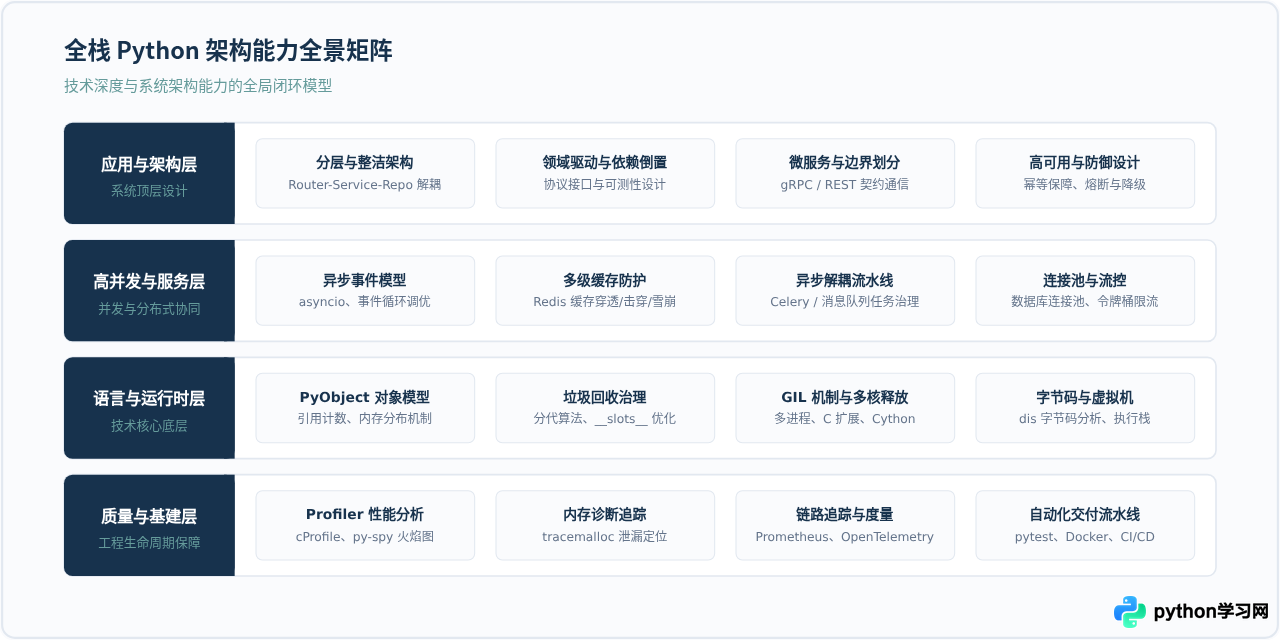
初级 Python 程序员的进阶之路,不是单纯背诵语法特性,而是一场从“局限于代码语法”到“纵观系统全貌”的认知升级。技术深度让你看透代码在内存与 CPU 中的实际代价,而架构能力则让你在错综复杂的业务演进中构建出健壮、优雅且可维护的高可用系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















