


Python元组和集合的定义、创建及基本特性

在 Python 的内置容器类型中,元组(Tuple)与集合(Set)是两种设计目标鲜明但常被初学者混淆的数据结构。简单来说,元组是有序、不可变的序列容器,适用于保存不可被篡改的结构化记录;而集合是无序、元素唯一且可变的容器,专门用于去重、高频成员资格检索以及集合代数运算。理解两者的定义方式、底层机制与特性差异,是写出健壮且高效 Python 代码的基础。
一、元组(Tuple)的定义与创建
元组是 Python 的内置序列类型之一。在物理存储与逻辑组织上,元组内部保留元素的插入顺序,支持通过正向或反向数字索引访问元素,同时允许存放任意类型的对象及重复值。与列表(List)最根本的区别在于:元组一旦创建,其长度与内部引用的元素便不能被新增、删除或替换。
1. 常见创建语法与单元素逗号规则
创建元组主要有以下几种常见方式:
- 圆括号字面量:使用半角圆括号将多个元素包裹并用逗号隔开,例如
t = (1, 2, 3)。 - 逗号打包(省略括号):在 Python 中,逗号才是构造元组的核心符号。即使没有圆括号,
t = 1, 2, 3同样会被解析为元组。 - 单元素元组的逗号要求:如果仅包含一个元素,必须在元素末尾添加逗号。例如
t = (42,)或t = 42,。若缺少逗号写成t = (42),括号仅会被解释为普通的数学运算优先级括号,t最终只是整数42而非元组。 - 内置构造函数
tuple():将其他可迭代对象(如列表、字符串、字典键等)转换为元组,例如tuple([10, 20])返回(10, 20)。 - 空元组:直接使用空括号
t = ()或t = tuple()。
# 常见元组创建示例
empty_t = ()                        # 空元组
normal_t = (10, "Python", 3.14)      # 多元素元组
packed_t = 100, 200, 300            # 省略括号的元组打包
single_correct = (42,)              # 正确的单元素元组,类型为 tuple
single_wrong = (42)                 # 错误示范:类型为 int

from_list = tuple(["a", "b", "c"])   # 输出: ('a', 'b', 'c')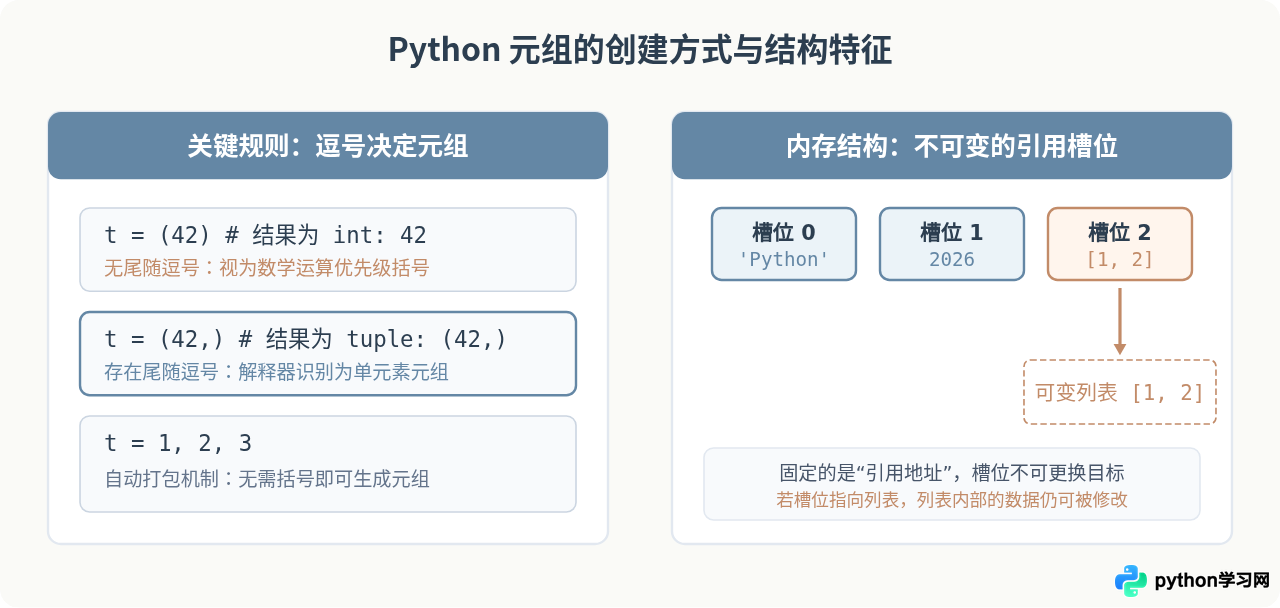
二、元组的核心特性与使用场景
元组在日常开发中的价值并非仅仅是“只读的列表”,它在内存优化、语义清晰度及数据安全性方面都有独特的地位。
1. 核心特性解析
- 不可变性(Immutability):元组一旦分配,不能调用如
append()、pop()或extend()这类修改自身结构的原地方法。如果试图为元组的某个索引赋值(例如t[0] = 99),解释器会立即抛出TypeError: 'tuple' object does not support item assignment。 - 有序性与支持切片:元素保持固定排列次序。支持通过正负索引直接寻址(例如
t[0]、t[-1]),支持步长切片(例如t[1:3])。 - 浅层不可变与深层内容:元组的不可变性约束的是其内部各个槽位所保存的对象引用(内存地址)。如果元组内部某个元素本身是可变对象(如列表),那么该列表内部的增删改是允许的,但元组本身不能更换引用到另一个列表。
- 可哈希性(Hashable):若一个元组所包含的所有元素都是不可变(可哈希)类型,则该元组本身是可哈希的,计算出的哈希值终生不变。这意味着元组可以作为字典的键(Key)或集合的元素,而列表绝对不行。
2. 典型使用场景
在实际工程中,元组主要用于以下三个典型场景:
- 函数返回多值与序列解包:Python 函数在
return a, b时,本质上是将多个返回值打包为一个元组,接收端可通过x, y = get_coords()快速解包。 - 只读配置与常数集合:用于保存坐标、RGB 颜色值、数据库主机与端口等不希望被程序运行期意外修改的固定维度记录。
- 字典复合键:在表格映射或空间几何计算中,需要将二维网格坐标
(x, y)或多字段组合作为查询索引时,元组是天然合法的键类型。
三、集合(Set)的定义与创建
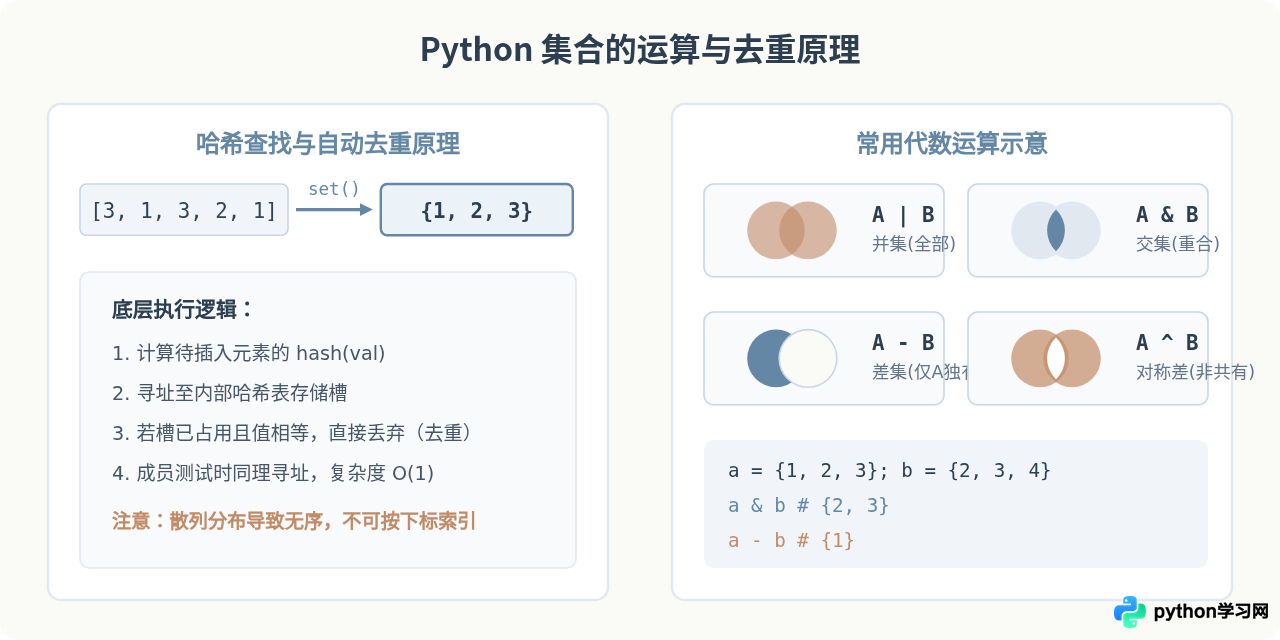
集合是 Python 的内置无序集合类型,其底层完全基于哈希表(Hash Table)结构构建。集合具有两大基本属性:元素互不重复(唯一性)与无序性。与数学中的集合概念一致,集合主要用于去重以及进行交集、并集、差集等数学运算。
1. 集合的创建方式与空集合陷阱
创建集合通常使用以下语法:
- 大括号字面量:直接使用花括号列出元素,例如
s = {1, 2, 3}。如果在大括号中提供了重复元素,Python 会自动剔除重复项,只保留一份。 - 空集合的定义(重点避坑):在 Python 中,一对空花括号
{}默认用于创建空字典(dict),而非空集合。创建空集合必须调用内置构造器:s = set()。 - 内置构造器
set()转换:传入任意可迭代对象,自动完成遍历去重。例如set([1, 2, 2, 3])会返回{1, 2, 3};set("hello")会得到包含{'h', 'e', 'l', 'o'}的字符集合。
# 集合创建与去重示例
num_set = {10, 20, 30, 20, 10}       # 自动去重,结果为 {10, 20, 30}
empty_dict = {}                      # 陷阱:这是字典,type 为 dict
empty_set = set()                    # 正确的空集合创建方式,type 为 set

# 快速从列表中剔除重复项
raw_ids = [101, 102, 101, 105, 102]
unique_ids = list(set(raw_ids)) # 获得去重后的列表 [101, 102, 105](注意:顺序可能被打乱)注意:集合的元素必须是可哈希(Hashable)对象。数字、字符串、元组可以放入集合;但列表(list)、字典(dict)或集合本身(set)因为是可变对象,无法计算稳定哈希值,放入集合会直接引发 TypeError: unhashable type: 'list'。若需要嵌套集合,可以使用不可变集合 frozenset。
四、集合的核心特性与代数运算
集合的底层哈希表机制赋予了它极高的数据处理效率与独特的代数运算能力。
1. 核心特性解析
- 无序性与不支持索引:集合内部元素按照哈希值散列分布,没有类似列表的固定位置下标。执行
s[0]会直接报错TypeError: 'set' object is not subscriptable。在遍历集合时,元素的输出顺序也是不确定的。 - 常数级成员检测($O(1)$ 查找):在包含 100 万个元素的列表中执行
x in list_data需要逐个遍历(时间复杂度为 $O(n)$);而在集合中执行x in set_data只需计算x的哈希值并定位存储桶,平均时间复杂度仅为 $O(1)$。因此对于高频查重过滤,集合具有压倒性的性能优势。 - 元素自去重:无论添加多少次相同的元素,集合始终保证元素仅出现一次。
2. 四大经典代数运算
Python 集合原生支持数学集合论中的各种代数操作,既可以使用直观的运算符,也可以调用等效的方法:
- 交集(Intersection):提取两个集合均包含的公共元素。运算符为
&,方法为s1.intersection(s2)。 - 并集(Union):合并两个集合的所有元素并去除重复项。运算符为
|,方法为s1.union(s2)。 - 差集(Difference):存在于前者但不存在于后者的元素。运算符为
-,方法为s1.difference(s2)。 - 对称差集(Symmetric Difference):包含仅属于其中一个集合的元素,排除公共部分。运算符为
^,方法为s1.symmetric_difference(s2)。
五、元组与集合的特性对比与选型指南
元组和集合在数据模型上有着根本性的差异。面对具体业务需求时,可参考以下多维对比与决策流程进行选型。
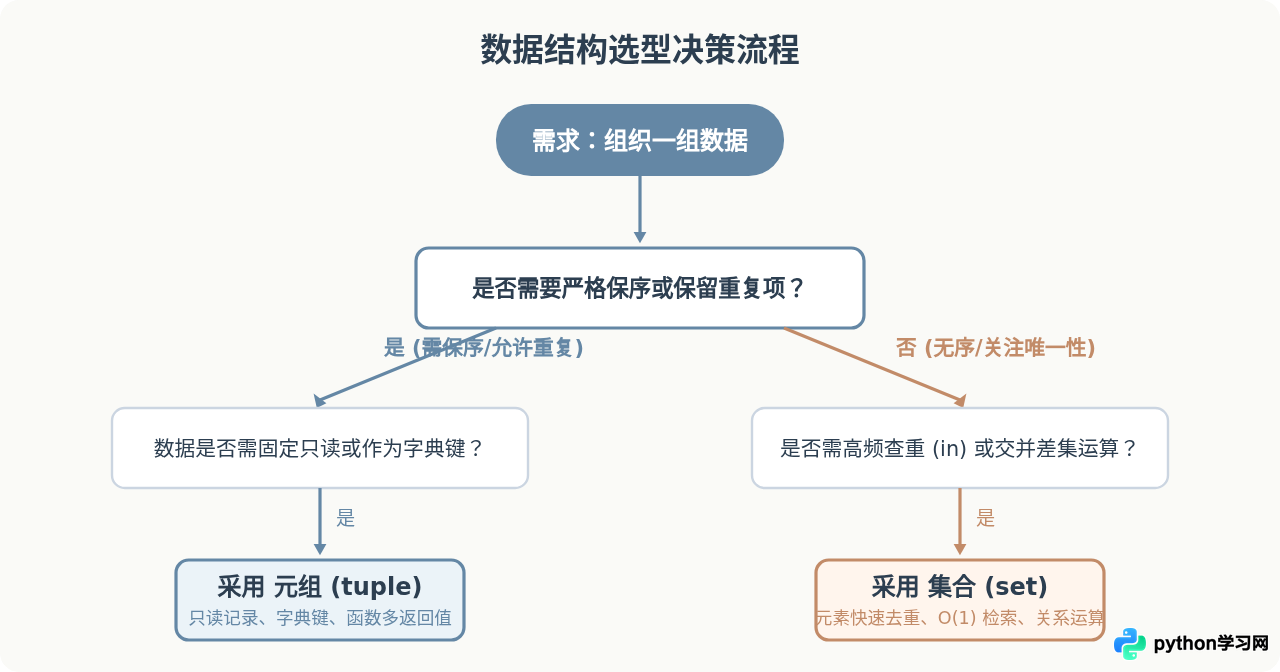
综合两者的核心特征,具体选型考量如下:
- 使用元组的情况:
- 需要表达一个具有固定格式的记录实体(例如经纬度坐标
(116.40, 39.90)或 RGB 颜色(255, 0, 128))。 - 必须防止数据在后续函数传递调用过程中被其他模块意外修改。
- 需要将组合字段当作字典的键使用。
- 需要表达一个具有固定格式的记录实体(例如经纬度坐标
- 使用集合的情况:
- 数据源存在大量重复值,且业务要求仅提取唯一的元素集合。
- 需要高频执行
val in container判断(例如敏感词词库过滤、黑白名单匹配),对查询延迟有严苛要求。 - 需要比对两组用户、权限或标签的交叉与差异(求共同好友、求新增权限列表)。
六、常见易错点与避坑指南
在日常使用中,以下几个语法与运行期陷阱最为高发:
1. 单元素元组遗漏尾随逗号
这是 Python 最容易被忽略的语法细节之一。当书写 data = ("admin") 时,data 的类型为字符串 str;若随后调用 len(data) 或进行遍历,代码仍能运行但逻辑已完全脱轨。正确做法:凡是构造单元素元组,始终带上末尾逗号,写成 ("admin",)。
2. 误用 {} 声明空集合
由于集合使用花括号包裹字面量,很多人下意识地写出 s = {}。但在 Python 语法设计中,空字典拥有更高的语法优先级,{} 得到的是字典。如果在其上调用 s.add(10),会抛出 AttributeError: 'dict' object has no attribute 'add'。正确做法:空集合必须使用 set() 进行初始化。
3. 在集合中添加不可哈希的可变对象
如果尝试将列表或字典塞入集合,例如 s.add([1, 2]),会立即触发 TypeError: unhashable type: 'list'。正确做法:如果需要将复合子序列放入集合,应先将其转换为元组,写成 s.add((1, 2))。
4. 遍历集合的同时直接修改集合大小
集合在遍历时依赖内部哈希表的桶状态。如果在 for item in s: 循环体内直接执行 s.remove(item) 或 s.add(new_item),会引发 RuntimeError: Set changed size during iteration。正确做法:复制一份集合副本进行迭代(如 for item in s.copy():),或者通过集合推导式生成新集合。
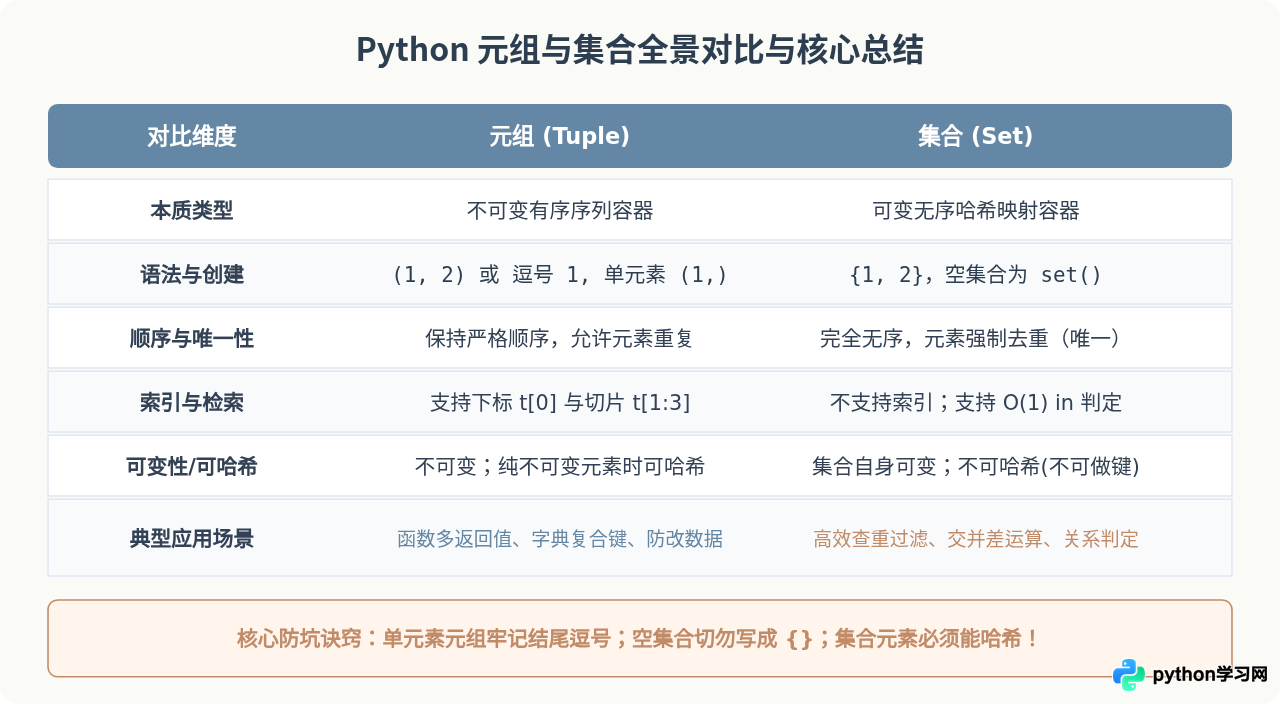
综上所述,元组与集合分别代表了 Python 处理“固定有序记录”与“离散唯一集合”的两种核心哲学。掌握了不可变引用、单元素逗号、哈希表查找与代数运算的基本机制,便能在各类复杂业务中准确选取最合适的数据结构,写出高效、规范且富有表现力的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















